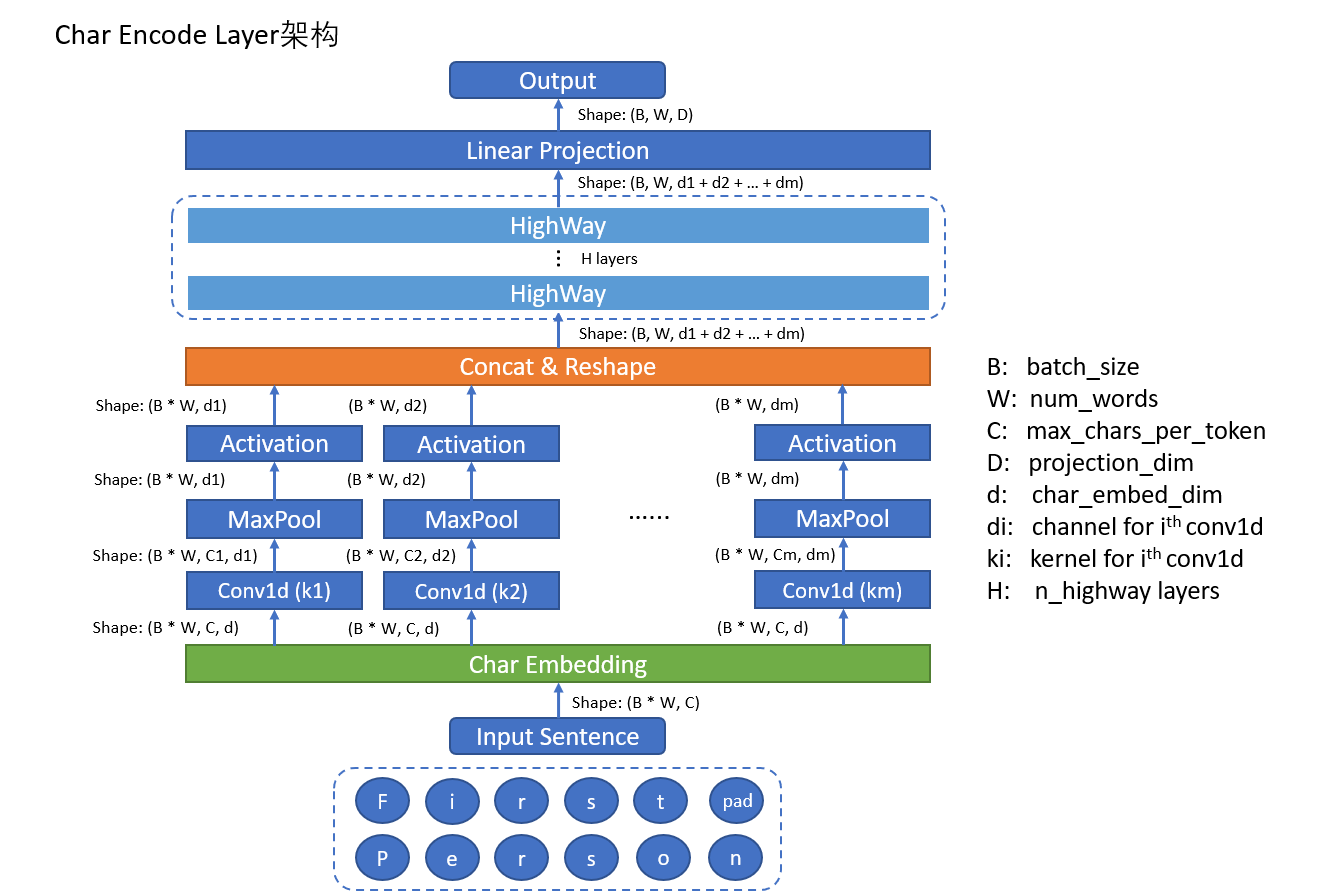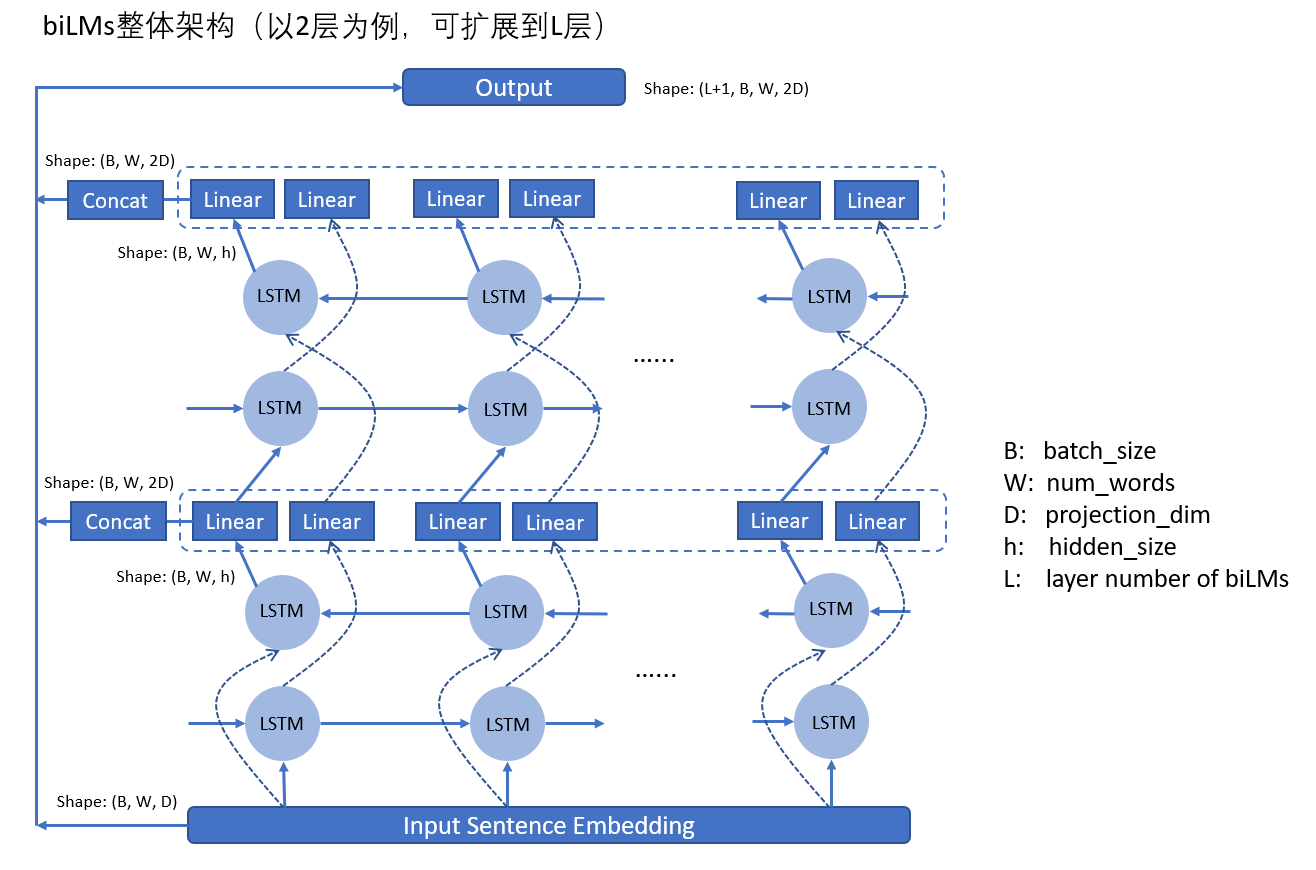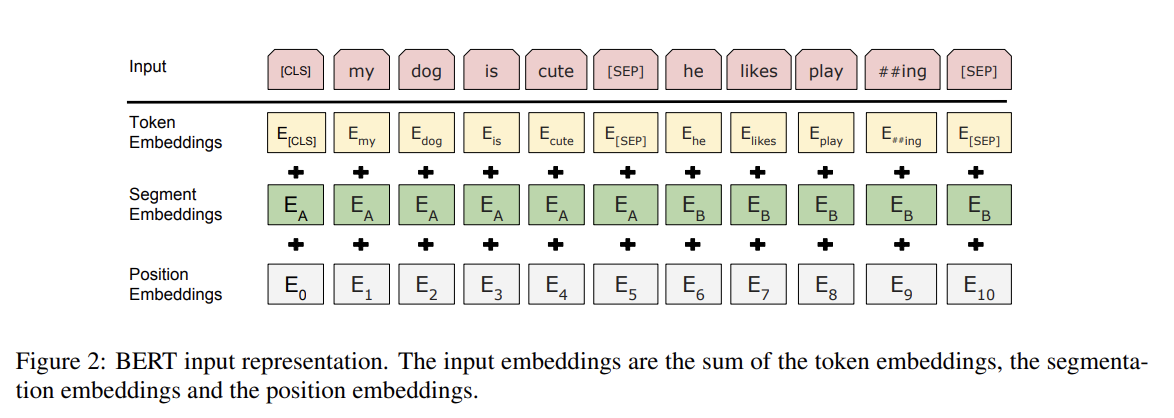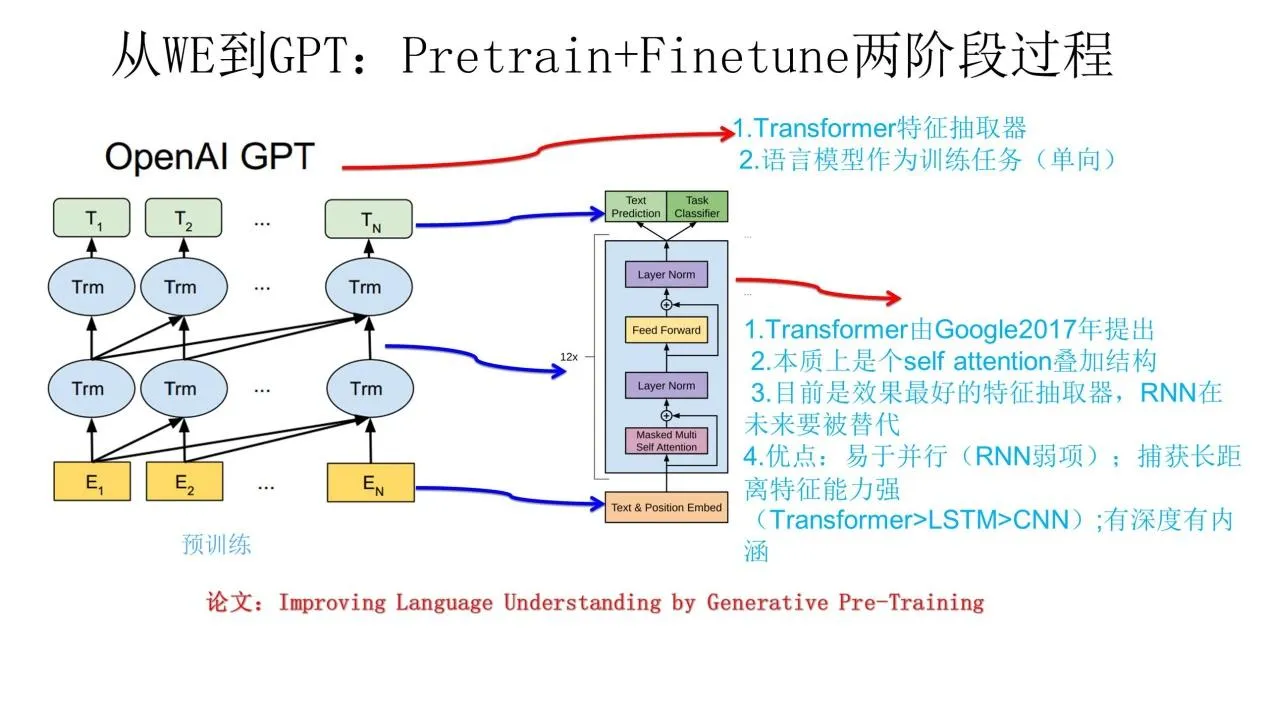
# 前言

![](https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-8269766c281431b82a1d2afedc7f53457ca0887f%2FGemini_Generated_Image_nvoawnnvoawnnvoa.png?alt=media)

## LLM-Everything

**从零开始，系统掌握大语言模型的一切。**

[![GitBook](https://img.shields.io/static/v1?message=Documented%20on%20GitBook\&logo=gitbook\&logoColor=ffffff\&label=%20\&labelColor=5c5c5c\&color=3F89A1)](https://chenzihong.gitbook.io/llm-everything) [![知乎](https://img.shields.io/static/v1?message=%E7%9F%A5%E4%B9%8E%E4%B8%93%E6%A0%8F\&logo=zhihu\&logoColor=ffffff\&label=%20\&labelColor=5c5c5c\&color=0084FF)](https://www.zhihu.com/column/c_1931824303218885390)

***

### ✨ 为什么是这个项目？

市面上不缺 LLM 教程，但缺的是**真正讲明白**的。

* 🎯 **不复制粘贴** — 每篇文章精心打磨，用生动的方式拆解复杂概念
* 🔨 **从零实现代码** — 不只讲理论，带你亲手写出来，在实战中理解原理
* 🗺️ **体系化路线** — 从基础到前沿，完整的学习路径，不再迷路

***

### 📚 知识地图

#### 🎚️ 基础部分

**🐍 Python 基础**

* [logging 模块](/llm-everything/basics/python-basics/logging)
* [import 模块](/llm-everything/basics/python-basics/import)
* [multiprocessing 模块](/llm-everything/basics/python-basics/multiprocessing)

**🐘 机器学习基础**

* 文本表示模型
  * [Bag-of-Words](/llm-everything/basics/machine-learning-basics/feature-extraction/text-representation-models/bag-of-words)
  * [Topic Model](/llm-everything/basics/machine-learning-basics/feature-extraction/text-representation-models/topic-model)
  * [Static Word Embeddings](/llm-everything/basics/machine-learning-basics/feature-extraction/text-representation-models/static-word-embeddings)

**🪿 深度学习基础**

* 🚧 持续更新中...

**🐬 LLM 基础**

* [思考模式切换](/llm-everything/basics/llm-basics/switch-thinking)
* [为什么现在的LLM都是decoder-only架构](/llm-everything/basics/llm-basics/why-decoder-only)

#### 🐬 Prompt Engineering

* [Tree of Thoughts](/llm-everything/prompt-engineering/tree-of-thoughts)

#### 🦖 Transformer 架构

> 逐模块拆解 Transformer

* [Tokenizer](/llm-everything/transformer/tokenizer)
* [Embeddings](/llm-everything/transformer/embeddings)
  * [ELMo](/llm-everything/transformer/embeddings/elmo)&#x20;
  * [BERT](/llm-everything/transformer/embeddings/bert)
  * [GPT](/llm-everything/transformer/embeddings/gpt)
* [Positional Encoding](/llm-everything/transformer/positional-encoding)
* [Self Attention](/llm-everything/transformer/self-attention)
* [Multi-Head Attention](/llm-everything/transformer/multi-head-attention)
* [Add & Norm](/llm-everything/transformer/add-and-norm)
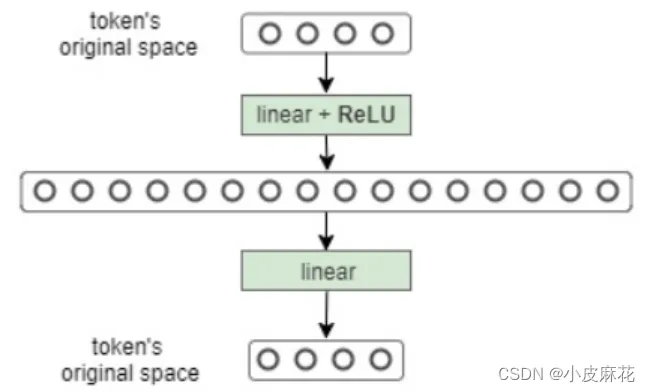
* [FeedForward](/llm-everything/transformer/feedforward)
* [Linear & Softmax](/llm-everything/transformer/linear-and-softmax)
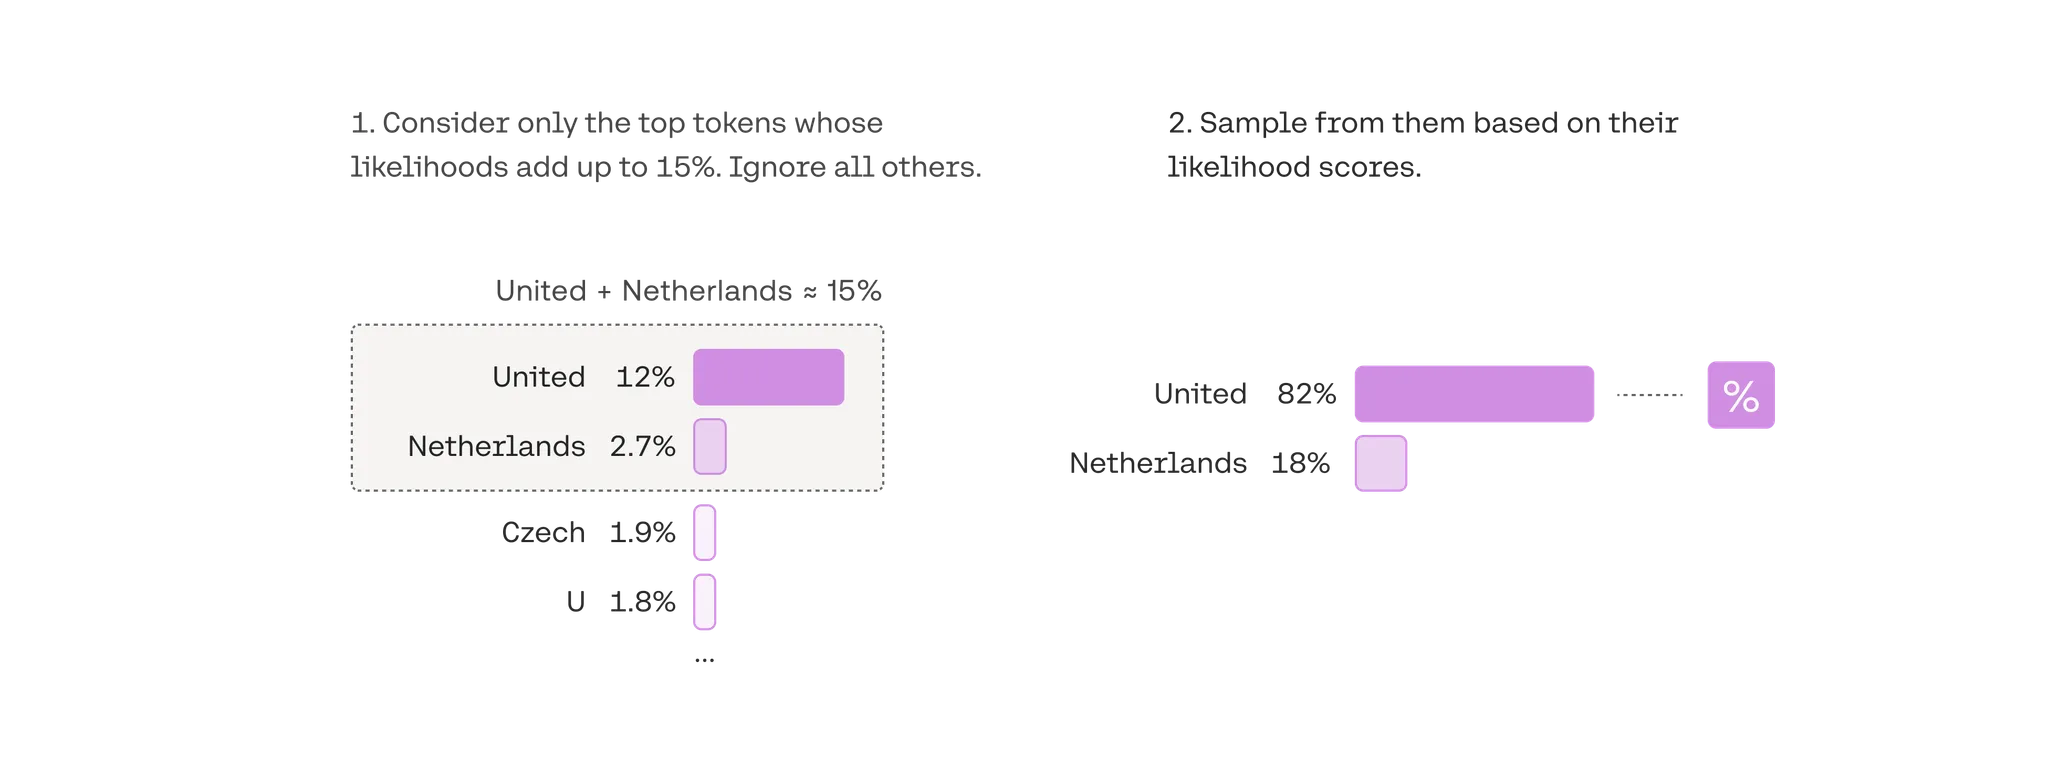
* [Decoding Strategy](/llm-everything/transformer/decoding-strategy)

#### 🎄 LLM 训练

**显存需求**

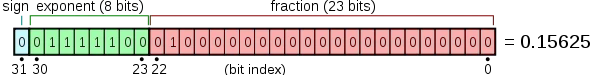
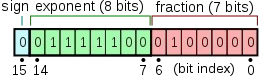
* [LLM 精度问题](/llm-everything/train/llm-vram-needs/llm-precision)
* [训练需要多少显存](/llm-everything/train/llm-vram-needs/vram_needs_for_llm_training)

**分布式并行**

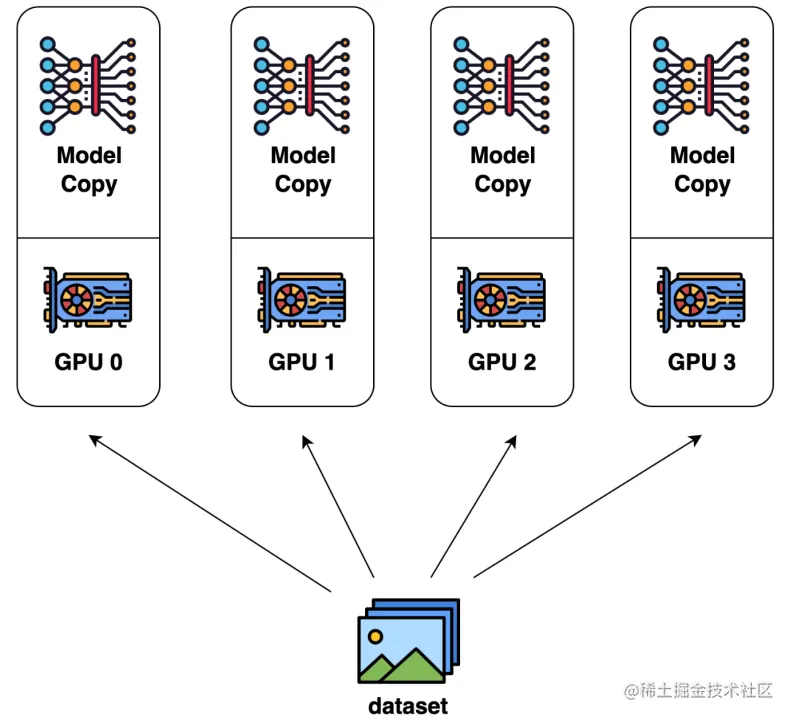
* [数据并行](/llm-everything/train/distributed-training-parallelism/data-parallelism)&#x20;
* [模型并行](/llm-everything/train/distributed-training-parallelism/model-parallelism)&#x20;
* [优化器并行](/llm-everything/train/distributed-training-parallelism/optimizer-parallelism)
* [异构系统并行](/llm-everything/train/distributed-training-parallelism/heterogeneous-system-parallelism)

**训练流程**

* **数据准备**
  * [课程学习](/llm-everything/train/data-preparation/curriculum-learning)
* [预训练](/llm-everything/train/pre-train)
  * [数据工程](/llm-everything/train/pre-train/data-engineering)
  * [超参配置](/llm-everything/train/pre-train/hyper-param)
  * [长文本拓展](/llm-everything/train/pre-train/long-text-extension)
  * [评估](/llm-everything/train/pre-train/evaluation_and_engineering)
* [监督微调](/llm-everything/train/sft)
  * [数据工程](/llm-everything/train/sft/data_engineering)
  * [参数高效微调](/llm-everything/train/sft/peft)
  * [训练策略与稳定性](/llm-everything/train/sft/training-strategy)
  * [评估](/llm-everything/train/sft/evaluation)
* [强化学习](/llm-everything/train/reinforce-learning)
  * [RLHF基础 & PPO](/llm-everything/train/reinforce-learning/rlhf-basics-and-ppo)
  * [DPO](/llm-everything/train/reinforce-learning/dpo)
  * [GRPO](/llm-everything/train/reinforce-learning/grpo)
  * [DAPO](/llm-everything/train/reinforce-learning/dapo)
  * [RLVR](/llm-everything/train/reinforce-learning/rlvr)

#### 🐒 MoE（混合专家模型）

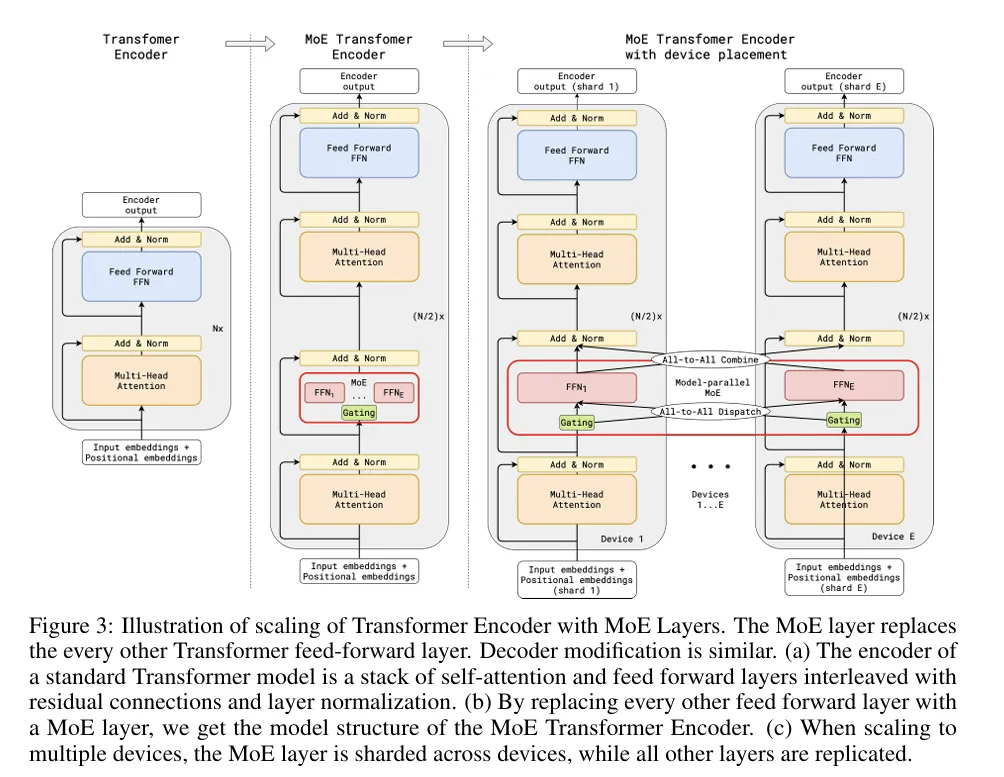
* [专家并行](/llm-everything/moe/expert-parallelism)

#### 🪿 LLM 应用

* [信息检索](/llm-everything/llm-application/info-retrieval)
  * [相似度度量](/llm-everything/llm-application/info-retrieval/similarity)
  * [文本表示方法](/llm-everything/llm-application/info-retrieval/text-representation)
  * [词向量](/llm-everything/llm-application/info-retrieval/word-vector)
  * [跨模态相似度](/llm-everything/llm-application/info-retrieval/cross-modal-similarity)
  * [大规模向量检索](/llm-everything/llm-application/info-retrieval/large-scale-retrieval)
* [RAG](/llm-everything/llm-application/rag)
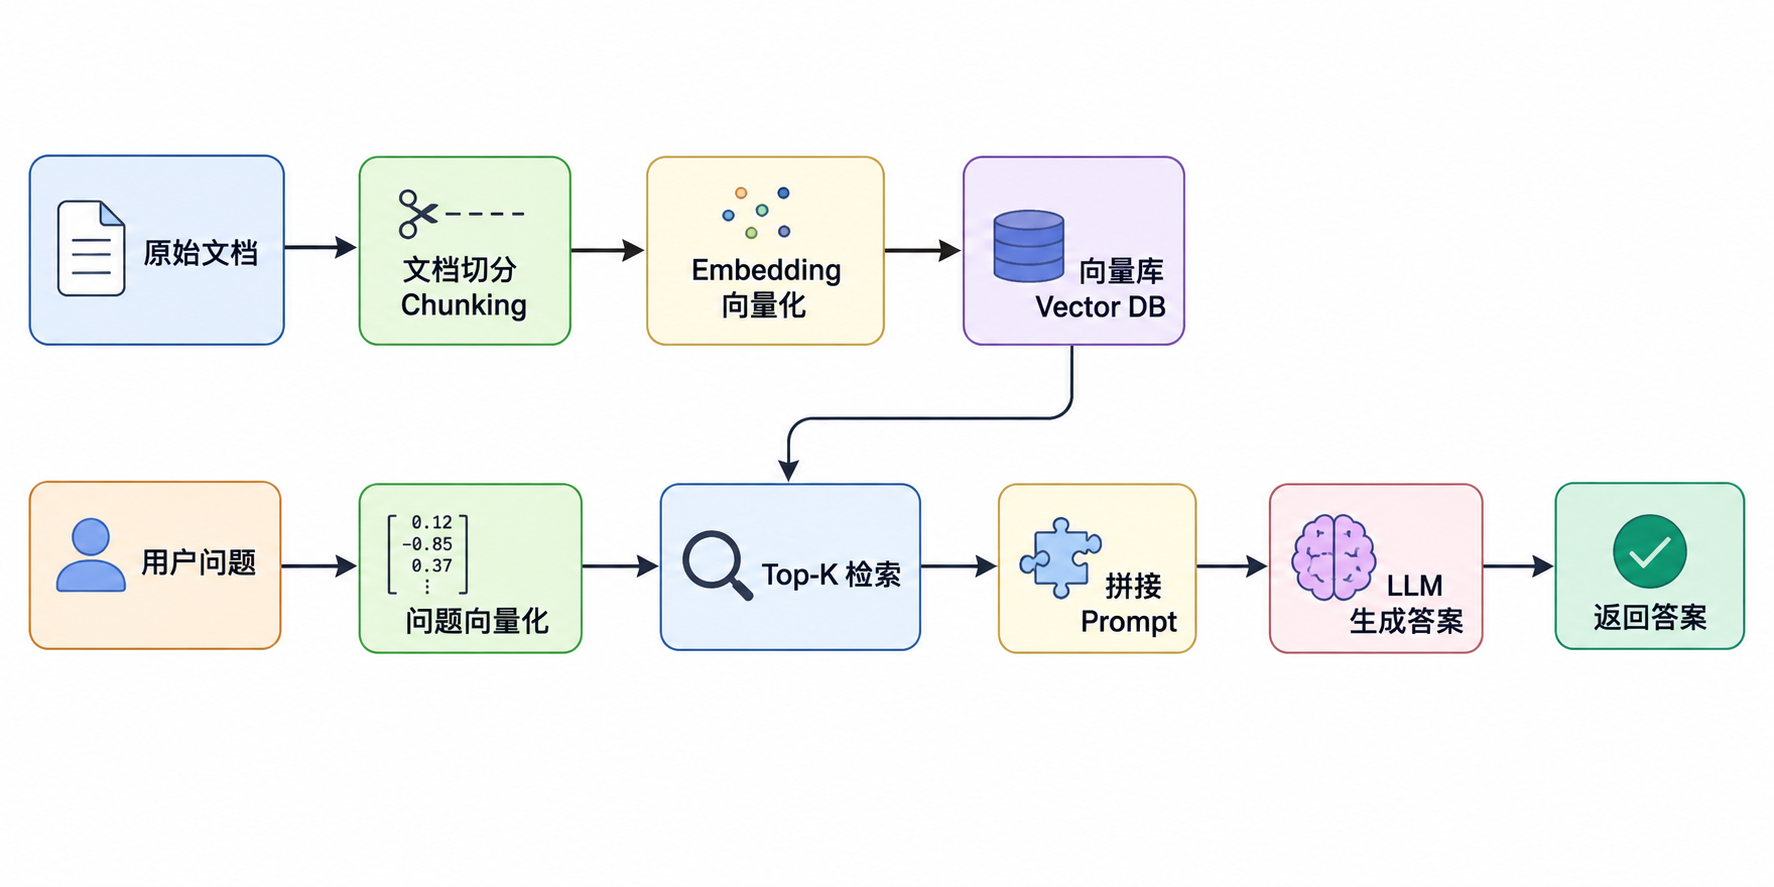
  * [RAG 完整链路](/llm-everything/llm-application/rag/end-to-end-rag-pipeline)
  * [Agentic RAG](/llm-everything/llm-application/rag/agentic-rag)
  * [Graph RAG](/llm-everything/llm-application/rag/graph-rag)
* [AutoResearch](/llm-everything/llm-application/autoresearch)
* [Agent Memory](/llm-everything/llm-application/agent-memory)

#### 🐢 多模态大模型

* 多模态大模型基础
* 核心组件
  * 视觉编码器
  * 模态连接器
    * [QFormer](/llm-everything/multi-modal-llm/components/connector/qformer)
  * 视觉分词器
* 工程实现
  * 最常用的数据集格式—— [WebDataset](/llm-everything/multi-modal-llm/engineering/webdataset)

#### 🦔 LLM Infra

* [K8s](/llm-everything/llm-infra/k8s)
  * [Kubernetes 自动扩缩容的三种玩法：HPA、VPA 和 KEDA](/llm-everything/llm-infra/k8s/auto-scale)
* [AI for data infra](/llm-everything/llm-infra/ai-for-data-infra)

***

### 🤝 参与贡献

本项目正在快速迭代中，欢迎：

* 🐛 提 Issue 指出错误或疑问
* 🔀 提 PR 补充内容
* ⭐ 觉得有用就给个 Star，这是最大的鼓励

***

**如果这个项目帮到了你，请点个 ⭐ Star 支持一下！**


# 基础部分


# Python基础


# logging模块

### **1 从结绳记事到日志**

在远古时代，人类使用**结绳记事**记录重要事件——绳结的大小、位置和颜色代表不同含义。随着文明发展，我们有了纸笔、印刷术，直到今天的电子日志系统。

Python的`logging`模块就是数字时代的"结绳记事"，帮助开发者记录程序运行的关键信息。

### 2 为什么需要日志

日志和保险一样，系统没有问题时没有存在感，出了问题后承担“行车记录仪”的功能。

日志记录应用程序和基础设施运行中的**每一个关键事件、操作和消息**，包括所发生事件的描述、相关时间戳、与事件相关的严重性级别类型以及其他相关元数据。日志对于调试问题、诊断错误和审核系统活动非常有用。它们提供了系统事件的文本叙述，使人们更容易理解所采取的操作顺序。

### 3 Python日志模块概述

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-0a4d9691f45a44d07436291aa7c514536d50d4fe%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

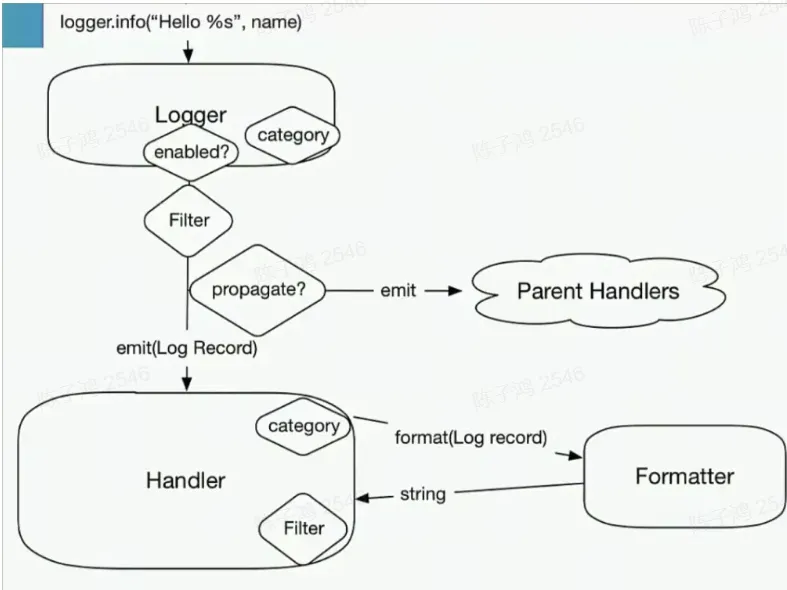
Python 的 **`logging`** 模块通过**层级化的日志器（Logger）**、**处理器（Handler）**、**过滤器（Filter）** 和 **格式化器（Formatter）** 实现灵活的日志管理。

* Logger

  日志级别：**`DEBUG`** < **`INFO`** < **`WARNING`** < **`ERROR`** < **`CRITICAL`**，日志仅当级别≥日志器级别时才会处理。
* Filter
  * **精细化控制：**&#x57FA;于日志内容（如级别、消息文本、模块名）决定是否处理日志。
  * 绑定位置：可附加到日志器（全局过滤）或处理器（目标特定过滤）。
* Handler

  负责将日志传递到不同目标：

  * **控制台处理器**：**`logging.StreamHandler`**（输出到 **`sys.stdout/stderr`**）。
  * **文件处理器**：**`logging.FileHandler`**（写入文件）、**`RotatingFileHandler`**（滚动文件）。
  * **其他处理器**：如 **`SMTPHandler`**（邮件）、**`SocketHandler`**（网络）等。
  * **多处理器支持**：一个日志器可绑定多个处理器（如同时输出到控制台和文件）。
* Formatter

  * 将日志记录（**`LogRecord`**）转换为字符串（如添加时间、模块名）

  <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FFgXCT7ZKt0VrUH8Yah0H%2Fimage.png?alt=media&amp;token=63f633c5-1682-4957-8e1d-9aec19f32d4c" alt=""><figcaption></figcaption></figure>

### 4 日志使用常见错误

#### 4.1 没有log或者少打log

解决方案：用装饰器简化代码。

例如我们有三个函数， `add` 、 `mul` 、 `div`

如果我们需要记录函数的入口参数、返回结果和异常信息，以往需要在每个函数中重复编写日志代码，显得冗余且费力。

以下是优化后的实现：

```python
import logging

logging.basicConfig(level=logging.DEBUG, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
logger = logging.getLogger(__name__)

from functools import wraps

def log_enter_exit(fn):
    @wraps(fn)
    def __wrapped(*args, **kwargs):
        logger.debug("enter %s: %s %s", fn.__name__, args, kwargs)
        try:
            ret = fn(*args, **kwargs)
            logger.debug("exit result: %s", ret)
            return ret
        except Exception as ex:
            logger.debug("exit got error: %s", ex, exc_info=True)
            raise ex
    return __wrapped

@log_enter_exit
def add(v1, v2):
    return v1 + v2

@log_enter_exit
def mul(v1, v2):
    return v1 * v2

@log_enter_exit
def div(v1, v2):
    return v1 / v2

add(1, 2)
mul(3, 4)
div(10, 0)
```

* 通过装饰器封装日志记录代码，消除每个函数中的重复日志语句
* 自动记录函数名、参数、返回值和异常信息

输出示例：

```python
2023-10-05 12:00:00 - __main__ - DEBUG - Enter add: args=(1, 2), kwargs={}
2023-10-05 12:00:00 - __main__ - DEBUG - Exit add: Result=3
2023-10-05 12:00:00 - __main__ - DEBUG - Enter mul: args=(3, 4), kwargs={}
2023-10-05 12:00:00 - __main__ - DEBUG - Exit mul: Result=12
2023-10-05 12:00:00 - __main__ - DEBUG - Enter div: args=(10, 0), kwargs={}
2023-10-05 12:00:00 - __main__ - DEBUG - Exit div with error: division by zero
Traceback (most recent call last):
  File "...", line 15, in wrapper
    ret = fn(*args, **kwargs)
  File "...", line 35, in div
    return v1 / v2
ZeroDivisionError: division by zero
```

#### 4.2 log信息不全

1. 缺少上下文信息

   解决方案：使用LogAdapter简化操作

   有时打印log时容易信息不全，容易混淆两个类的信息，例如：

   ```python
   import logging

   class A:
       def __init__(self, name):
           self.name = name

       def eat(self, food):
           logging.info(f"Eating {food}")

   class B:
       def __init__(self, name):
           self.name = name

       def eat(self, food):
           logging.info(f"Eating {food}")

   a = A("name1")
   b = B("name2")
   a.eat("apple")
   b.eat("apple")
   ```

   log后的信息都是 `Eating apple` ，同时，如果类的属性有删减，也需要一个一个修改logging的代码，非常麻烦。

   这时可以使用log的extra来简化操作，代码如下：

   ```python

   import logging
   logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(my_name)s - %(my_class)s - %(message)s')

   class A:
       def __init__(self, name):
           self.name = name
           self.extra = {
               'my_class': self.__class__.__name__,
               'my_name': self.name
           }

       def eat(self, food):
           logging.info(f"Eating {food}", extra=self.extra)

   a = A("name1")
   a.eat("apple")
   ```

   extra的内容也可以在logging模块中全局配置：

   ```python
   import logging
   import sys

   # 引用extra
   fmt = logging.Formatter("%(asctime)s - %(name)s - %(ip)s - %(username)s - %(message)s")

   h_console = logging.StreamHandler(sys.stdout)
   h_console.setFormatter(fmt)
   init_logger = logging.getLogger("myPro")
   init_logger.setLevel(logging.DEBUG)
   init_logger.addHandler(h_console)

   extra_dict = {"ip": "1.2.3.4", "username": "Jack"}

   logger = logging.LoggerAdapter(init_logger, extra_dict)

   # 不需要写代码即可自动输出extra
   logger.info("test1!")

   # 也可以覆盖
   logger.info("test2!", extra={"ip": "113.208.78.29", "username": "Petter"})

   # 直接修改context
   logger.extra = {"ip": "113.208.78.29", "username": "Petter"}
   logger.info("test3")

   ```

   输出示例：

   ```python
   2025-06-14 17:33:04,232 - myPro - 1.2.3.4 - Jack - test1!
   2025-06-14 17:33:04,232 - myPro - 1.2.3.4 - Jack - test2!
   2025-06-14 17:33:04,233 - myPro - 113.208.78.29 - Petter - test3
   ```
2. 报错缺少堆栈信息

   解决方案：设置 `exc_info=True` ，代码示例如下：

   ```python
   import logging

   logging.basicConfig(
       level=logging.ERROR,
       format='%(asctime)s - %(levelname)s - %(message)s\\n%(exc_info)s',
       datefmt='%Y-%m-%d %H:%M:%S'
   )
   logger = logging.getLogger()

   def risky_operation():
       return 1 / 0

   try:
       risky_operation()
   except Exception as ex:
       logger.error(f"操作失败: {ex}", exc_info=True)

   ```
3. 需要临时更换context

   解决方案：实现LoggingContext类，临时改变log的行为（monkey patch）

   ```python
   import logging

   logging.basicConfig(level=logging.ERROR, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
   logger = logging.getLogger(__name__)

   class LoggingContext(object):
       def __init__(self, logger, level=None, handler=None, close=True):
           self.logger = logger
           self.level = level
           self.handler = handler
           self.close = close

       def __enter__(self):
           if self.level is not None:
               self.old_level = self.logger.level
               self.logger.setLevel(self.level)
           if self.handler:
               self.logger.addHandler(self.handler)

       def __exit__(self, et, ev, tb):
           if self.level is not None:
               self.logger.setLevel(self.old_level)
           if self.handler:
               self.logger.removeHandler(self.handler)
           if self.handler and self.close:
               self.handler.close()

   # info级别不打印
   def process_data1(s1):
       logger.info("entering process_data1")
       for x in s1:
           logger.info("processing1: %s", x)

   # 重要INFO打印
   def process_data2(s1):
       logger.info("entering process_data2")
       for x in s1:
           with LoggingContext(logger, level=logging.INFO):
               logger.info("processing2: %s", x)

   process_data1("abc")
   process_data2("abc")

   ```

#### 4.3 level不合适导致磁盘占满

解决方案：可以使用 `RotatingHandler` 或者 `TimeRotatingHandler`

#### 4.4 logging浪费过多CPU资源

解决方案：注意log的风格

Python logging 的[官方文档](https://docs.python.org/3/howto/logging.html#optimization)明确建议使用占位符格式：

> "将变量作为参数传递给日志记录方法，而非自行格式化字符串。"

* 当使用 **`%`** 或 **`{}`** 占位符 + 参数传递时，**仅在日志实际需要输出时**（如当前日志级别≥设置的级别）才会进行字符串格式化。
* 而 **`.format()`** 或 f-string 会**立即执行格式化**，即使日志被过滤（例如当前级别为 **`ERROR`**，但调用的是 **`INFO`** 日志）。
* **节省资源**：在高并发或频繁记录低级别日志（如 **`DEBUG`**）时，避免不必要的字符串操作。

下面是代码示例：

```python
import logging

logging.basicConfig(level=logging.ERROR, format='%(asctime)s - %(name)s - %(levelname)s - %(message)s')
logger = logging.getLogger(__name__)

# 两种风格
logger.info("processing: {0}".format(100))
logger.info("processing: %s", 100)  # 建议，当格式化字符串比较复杂时
```

### 5 总结

从远古的绳结到现代的日志系统，记录的核心目的从未改变——**保存重要信息，传递关键知识**。Python的`logging`模块提供了强大而灵活的日志解决方案，是每个Python开发者必须掌握的核心技能之一。

### 参考

1. [10个日志记录最佳实践 - 极道](https://www.jdon.com/76292.html)
2. <https://developer.aliyun.com/live/949>
3. <https://github.com/apache/incubator-hugegraph-ai/blob/main/hugegraph-python-client/src/pyhugegraph/utils/log.py>
4. <https://zhuanlan.zhihu.com/p/1916951996038099482>


# import模块

### 1 import原理

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-20679c3547bc5a97f3ad2fab151344ee24b8c924%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

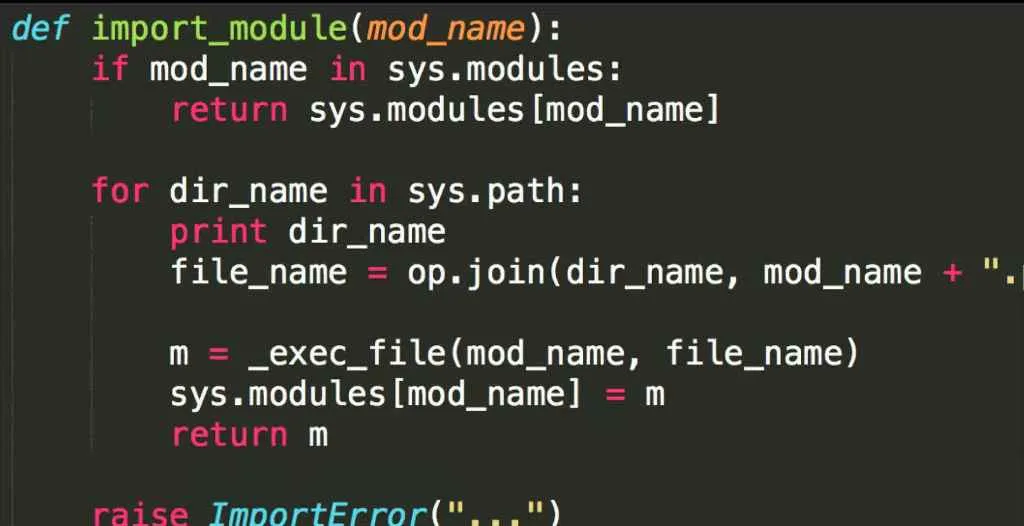
导入一个模块时，Python 首先会检查 `sys.modules` 这个字典。如果模块已经存在于 `sys.modules` 中（即已经被导入过），Python 会直接返回该模块，避免重复加载，确保了模块的单例性。

在 `import` 一个模块前后，观察 `sys.modules.keys()` 的变化，可以看到新导入的模块名被添加了进去。如下：

```python
import sys
list(sys.modules.keys())[:10]

'numpy' in sys.modules.keys() # False

import numpy
list(sys.modules.keys())[:10]

'numpy' in sys.modules.keys() # True
```

`import`语句不仅仅加载模块，还负责执行模块中所有的顶级语句。这意味着，模块中的任何初始化代码都将被执行。

### 2 三种import方法

* 方法一（**`import module_name`** ）：最常见的导入方式。
* 方法二（**`__import__('module_name')`**）：这是一个内置函数，底层由 Python 解释器调用，用于实现 `import` 语句的功能。
* 方法三（**`importlib.import_module('module_name')`**）**：** `importlib` 模块提供的一个函数，推荐在需要动态导入模块时使用。

### 3 如何让外部模块在不修改代码的情况下被 `import`

有时我们需要导入位于非标准路径的模块，或者替换系统自带的模块。在不直接修改代码中的 `import` 语句的情况下，有以下几种常用方法：

1. 修改 `sys.path`

   将模块所在的目录路径添加到 `sys.path` 中。由于 `sys.path` 是一个列表，我们可以使用 `sys.path.insert(0, 'your/module/path')` 将路径添加到列表的开头，确保你的模块优先被搜索到。
2. 通过 `PYTHONPATH` 环境变量 `PYTHONPATH` 是一个环境变量，可以用来指定额外的模块搜索路径。在启动 Python 解释器之前，设置 `PYTHONPATH` 变量，将模块所在的目录添加到其中，Python 解释器会自动将其内容添加到 `sys.path` 中。

   例如：

   ```python
   export PYTHONPATH="./your_lib_folder"; python -c "import your_lib"
   ```
3. 使用 `.pth` 文件

   在 `site-packages` 目录下创建以 `.pth` 为后缀的文件。这些文件中可以包含额外的模块搜索路径，每行一个路径。当 Python 解释器启动时，它会自动读取这些 `.pth` 文件，并将其中的路径添加到 `sys.path` 中。 `.pth`文件不仅可以包含路径，还可以包含Python代码。这对于更高级的配置非常有用，比如条件性地添加路径或者执行一些初始化代码。

   例如：

   ```python
   import sys
   if sys.platform == 'win32':
       sys.path.append('C:/Windows/System32')
   ```

### 4 `import` Hook

`import` Hook 是一种更高级的技巧，它允许我们干预 Python 的导入过程。通过实现 `import` Hook，我们可以在模块被查找、加载和执行的各个阶段插入自定义逻辑。

这使得我们可以实现一些自定义功能，例如：

#### 4.1 **检测 `import` 了哪些模块**

可以用来监控程序的依赖关系。

```python
impl = __import__
def my_importer(*args, **kwargs):
    print("** importing: " + args[0])
    return impl(*args, **kwargs)
__builtins__.__import__ = my_importer
```

#### 4.2 **模块替换（Monkey Patching）**

在不修改原始代码的情况下，用自定义的实现替换系统库或第三方库的某个部分。这在测试、调试或临时修复 Bug 时非常有用。

例如，替换 `urllib2.urlopen` 的行为，使其在本地测试时指向一个模拟服务。

```python
# 原始的urllib.request模块中的urlopen函数
import urllib.request

# 保存原始函数的引用
original_urlopen = urllib.request.urlopen

# 自定义的替代函数
def mock_urlopen(url, *args, **kwargs):
    print(f"Mock: 正在请求URL: {url}")
    
    # 模拟不同URL的返回内容
    if 'api/users' in str(url):
        import io
        return io.BytesIO(b'{"users": ["测试用户1", "测试用户2"]}')
    else:
        # 对于其他URL，调用原始函数
        return original_urlopen(url, *args, **kwargs)

# 替换原始函数
urllib.request.urlopen = mock_urlopen

# 现在，代码中任何对urllib.request.urlopen的调用都会使用mock_urlopen
# 例如:
response = urllib.request.urlopen('https://example.com/api/users')
print(response.read())
```

### 参考

1. [Python系列直播——深入Python与日志服务，玩转大规模数据分析处理实战系列直播第6六讲-云视频-阿里云开发者社区](https://developer.aliyun.com/live/969)
2. [Python 中的 import 机制 - 知乎](https://zhuanlan.zhihu.com/p/678539151)
3. [Python如何import不同文件夹下的文件(module) - 知乎](https://zhuanlan.zhihu.com/p/451438246)
4. [Python模块导入机制深度解析：importlib的10个关键使用技巧与高级特性 - CSDN文库](https://wenku.csdn.net/column/68tay0gm54)


# multiprocessing模块

### 1 Python为什么慢

我们经常听程序员争论”XXX才是世界上最好的语言！”有一个理由常常让Python的拥趸者哑口无言“Python太慢了！”

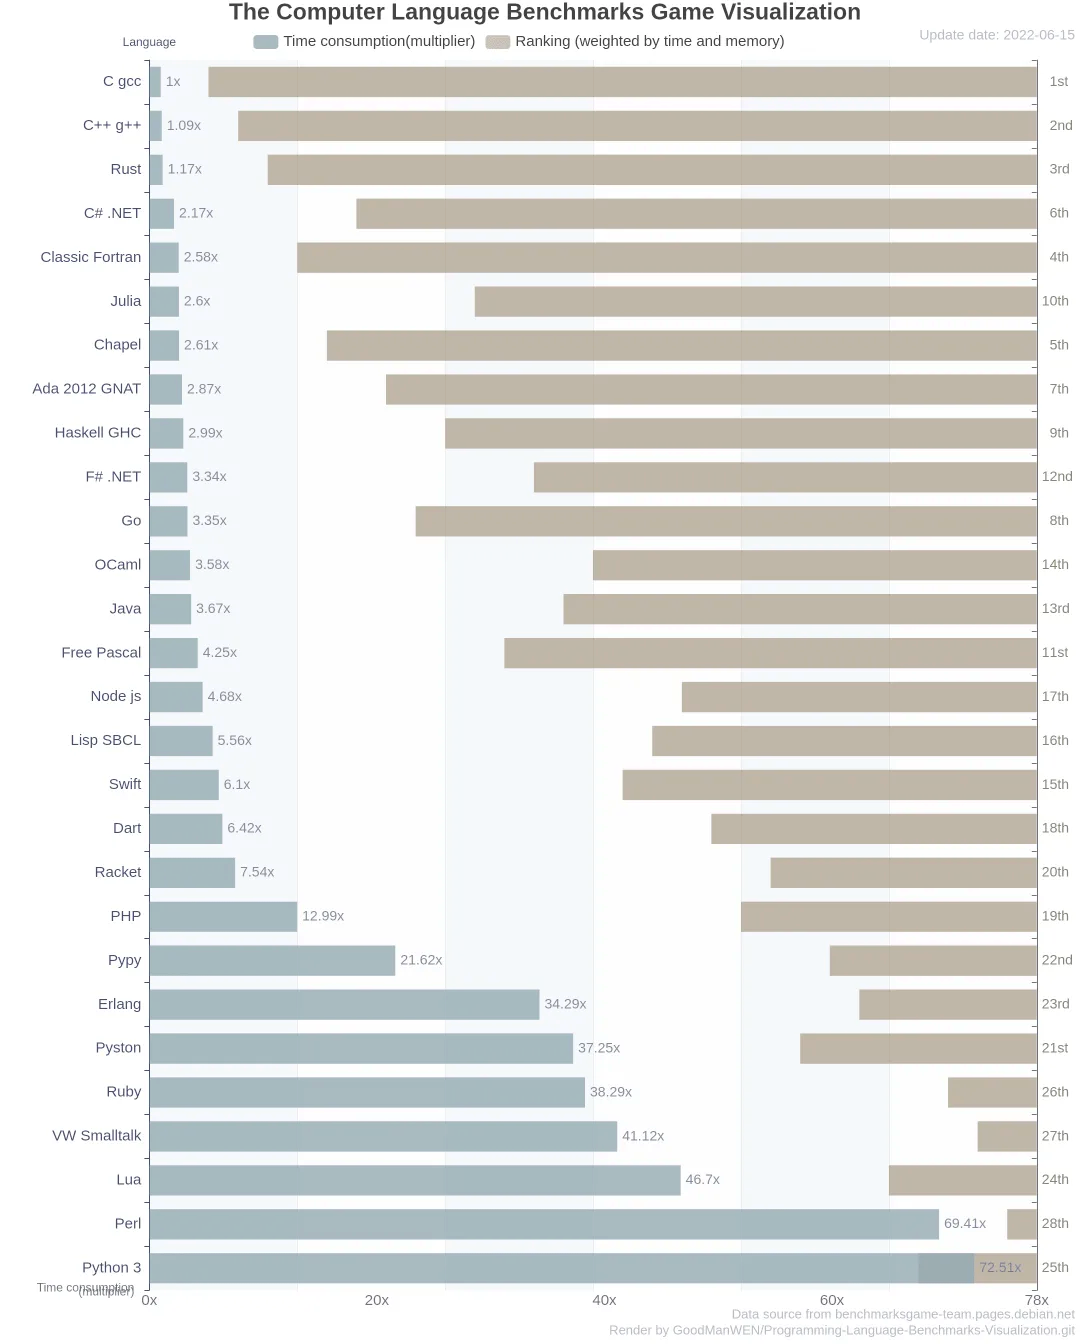
以下是 The Benchmarks Game 面向主流编程语言设计的性能测试榜单，灰色反映的是时间效率，越短代表性能越好，棕色则是基于执行时间和内存开销的加权值。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-70afc89ffa7f95b0a6f50fc9da542be50a8f365e%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Pthon3处于垫底水平，那Python为什么会慢呢？

1. 开发者写的代码不够pythonic

* 对象复制

  下面两种对象复制方法有数倍的速度差异。

  ```python
  from random import randint
  from time import time

  data = [str(randint(1000000, 9999999)) for _ in range(10000000)]

  s = time()
  all_add = ''
  for x in data:
      all_add += x
  e = time()
  print(e-s) # 1.4891037940979004

  s = time()
  all_join = ''.join(data)
  e = time()
  print(e-s) # 0.1853940486907959
  ```
* 迭代器

  用好迭代器能加速部分场景。

  迭代器有**惰性求值**的特性，并非一次性将所有元素加载到内存中，而是在每次需要时才计算并返回下一个元素。

  运行下面的程序，会发现get\_data\_1与get\_data\_2所用的时间类似，但是get\_data\_1的三个url几乎是同时输出，而get\_data\_2的url是一秒一个。

  ```python
  from time import time, sleep

  urls = [
      "url1",
      "url2",
      "url3",
  ]

  def get_data_1(urls):
      results = []
      for url in urls:
          sleep(1)
          results.append("data for " + url)
      return results

  def get_data_2(urls):
      for url in urls:
          sleep(1)
          yield "data for " + url

  s = time()
  for data in get_data_1(urls):
      print(data)
  e = time()
  print(e-s) # 3.0031187534332275

  s = time()
  for data in get_data_2(urls):
      print(data)
  e = time()
  print(e-s) # 3.003131628036499
  ```

  把代码修改成这样应该很容易看出来了：

  ```python
  from time import time, sleep

  urls = [
      "url1",
      "url2",
      "url3",
  ]

  def get_data_1(urls):
      results = []
      for url in urls:
          sleep(1)
          results.append("data for " + url)
      return results

  def get_data_2(urls):
      for url in urls:
          sleep(1)
          yield "data for " + url

  s = time()
  for i, data in enumerate(get_data_1(urls)):
      if i == 0:
          break
      print(i, data)
  e = time()
  print(e-s) # 3.0031187534332275

  s = time()
  for i, data in enumerate(get_data_2(urls)):
      if i == 0:
          break
      print(i, data)
  e = time()
  print(e-s) # 1.0010180473327637
  ```

  不难看到，迭代器的i=0后面的程序就没有再运行了。

  * 数据结构

    不同的数据结构容易造成较大的性能差异，比如：

    ```python
    from time import time
    data1 = list(range(0, 100000))

    data2 = set(range(0, 100000))

    s1 = time()
    99999 in data1
    e1 = time()
    print(e1-s1) # 0.0006175041198730469

    s2 = time()
    99999 in data2 # 1.1920928955078125e-06
    e2 = time()
    print(e2-s2)
    ```

    set是用hash table实现的，hash表查询速度更快
* GIL (Global Interpret Lock)

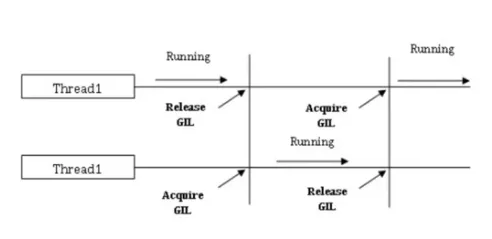
<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-733e037c295fb35161b0e7727787e3ee642c5b72%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

全局解释器锁，确保在**任何一个时刻，同一个Python进程中只有一个线程能够执行Python字节码。因此如果两个线程并发的话还是要做序列化，所以我们才会说Python中无法实现真正的多线程。**

下面是一个例子：

```python
from threading import Thread
from time import time

def empty_loop():
    for _ in range(100000000):
        pass # 耗时程序

def test(thread_count=1, func=empty_loop):
    thread_list = [Thread(target=func) for _ in range(thread_count)]

    s = time()
    for task in thread_list:
        task.start()
    for task in thread_list:
        task.join()
    e = time()

    print('{} threads, {} seconds'.format(thread_count, int(e-s)))

if __name__ == "__main__":
    test(1) # 1 thread, 1 seconds
    test(2) # 2 threads, 2 seconds
    test(3) # 3 threads, 3 seconds
    
```

loop是占用了CPU，而同一进程内只能有一个线程执行，所以会慢，这个代码只是虚有多线程的壳子，没有起到多线程的作用。

#### 2 Python并发解决方案

当然，对于IO密集型的任务（比如文件读写），上面的多线程代码是成立的，因为计算机在等待IO的过程中不占用CPU，可以切换下一个线程。针对IO密集型的任务可以使用各类异步编程库：asyncio, aiohttp, eventlet, twisted等，可以后续文章再细讲。

针对上述CPU密集型的任务（比如计算正则表达式），可以使用多进程。

将上述代码改成多进程，就可以顺利执行：

```python
from multiprocessing import Process
from time import time

def empty_loop():
    for _ in range(100000000):
        pass # 耗时程序

def test(thread_count=1, func=empty_loop):
    thread_list = [Process(target=func) for _ in range(thread_count)]

    s = time()
    for task in thread_list:
        task.start()
    for task in thread_list:
        task.join()
    e = time()

    print('{} process, {} seconds'.format(thread_count, int(e-s)))

if __name__ == "__main__":
    test(1) # 1 process, 1 seconds
    test(2) # 2 processes, 1 seconds
    test(3) # 3 processed, 1 seconds
```

### 2.1 并行与并发的区别

并发（Concurrency）：看起来在同时处理任务，实际可能是使用单个处理器通过快速切换交替执行，给人同时执行的错觉。

并行（Parallelism）：在多核CPU或者多设备上真正的同时执行。

### 2.2 multiprocessing模块

Process类

创建进程的类，由该类实例化得到的对象，表示一个子进程中的任务。

p=Process()

* p.start() 启动进程
* p.run() 进程启动时运行的方法，用于调用target来指定需要执行的函数；这个方法通常不应该由用户直接调用
* p.terminate() 强制终止进程p，但不会做任何的清理操作
* p.is\_alive() 判断p是否还在运行
* p.join(\[timeout]) 主线程等待p结束，确保主进程在子进程完成之后再继续执行

```python
import multiprocessing
import time

def worker(name):
    print(f"进程 {name} 开始工作...")
    time.sleep(3)
    print(f"进程 {name} 完成工作。")

if __name__ == '__main__':
    p = multiprocessing.Process(target=worker, args=('A',))
    
    print("主进程：准备启动子进程。")
    p.start()
   
    print(f"主进程：子进程已启动，状态 is_alive: {p.is_alive()}")
    print("主进程：等待子进程结束...")
    p.join() 
    print(f"主进程：子进程已结束，状态 is_alive: {p.is_alive()}")
    print("主进程：所有工作完成。")
```

Lock

多进程的本质是减少并发过程中锁的使用，但有些时候为了避免资源错乱，不得不用锁。

不加锁的后果：

```python
import multiprocessing

def worker_without_lock(shared_value):
    for _ in range(100000):
        current_value = shared_value.value
        shared_value.value = current_value + 1 # 对共享值进行累加

if __name__ == "__main__":
    shared_number = multiprocessing.Value('i', 0) 

    processes = []
    for _ in range(10):
        p = multiprocessing.Process(target=worker_without_lock, args=(shared_number,))
        processes.append(p)
        p.start()

    for p in processes:
        p.join()

    # 预期结果：1000000
    print(f"实际结果: {shared_number.value}") # 172275，或者任意小于1000000的数字
```

加锁之后：

```python
import multiprocessing

def worker_without_lock(shared_value):
    for _ in range(100000):
        # 加锁
        with shared_value.get_lock():
            current_value = shared_value.value
            shared_value.value = current_value + 1 # 对共享值进行累加

if __name__ == "__main__":
    shared_number = multiprocessing.Value('i', 0) 

    processes = []
    for _ in range(10):
        p = multiprocessing.Process(target=worker_without_lock, args=(shared_number,))
        processes.append(p)
        p.start()

    for p in processes:
        p.join()

    # 预期结果：1000000
    print(f"实际结果: {shared_number.value}") # 1000000
```

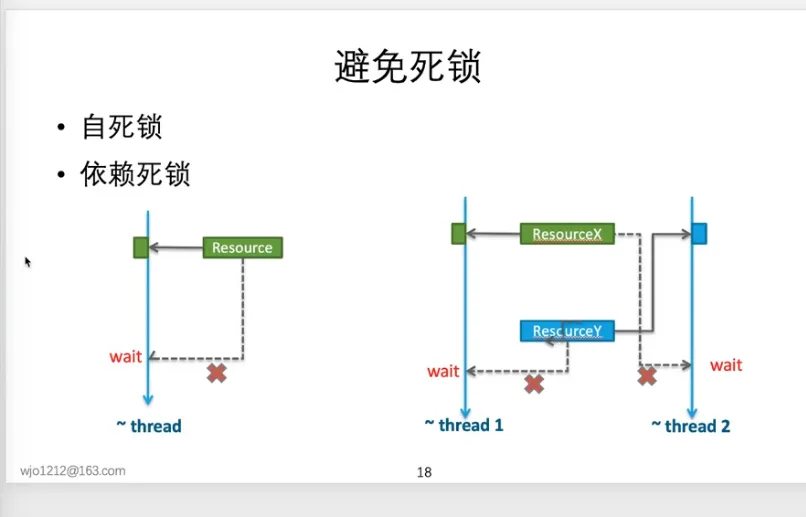
如果一个进程已经持有了某个 `Lock`，在再次尝试获取这个 `Lock` 时，会造成自**死锁**。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-deb3014ef8a86566432fb534176f90d077e4925c%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

相比于普通的Lock，Rlock允许同一个进程多次获取锁：

`RLock` 内部维护着一个**持有者标识**和一个**递归计数器**

1. 当一个进程第一次获取 `RLock` 时，`RLock` 会记录标识，并将计数器设为 1。
2. 当**同一个进程**再次获取这个 `RLock` 时，它会检查到持有者就是自己，于是不会阻塞，而是将计数器加 1。
3. 每次调用 `release()` ，计数器会减 1。
4. 当计数器减到 0 时，锁才会被真正释放，供其它进程获取。

Pool

手动创建进程需要一个一个start并join，略为繁琐，使用进程池可以简化这一过程。

```python
import multiprocessing
import time

def square(x):
    result = x * x
    time.sleep(1)
    return result

if __name__ == "__main__":
    numbers = [1, 2, 3, 4, 5, 6, 7, 8]
    start_time = time.time()

    with multiprocessing.Pool(processes=4) as pool:
        results = pool.map(square, numbers)
   
    end_time = time.time()
```

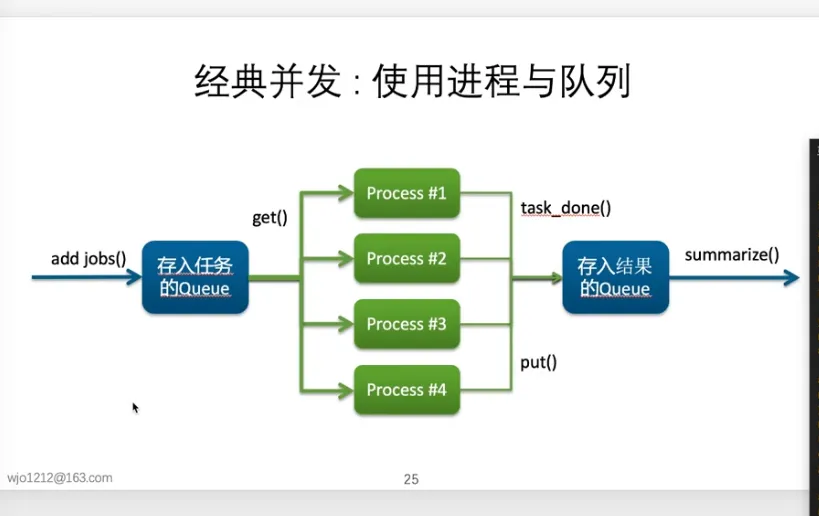
一个经典的并发过程如下图所示：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-2504db2ea76e578fab2bba03a32d9a54dae6610e%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

### 3 条件变量与生产者消费者

上面的过程实际就是生产者与消费者的关系。

现在有两个队列，生产者队列负责添加数据，消费者队列负责取出数据。

在这个过程中，有一个固定大小的缓冲区：

* 当缓冲区已满时，生产者不应再向其中添加数据，否则会覆盖尚未被消费的数据。
* 当缓冲区为空时，消费者不应尝试从中取出数据，因为无数据可取。

如果有一些特殊需求需要满足：

1. 如果消费者要求必须含有至少3个数据才开始消费，应该怎么办
2. 同理生产者呢？
3. 如果每个消费者只能消费特定的数据，应该怎么办？

多进程中可以通过一个共享变量信号量解决：

```python
import multiprocessing
import time

BUFFER_SIZE = 5

def producer(buffer, empty_slots, filled_slots, mutex):
    """生产者进程"""
    for i in range(10):
        # P(empty_slots): 等待一个空位。如果empty_slots为0，则阻塞。
        empty_slots.acquire()
        
        # P(mutex): 获取互斥锁，保护缓冲区。
        mutex.acquire()
        
        # --- 临界区 ---
        # 使用共享内存数组作为循环队列
        buffer[i % BUFFER_SIZE] = i 
        print(f"生产了 -> {i}")
        # --- 临界区结束 ---
        
        # V(mutex): 释放互斥锁。
        mutex.release()
        
        # V(filled_slots): 通知消费者，物品数+1。
        filled_slots.release()
        
        time.sleep(0.1)

def consumer(buffer, empty_slots, filled_slots, mutex):
    """消费者进程"""
    for i in range(10):
        # P(filled_slots): 等待一个物品。如果filled_slots为0，则阻塞。
        filled_slots.acquire()
        
        # P(mutex): 获取互斥锁。
        mutex.acquire()
        
        # --- 临界区 ---
        item = buffer[i % BUFFER_SIZE]
        print(f"    消费了 <- {item}")
        # --- 临界区结束 ---
        
        # V(mutex): 释放互斥锁。
        mutex.release()
        
        # V(empty_slots): 通知生产者，空位数+1。
        empty_slots.release()
        
        time.sleep(0.4)

if __name__ == '__main__':
    # 创建共享内存
    shared_buffer = multiprocessing.Array('i', BUFFER_SIZE)
    
    # 1. 计数信号量，代表空槽位
    empty_slots = multiprocessing.Semaphore(BUFFER_SIZE)
    
    # 2. 计数信号量，代表已填充的槽位
    filled_slots = multiprocessing.Semaphore(0)
    
    # 3. 二进制信号量 (用Lock实现)，用于互斥访问缓冲区
    mutex = multiprocessing.Lock()
    
    # 创建并运行进程
    p = multiprocessing.Process(target=producer, args=(shared_buffer, empty_slots, filled_slots, mutex))
    c = multiprocessing.Process(target=consumer, args=(shared_buffer, empty_slots, filled_slots, mutex))
    
    p.start()
    c.start()
    
    p.join()
    c.join()
```

### 参考

1. [干货：深入浅出讲解Python并发编程（一）-阿里云开发者社区](https://developer.aliyun.com/article/941259)
2. [深入Python与日志服务，玩转大规模数据分析处理实战系列直播第四讲-云视频-阿里云开发者社区](https://developer.aliyun.com/live/932)
3. [各大主流编程语言性能PK，结果出乎意料-CSDN博客](https://blog.csdn.net/hollis_chuang/article/details/125592004)


# 机器学习基础

机器学习的核心是使用算法解析数据，从中学习，并使用学习到的经验预测未来。与显示的教会计算机如何执行任务不同，机器学习是从数据中自动获取经验。

## 数据分析与预处理

但是真实的训练数据可能会存在各种各样的问题：各特征(变量)的尺度(量纲)和数量级差异大、数据中存在缺失值、数据中存在异常值和错误值、存在冗余变量等。

### 特征放缩

若原始数据中各维数据特征分布范围差异大，如果直接使用原始数据来建模，会突出数值尺度较大的特征在建模中的作用，而相对削弱或忽略数值尺度较小的特征的作用。因此，为了保证模型的有效性、可靠性，需要对原始数据的特征做特征缩放，使得各维特征对目标函数有相同权重的影响。

通常为了能够消除数据不同特征的尺度差异大的影响，需要把各维特征都缩放到同一个标准时，这样才具有可比性，这个过程就是数据标准化处理。

因此，数据标准化处理的

* 目标：使各维特征的取值均在相同的范围内以去除不同尺度特征的干扰。
* 作用：加快训练速度以及避免模型被分布范围较大或较小的特征干扰

归一化

归一化是数据标准化处理的一种方式，将数据缩放到\[0,1]或\[-1,1]区间内。

* 极大极小归一化

$$
x' = \frac{x - x\_{min}}{x\_{max} - x\_{min}}
$$

* 均值归一化

$$
x' = \frac{x - \mu}{\sigma}
$$

* 非线性归一化\
  非线性归一化没有把原数据各维特征缩放到某一范围内而是缩小各维特征的尺度(量纲)。平时在一些数据处理中，经常会把原始数据取对数后在做进一步处理。之所以这样做是基于对数函数在其定义域内是单调增函数，取对数之后不会改变数据的性质和相关关系，还可以压缩特征的尺度(量纲)。

归一化总结

特点：归一化会改变原始数据的数据分布，所以不能保留原始信息\
对不同特征做伸缩变换，其目的是使得各个特征维度对目标函数的影响权重是同等程度的。同时，由于对不同特征做伸缩变换程度不同，使得那些扁平分布的目标函数的投影等高线趋于圆形，这样也就改变了原始数据的分布类型。\
作用：\
1、加快训练速度：如迭代算法中目标函数的收敛速度\
2、平衡各维特征权重，避免数值尺度过大、过小的特征对模型的干扰\
缺陷：\
归一化处理数据后，虽然平衡了各维特征权重，但也改变了原始数据的数据分布，即破坏了数据结构。

z-score

z-score标准化处理数据后，数据会服从标准正态分布，即均值为0，标准差为1。

$$
x' = \frac{x - \mu}{\sigma}
$$

z-score保留原始数据信息，不会改变原数据分布类型。z-score的目的也是使原始数据的不同特征具有可比性。

正则化

正则化处理数据将每个样本的某个范数(L1范数、L2范数)缩放为1，即对每个样本计算其p-范数，然后对该样本中的每个元素除以该范数，使得处理后数据的每个样本的p-范数等于1。

$$
X' = \frac{X}{||X||\_p}
$$

正则化处理数据主要应用于文本分类和聚类中，对需要计算样本之间相似度的模型，正则化可以提高计算效率。

### 缺失值处理

现实生活中的数据往往是不全面的，很多样本的属性值会有缺失，例如某个人填写的个人信息不完整或者对个人隐私的保护政策导致建模时可能无法得到所需要的特征，尤其是在数据量较大时，这种缺失值的产生会对模型的性能造成很大的影响。

1. 删除缺失值
2. 填补缺失值
   * 将缺失值替换为均值、中位数、众数、最大值、最小值等
   * 使用KNN算法填充：缺失样本点周围最近的k个样本的均值或最大值填充(使用前提是，数据不是连片缺失，否则缺失样本点周围的样本也有缺失值，那就用不成了)
   * 加权平均值/期望替换缺失值：比较含缺失值的样本与其他样本之间的的相似度，计算其加权平均值=Σ(特征值i\*相似度i)/sum(相似度)，过程和基于用户相似度的SVD推荐系统差不多。

## 模型验证与评估

### 欠拟合与过拟合

欠拟合：模型在训练集上误差很高；

欠拟合原因：模型过于简单，没有很好的捕捉到数据特征，不能很好的拟合数据。

过拟合：在训练集上误差低，测试集上误差高；

过拟合原因：模型把数据学习的太彻底，以至于把噪声数据的特征也学习到了，这样就会导致在后期测试的时候不能够很好地识别数据，模型泛化能力太差。

解决过拟合问题：\
1、增加数据量\
数据收集：通过各种途径收集更多与问题相关的数据。例如，对于图像分类任务，可以从互联网上的公开图像数据集获取更多图像，或者自行采集更多符合任务要求的图像。\
数据扩充：当难以获取大量真实数据时，可以采用数据扩充技术。对于图像数据，常见的扩充方法包括旋转、翻转、缩放、裁剪、添加噪声等；对于文本数据，可以进行同义词替换、随机插入、随机删除等操作来生成更多类似但又有差异的数据样本。\
2、正则化\
L1 和 L2 正则化：在模型的损失函数中添加正则化项。L1 正则化会促使模型的一些权重趋近于零，从而实现特征选择的效果；L2 正则化则是限制权重的平方和，使得权重的值不会过大，起到抑制过拟合的作用。在许多机器学习框架中，如在训练线性回归、逻辑回归、神经网络等模型时，都可以很方便地设置 L1 或 L2 正则化参数。\
Dropout：主要应用于神经网络中。在训练过程的每次迭代中，随机地将一部分神经元的输出设置为零，这样可以防止神经元之间过度依赖特定的连接模式，从而降低模型的复杂度，减少过拟合。例如在训练深度神经网络进行图像分类时，在每一层的神经元连接中应用 Dropout 技术，通常设置一个合适的 Dropout 概率，如 0.5 等。\
3、简化模型结构\
减少层数或神经元数量：对于神经网络，如果模型层数过多或者每层的神经元数量过多，容易导致过拟合。可以尝试减少网络的层数，比如从一个很深的卷积神经网络去掉几层；或者降低每层神经元的数量，例如将某一层原本有 1000 个神经元减少到 500 个。\
选择更简单的模型类型：如果使用的是较为复杂的模型，如深度神经网络，而数据量相对较少或问题本身相对简单，可以考虑换成更简单的模型，如线性回归（对于线性关系明显的问题）、决策树（对于可通过简单规则划分的数据）等。\
4、早停法\
在模型训练过程中，随着训练轮次的增加，模型在训练集上的误差会不断降低，但在验证集上的误差可能会先降低后升高。早停法就是监测验证集上的误差，当验证集上的误差开始上升时（表明模型开始过拟合训练集），就停止训练，从而得到一个在泛化能力上相对较好的模型。例如，在训练一个深度学习模型时，每隔一定的训练轮次（如每 10 轮）就评估一次模型在验证集上的性能，一旦发现验证集性能下降，就停止训练。

解决欠拟合问题：\
1、增加模型复杂度\
增加层数或神经元数量：对于神经网络，若发现模型存在欠拟合，可以尝试增加网络的层数，比如在一个浅层的卷积神经网络基础上再添加几层；或者增加每层神经元的数量，例如将某一层原本有 200 个神经元增加到 400 个。\
使用更复杂的模型类型：如果当前使用的是简单模型，如线性回归，而数据呈现出明显的非线性关系，那么可以考虑换成更复杂的模型，如多项式回归（在线性回归基础上增加多项式项）、神经网络等。\
2、延长训练时间\
如果模型训练时间过短，可能导致模型还没有充分学习到数据中的规律，从而出现欠拟合。可以适当延长训练时间，比如将原本训练 100 轮次增加到 200 轮次，让模型有更多机会去学习数据中的模式。

3、检查数据预处理\
特征工程：确保进行了充分的特征工程，例如对数据进行标准化、归一化等操作，使得数据更适合模型学习。如果数据没有经过合理的预处理，可能会影响模型的学习效果，导致欠拟合。\
数据清理：检查数据中是否存在大量错误、缺失值等情况。如果有，需要进行相应的清理操作，如填充缺失值、纠正错误值等，以便模型能够更好地学习数据。\
4、调整超参数\
不同的超参数设置会影响模型的学习效果。对于一些模型，如神经网络，可以调整学习率、批量大小等超参数。如果学习率过大，可能导致模型无法稳定地学习数据，出现欠拟合；如果学习率过小，又会导致训练时间过长。通过尝试不同的超参数组合，找到一个更适合的设置，有助于解决欠拟合问题。

三、偏差与方差\
1、模型误差来源\
在上一部分，我们知道了欠拟合是模型在训练集上误差过高，过拟合模型是在训练集上误差低，在测试集上误差高。那么模型误差的来源是什么呢？

```
    其实，模型在训练集上的误差来源主要来自于偏差，在测试集上误差来源主要来自于方差。


    上图表示，如果一个模型在训练集上正确率为 80%，测试集上正确率为 79% ，则模型欠拟合，其中 20% 的误差来自于偏差，1% 的误差来自于方差。如果一个模型在训练集上正确率为 99%，测试集上正确率为 80% ，则模型过拟合，其中 1% 的误差来自于偏差，19% 的误差来自于方差。

    可以看出，欠拟合是一种高偏差的情况。过拟合是一种低偏差，高方差的情况。
```

### 方差与偏差

偏差：预计值的期望与真实值之间的差距；\
方差：预测值的离散程度，也就是离其期望值的距离。

### 验证集与交叉验证

在机器学习中，通常需要评估若⼲候选模型的表现并从中选择模型。这⼀过程称为模型选择。可供选择的候选模型可以是有着不同超参数的同类模型。以神经网络为例，我们可以选择隐藏层的个数，学习率大小和激活函数。为了得到有效的模型，我们通常要在模型选择上下⼀番功夫。从严格意义上讲，测试集只能在所有超参数和模型参数选定后使用⼀次。不可以使用测试数据选择模型，如调参。由于无法从训练误差估计泛化误差，因此也不应只依赖训练数据选择模型。鉴于此，我们可以预留⼀部分在训练数据集和测试数据集以外的数据来进⾏模型选择。这部分数据被称为验证数据集，简称验证集。

K折交叉验证

## 分类算法与评估指标

### MSE

MSE(均方误差)是回归任务中最常用的性能度量，计算预测值与真实值之间误差的平方。

$$
MSE = \frac{1}{n} \sum\_{i=1}^{n} (y\_i - \hat{y}\_i)^2
$$

### RMSE

RMSE(均方根误差)是MSE的平方根。

$$
RMSE = \sqrt{MSE}
$$

### MAE

MAE(平均绝对误差)是预测值与真实值之间绝对误差的平均值。

$$
MAE = \frac{1}{n} \sum\_{i=1}^{n} |y\_i - \hat{y}\_i|
$$

### R-Squared

R-Squared(决定系数)是回归任务中最常用的性能度量，计算预测值与真实值之间的相关性。

$$
R^2 = 1 - \frac{\sum\_{i=1}^{n} (y\_i - \hat{y}*i)^2}{\sum*{i=1}^{n} (y\_i - \bar{y})^2}
$$

### precision, recall, F1-score

precision(精确率)是预测为正的样本中实际为正的比例。

$$
precision = \frac{TP}{TP + FP}
$$

recall(召回率)是实际为正的样本中预测为正的比例。

$$
recall = \frac{TP}{TP + FN}
$$

F1-score是精确率和召回率的调和平均值。

$$
F1-score = \frac{2 \times precision \times recall}{precision + recall}
$$

### auc, roc, pr曲线

auc(area under curve)是roc曲线下面积。

roc(receiver operating characteristic curve)是接收者操作特征曲线。

pr曲线是precision-recall曲线。

auc为什么适合排序问题？

## 损失函数与优化

1. <https://blog.csdn.net/qingtianhaoshuai/article/details/124222008>
2. <https://blog.csdn.net/m0\\_72968288/article/details/143662769>


# 特征提取


# 文本表示模型


# Bag-of-words

## 1 bag-of-words

词袋模型（Bag-of-Words model，BOW）的基本思想是：假定对于一段文本，忽略其词序和语法，仅将其当作一个词汇的集合，如同一个袋子一样。

### 1.1 从one-hot讲起

例如一句话`I love you`，每个词都是一个数值表示：

```
I: [1, 0, 0]
love: [0, 1, 0]
you: [0, 0, 1]
```

这是一种简单的编码方式，但是存在着维度灾难（词越多越稀疏）和语义鸿沟（无法进行相似度计算）等问题。

### 1.2 tf-idf

如果仅仅考虑词汇的词频（即TF），会导致一些常见词汇的权重过高，而忽略了一些重要的词汇。

TF-IDF（Term Frequency-Inverse Document Frequency）通过引入逆文档频率（IDF）来更好地体现文本特征。TF-IDF的计算公式如下：

```
TF(t) = frequency of t in document / total words in document
IDF(t) = log(total documents / number of documents with term t in it + 1)
TF-IDF(t) = TF(t) * IDF(t)
```


# Topic Model

## 1 主题模型

主题模型是一种特殊的概率图模型，可以识别两个不同的词或者词组是否具有相同的主题。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-f1d4a9a5331c03fe7433360ddd1678777045835d%2FTOPIC-MODEL.png?alt=media" alt=""><figcaption><p>Topic Model</p></figcaption></figure>

主题模型将相似/相关的词语聚集成簇，称为主题。

### 1.1 LSA（SVD）

潜在语义分析（Latent Semantic Analysis，LSA）是一种基于奇异值分解（SVD）的主题模型，通过降维将文本数据转换为低维的语义空间。

#### 1.1.1 奇异值分解

特征值和特征向量 对于一个矩阵$$A$$，如果存在一个非零向量$$x$$，使得$$Ax = \lambda x$$，则称$$\lambda$$为$$A$$的特征值，$$x$$为$$A$$的特征向量。

相似对角化 对于一个矩阵$$A$$，如果存在一个可逆矩阵$$P$$，使得$$P^{-1}AP = B$$，其中$$B$$是对角矩阵，则称$$A$$被$$P$$对角化。

对角矩阵指的是除了对角线上的元素外，其他元素都为0的矩阵。 如：

$$
\begin{bmatrix} 1 & 0 & 0 \ 0 & 2 & 0 \ 0 & 0 & 3 \end{bmatrix}
$$

但是不是所有的矩阵都可以对角化，满足矩阵可对角化的充分必要条件是：n阶矩阵$$A$$有$$n$$个线性无关的特征向量。

实对称矩阵 实对称矩阵满足以下条件：

* 矩阵关于主对角线对称，即$$a\_{ij} = a\_{ji}$$

例如：

$$
\begin{bmatrix} 1 & 2 & 3 \ 2 & 4 & 5 \ 3 & 5 & 6 \end{bmatrix}
$$

实对称矩阵的所有特征向量彼此正交，所以任何实对称矩阵都可以被正交对角化。

将矩阵$$P$$正交化，形成矩阵$$Q$$，则$$Q^TQ = I$$，即$$Q$$是正交矩阵。

$$
A = PBP^{-1} = QBQ^T
$$

奇异值分解 更一般的情况，对于一个$$m \times n$$的矩阵$$A$$，存在两个正交矩阵$$U$$和$$V$$，使得：

$$
A = U S V^T
$$

其中$$S$$是一个$$m \times n$$的对角矩阵，对角线上的元素称为奇异值。

于是，SVD将矩阵$$A$$分解为三个矩阵的乘积，可以用于降维、特征提取等。

#### 1.1.2 LSA的原理

假设我们有m篇文档，词表大小为n。我们希望从所有文档中提取出K个主题，其中K为用户输入的超参。

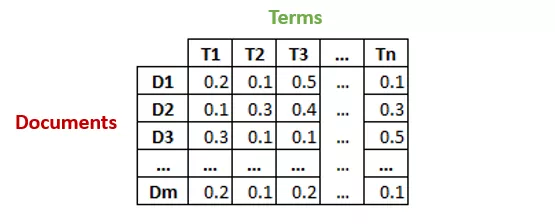
1. 生成一个m×n维的文档-词项矩阵（Document-Term Matrix），矩阵元素为TF-IDF分数

   <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-2b95e260a47e918763c2ae35eb1d8c99a2582e7f%2FLSA-1.png?alt=media" alt=""><figcaption><p>LSA</p></figcaption></figure>
2. 使用SVD将上述矩阵的维度降到K维

   SVD首先将矩阵$$A$$分解为三个矩阵的乘积：

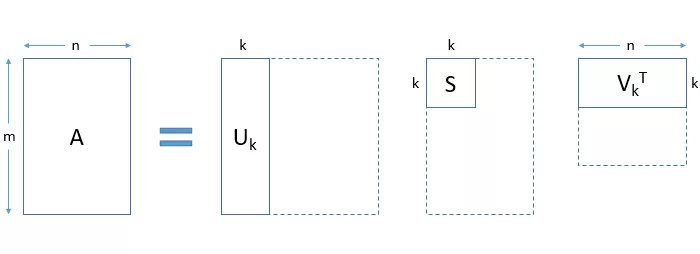
   <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-627a6520d7abba20aae1874adcfc546710574e09%2FLSA-2.png?alt=media" alt=""><figcaption><p>LSA</p></figcaption></figure>

   由于我们只需要前K个奇异值，所以只保留前K个奇异值，并相应地截断矩阵$$U$$和$$V$$，重新构造近似矩阵。

   在这里，矩阵$$U\_k$$的每个行向量代表相应的文档。矩阵$$V\_k$$的每个行向量代表相应的词项。向量的长度均为K。

   因此，SVD为每篇文档和每个词项都生成了向量表示，这些向量表示可以用于计算文档之间的相似度，或者词项之间的相似度。

#### 1.1.3 手撕LSA

1. 加载数据集，使用sklearn的`fetch_20newsgroups`加载新闻数据集

   ```python
   from sklearn.datasets import fetch_20newsgroups
   dataset = fetch_20newsgroups(shuffle=True, random_state=1, remove=('header','footers',quotes'))
   documents = dataset.data
   ```
2. 数据预处理，包括去除标点符号、分词、去停用词、词干提取等

   ```python
   news_df = pd.DataFrame({'document':documents})

   # removing everything except alphabets
   news_df['clean_doc'] = news_df['document'].str.replace("[^a-zA-Z#]", " ")

   # removing short words
   news_df['clean_doc'] = news_df['clean_doc'].apply(lambda x: ' '.join([w for w in x.split() if len(w)>3]))

   # make all text lowercase
   news_df['clean_doc'] = news_df['clean_doc'].apply(lambda x: x.lower())

   from nltk.corpus import stopwords
   stop_words = set(stopwords.words('english'))

   # tokenization
   tokenized_doc = news_df['clean_doc'].apply(lambda x: x.split())

   # remove stop-words
   tokenized_doc = tokenized_doc.apply(lambda x: [item for item in x if item not in stop_words])

   # de-tokenization
   detokenized_doc = []
   for i in range(len(news_df)):
       t = ' '.join(tokenized_doc[i])
       detokenized_doc.append(t)

   news_df['clean_doc'] = detokenized_doc
   ```
3. 创建文档-词项矩阵

   使用sklearn的TfidfVectorizer创建文档-词项矩阵

   ```python
   from sklearn.feature_extraction.text import TfidfVectorizer

   vectorizer = TfidfVectorizer(stop_words='english', max_features=1000, max_df=0.5, smooth_idf=True)

   X = vectorizer.fit_transform(news_df['clean_doc'])
   ```
4. 使用SVD进行降维

   ```python
   from sklearn.decomposition import TruncatedSVD

   svd_model = TruncatedSVD(n_components=20, algorithm='randomized', n_iter=100, random_state=42)

   svd_model.fit(X)

   print(len(svd_model.components_))
   ```
5. 获取主题词

   svd\_model的组成部分是我们的主题词，我们可以通过`svd_model.components_`获取。

   ```python
   terms = vectorizer.get_feature_names()

   for i, comp in enumerate(svd_model.components_):
       terms_comp = zip(terms, comp)
       sorted_terms = sorted(terms_comp, key=lambda x:x[1], reverse=True)[:7]
       print("Topic "+str(i)+": ")
       for t in sorted_terms:
           print(t[0])
       print(" ")
   ```

   输出结果如下：

   ```
   Topic 0: like know people think good time thanks

   Topic 0: like know people think good time thanks

   Topic 1: thanks windows card drive mail file advance

   Topic 2: game team year games season players good

   Topic 3: drive scsi disk hard card drives problem

   Topic 4: windows file window files program using problem

   Topic 5: government chip mail space information encryption data

   Topic 6: like bike know chip sounds looks look

   …
   ```

#### 3.1.4 LSA的优缺点

* 优点
  * LSA快速且易于实施
  * 结果比简单的向量模型更好
* 缺点
  * LSA是线性模型，在具有非线性依赖性的数据集上效果不佳
  * LSA假设文本中的词项服从正态分布，可能不适用于所有问题
  * SVD是计算密集型的，当新数据出现时难以更新

### 3.2 pLSA

LSA的根本问题在于，尽管我们可以把$$U\_k$$和$$V\_k$$看作文档和词项的向量表示，但是这两个矩阵并没有明确的语义解释。pLSA（Probabilistic Latent Semantic Analysis）通过引入概率模型来解决这个问题。

#### 3.2.1 pLSA的原理

pLSA通过一个生成模型来为LSA提供概率意义上的解释。该模型假设，每篇文档都包括一系列可能的潜在主题。文档中的每个单词都不是凭空产生的，而是在这些潜在话题（即单词的概率分布）的指引下通过一定的概率生成的。

话题是单词的概率分布，文档是话题的概率分布，则单词是文档和话题的联合概率分布。

假设有M个单词集合$$W={w\_1, w\_2, ..., w\_M}$$，N个文档集合$$D={d\_1, d\_2, ..., d\_N}$$，K个主题集合$$Z={z\_1, z\_2, ..., z\_K}$$。概率分布$$P(d)$$表示生成文档$$d$$的概率，$$P(w|z)$$表示在主题$$z$$下生成单词$$w$$的概率，$$P(z|d)$$表示在文档$$d$$中生成主题$$z$$的概率。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-7be1c2decc950e5c6e86941a7e1b5ffa0634ccf9%2FPLSA.png?alt=media" alt=""><figcaption><p>pLSA</p></figcaption></figure>

则$$p(w|d)$$的推导为：

$$
p(w|d) = \sum\_{z} p(w, z|d) = \sum\_{z} p(w|z, d) p(z|d)
$$

整个语料库中的概率生成可以用似然函数表示：

$$
L = \prod\_{d \in D} \prod\_{w \in d} p(w, d)^{n\_{dw}}
$$

其中，$$n\_{dw}$$表示文档$$d$$中单词$$w$$出现的次数。

推导后得：

$$
L = \prod\_{d \in D} \prod\_{w \in d} \sum\_{z} p(d) p(w|z, d) p(z|d)^{n\_{dw}}
$$

其中，$$p(w|z, d)$$和$$p(z|d)$$是模型的参数，可以通过EM算法进行估计。

#### 3.2.2 手撕pLSA

```python
import numpy as np
from sklearn.feature_extraction.text import CountVectorizer
 
 
class PLSA:
    def __init__(self, num_topics, num_iterations):
        self.num_topics = num_topics
        self.num_iterations = num_iterations
        self.vocab = None
        self.num_words = None
        self.num_documents = None
        self.word_count = None
        self.P_z_given_d = None
        self.P_w_given_z = None
        self.P_z_given_dw = None
 
    def fit(self, documents):
        vectorizer = CountVectorizer()
        count_matrix = vectorizer.fit_transform(documents)
        self.vocab = vectorizer.get_feature_names_out()
        self.num_words = len(self.vocab)
        self.num_documents = count_matrix.shape[0]
        self.word_count = count_matrix.toarray()
 
        # Initialize parameters
        self.P_z_given_d = np.random.rand(self.num_documents, self.num_topics)
        self.P_w_given_z = np.random.rand(self.num_topics, self.num_words)
        self.P_z_given_dw = np.zeros((self.num_documents, self.num_words, self.num_topics))
 
        # Run EM algorithm
        for i in range(self.num_iterations):
            print(f'Iteration {i + 1}')
 
            # E-step
            for d in range(self.num_documents):
                for w in range(self.num_words):
                    denominator = np.sum(self.P_w_given_z[:, w] * self.P_z_given_d[d])
                    for z in range(self.num_topics):
                        numerator = self.P_w_given_z[z, w] * self.P_z_given_d[d, z]
                        self.P_z_given_dw[d, w, z] = numerator / denominator
 
            # M-step
            for z in range(self.num_topics):
                for w in range(self.num_words):
                    numerator = 0
                    for d in range(self.num_documents):
                        numerator += self.word_count[d, w] * self.P_z_given_dw[d, w, z]
                    self.P_w_given_z[z, w] = numerator / np.sum(self.word_count)
 
            for d in range(self.num_documents):
                for z in range(self.num_topics):
                    numerator = 0
                    for w in range(self.num_words):
                        numerator += self.word_count[d, w] * self.P_z_given_dw[d, w, z]
                    self.P_z_given_d[d, z] = numerator / np.sum(self.word_count[d, :])
 
    def transform(self, documents):
        vectorizer = CountVectorizer(vocabulary=self.vocab)
        count_matrix = vectorizer.fit_transform(documents)
        word_count = count_matrix.toarray()
        P_z_given_d = np.zeros((count_matrix.shape[0], self.num_topics))
 
        for d in range(count_matrix.shape[0]):
            for z in range(self.num_topics):
                numerator = 0
                for w in range(self.num_words):
                    numerator += word_count[d, w] * self.P_w_given_z[z, w] * self.P_z_given_d[d, z]
                P_z_given_d[d, z] = numerator / np.sum(word_count[d, :])
 
        return P_z_given_d
```

#### 3.2.3 pLSA的优缺点

* 优点
  * pLSA是一种概率模型，可以为LSA提供概率意义上的解释
  * pLSA可以更好地捕捉文档和词项之间的关系
* 缺点
  * pLSA是一种非凸优化问题，容易陷入局部最优解
  * pLSA对于数据的噪声和稀疏性敏感
  * pLSA无法处理新数据的出现

### 3.3 LDA

LDA（Latent Dirichlet Allocation）可以看作是pLSA的贝叶斯版本，它引入了Dirichlet先验分布来解决pLSA的一些问题。

#### 3.3.1 二项分布和多项分布

二项分布是N次伯努利分布，即$$X \sim B(n, p)$$。概率密度为：

$$
P(X=k) = C\_n^k p^k (1-p)^{n-k}
$$

多项分布是二项分布拓展到多维的情况。多项分布是指在单次实验中的随机变量的取值不再是0和1，而是多个不同的值。多项分布的概率密度为：

$$
P(X\_1=k\_1, X\_2=k\_2, ..., X\_n=k\_n) = \frac{n!}{k\_1!k\_2!...k\_n!} p\_1^{k\_1} p\_2^{k\_2} ... p\_n^{k\_n}
$$

其中，$$p\_1, p\_2, ..., p\_n$$代表每个类别的概率，且$$\sum\_{i=1}^{n} p\_i = 1$$。

#### 3.3.2 共轭先验分布

如果后验概率$$P(\theta|X)$$和先验概率$$P(\theta)$$属于同一分布族，则称先验分布和后验分布是共轭分布。

$$
P(\theta|X) = \frac{P(X|\theta)P(\theta)}{P(X)}
$$

对于二项分布，Beta分布是其共轭先验分布。对于多项分布，Dirichlet分布是其共轭先验分布。

#### 3.3.3 Dirichlet分布

Dirichlet的概率密度函数为：

$$
Dir(\theta|\alpha) = \frac{\Gamma(\sum\_{i=1}^{K} \alpha\_i)}{\prod\_{i=1}^{K} \Gamma(\alpha\_i)} \prod\_{i=1}^{K} \theta\_i^{\alpha\_i - 1}
$$

#### 3.3.4 为什么引入Dirichlet先验分布

pLSA采用的是频率派观点，将每篇文章对应的主题分布$$P(z|d)$$和每个主题对应的词分布$$P(w|z)$$看成未知常数，并可以求解出来。LDA采用的是贝叶斯学派的观点，认为待估计的参数（主题分布和词分布）不再是一个固定的常数，而是服从一定分布的随机变量。这个分布符合一定的先验概率分布（即Dirichlet分布），通过观测数据来更新这个分布的参数。

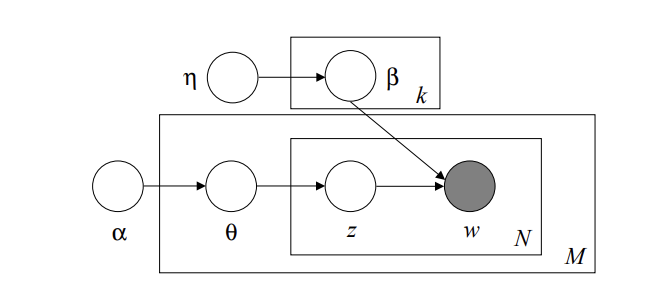
<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-5c9dd88212cc54c74ad7a7daa7a1c9acfd38b0a6%2FLDA.png?alt=media" alt=""><figcaption><p>LDA</p></figcaption></figure>

#### 3.3.3 LDA的原理

语料库的生成过程：

1. 按照先验概率$$p(d\_i)$$选择一篇文档$$d\_i$$
2. 从超参数$$\alpha$$的Dirichlet分布中抽样生成文档$$d\_i$$的主题分布$$\theta\_i$$
3. 对于文档$$d\_i$$中的每个词$$w\_{ij}$$：
   * 从文档$$d\_i$$的主题分布$$\theta\_i$$中抽样生成词$$w\_{ij}$$的主题$$z\_{ij}$$
4. 从超参数$$\beta$$的Dirichlet分布中抽样生成主题$$z\_{ij}$$的词分布$$\phi\_{z\_{ij}}$$
5. 从词分布$$\phi\_{z\_{ij}}$$中抽样生成词$$w\_{ij}$$

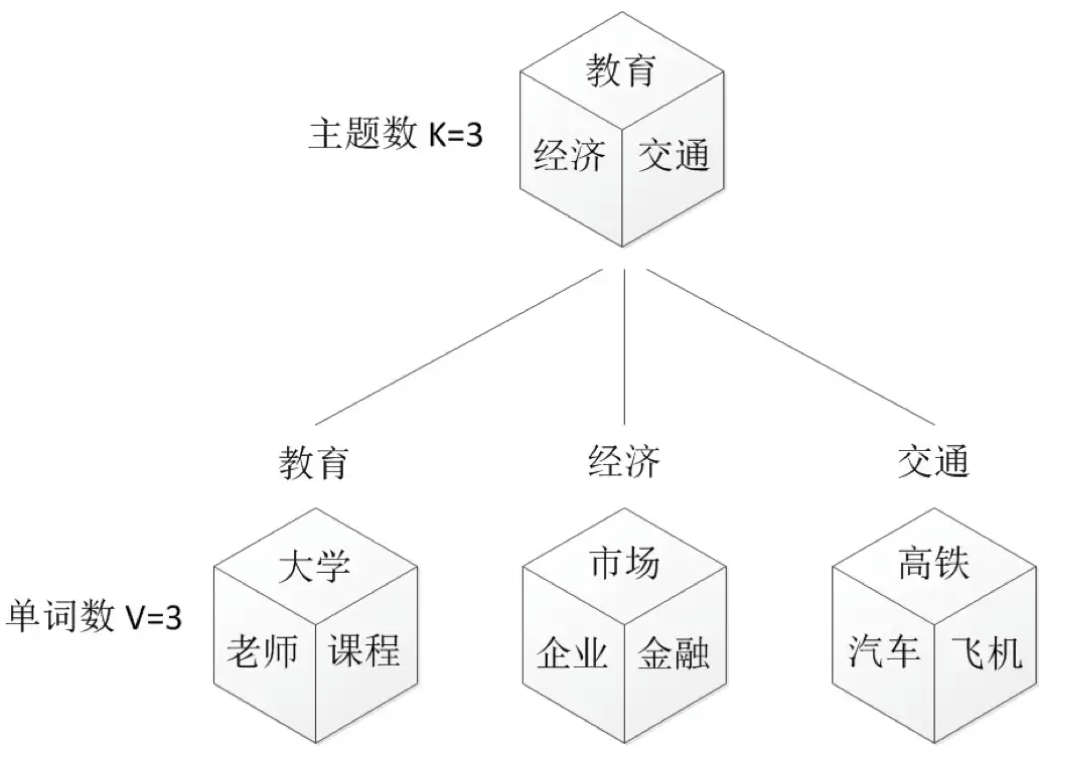
<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-720aa7a2c4f69fe96961fca7cc1db6107e9ee760%2FLDA-EXAMPLE.png?alt=media" alt=""><figcaption><p>LDA EXAMPLE</p></figcaption></figure>

在PLSA中，会使用固定的概率来抽取主题词，主题分布和词分布都是唯一确定的。而在LDA中，主题分布和词分布是不确定的，它们是服从Dirichlet分布的随机变量。

#### 3.3.4 LDA的实现

TODO：参考baidu <https://github.com/baidu/Familia/wiki>

## 参考资料

1. <https://blog.csdn.net/mch2869253130/article/details/100629262>
2. <https://www.jiqizhixin.com/articles/2018-12-07-10>
3. <https://zhuanlan.zhihu.com/p/71027182>
4. <https://blog.csdn.net/zhong\\_ddbb/article/details/106317068>
5. <https://blog.csdn.net/daishabby2486/article/details/129837268>
6. <https://zhuanlan.zhihu.com/p/31470216>
7. <https://dl.acm.org/doi/pdf/10.5555/944919.944937>


# Static Word Embeddings

## 4 基于词向量的固定表征

### 4.1 Word2Vec

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6c924fd1dcc5c2348b1752b84925b08e4a3130df%2FWORD2VEC-1.png?alt=media" alt=""><figcaption><p>Word2Vec</p></figcaption></figure>

Word2Vec通过一个简单的双层神经网络来从大量文本中学习单词之间的联系。

Word2Vec有两种模型：

* Skip-gram：通过一个词预测它周围的词，即输入一个词，输出多个词。
* CBOW：通过周围的词预测中心词，即输入多个词，输出一个词。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-06351bef77e3a7693309cef1b08bfb7d8670b8de%2FWORD2VEC-2.png?alt=media" alt=""><figcaption><p>Word2Vec</p></figcaption></figure>

#### 4.1.1 CBOW

* 原理
  * CBOW通过上下文（即周围的词）来预测当前词。对输入中的多个词向量做处理（如求和或者平均）来预测目标词。
* 实现方式
  * 输入层：上下文词的one-hot编码
  * 隐藏层：通过权重矩阵将输入转为低维的密集向量
  * 输出层：使用softmax预测目标词的概率分布
* 优缺点
  * 优点：在处理大型语料库时，CBOW模型能够平滑许多分布信息，对于较小的数据集表现较好。

**4.1.1.1 CBOW的实现**

```python
import torch
import torch.nn as nn
import torch.optim as optim
```

首先创建CBOW训练使用的数据集。

```python
sentences = ["i like dog", "i love coffee", "i hate milk"]
# 构建词汇表
word_list = " ".join(sentences).split()
word_list = list(set(word_list))

# 创建one-hot映射
word_to_idx = {word: i for i, word in enumerate(word_list)}
idx_to_word = {i: word for i, word in enumerate(word_list)}

# 生成CBOW训练数据
def make_cbow_data(sentences, window_size=2):
    data = []
    for sentence in sentences:
        sentence = sentence.split()
        for idx, word in enumerate(sentence):
            # 将当前单词前后各window_size个单词作为周围词
            context = [sentence[i] for i in range(max(idx-window_size, 0), min(idx+window_size+1, len(sentence)))]
            target = word
            data.append((context, target))
    return data

cbow_data = make_cbow_data(sentences)
```

```python
# 定义one-hot编码函数
def make_one_hot_encoding(word, word_to_idx):
    # 创建一个与词汇表长度相同的全0向量
    encoding = torch.zeros(len(word_to_idx))
    # 将对应单词的位置设为1
    encoding[word_to_idx[word]] = 1
    return encoding
```

创建CBOW模型

```python
# 定义CBOW模型
class CBOW(nn.Module):
    def __init__(self, vocab_size, embedding_size):
        super(CBOW, self).__init__()
        # 从词汇表达小到隐藏层的线性层
        self.input_layer = nn.Linear(vocab_size, embedding_size)
        # 从隐藏层到词汇表大小的线性层
        self.output_layer = nn.Linear(embedding_size, vocab_size)
    
    def forward(self, X):
        # 生成嵌入
        embedding = self.input_layer(X)
        # 求平均：结合上下文信息
        embedding = torch.mean(embedding, dim=0)
        # 生成输出
        output = self.output_layer(embedding)
        return output

embedding_size = 2
cbow_model = CBOW(len(word_list), embedding_size)
```

```python
# 训练
learning_rate = 0.01
epochs = 10000
# 使用交叉熵损失
loss_fn = nn.CrossEntropyLoss()
# 使用随机梯度优化
optimizer = optim.SGD(cbow_model.parameters(), lr=learning_rate)

loss_values = []
for epoch in range(epochs):
    total_loss = 0
    for context, target in cbow_data:
        # 将上下文转换为one-hot编码
        context = torch.stack([make_one_hot_encoding(word, word_to_idx) for word in context])
        # 将目标转换为索引
        target = torch.tensor(word_to_idx[target])
        # 前向传播
        output = cbow_model(context)
        # 计算损失
        loss = loss_fn(output, target)
        total_loss += loss.item()
        # 反向传播
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    loss_values.append(total_loss)
    if (epoch+1) % 100 == 0:
        print(f'Epoch {epoch+1}/{epochs}, Loss: {total_loss}')
```

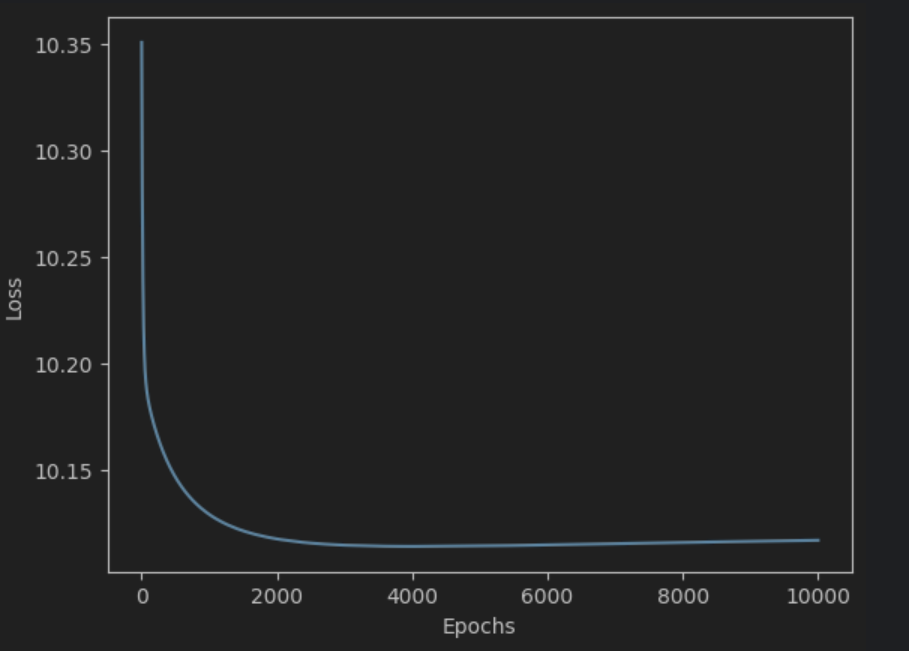
损失函数的变化如下：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-8e27102f5d910a525d54dd715e328e453fd78201%2FCBOW-LOSS.png?alt=media" alt=""><figcaption><p>CBOW-LOSS</p></figcaption></figure>

```python
# 获取嵌入
fig, ax = plt.subplots()
for word, idx in word_to_idx.items():
    embedding = cbow_model.input_layer(make_one_hot_encoding(word, word_to_idx)).detach().numpy()
    ax.scatter(embedding[0], embedding[1])
    ax.annotate(word, (embedding[0], embedding[1]))
plt.show()
```

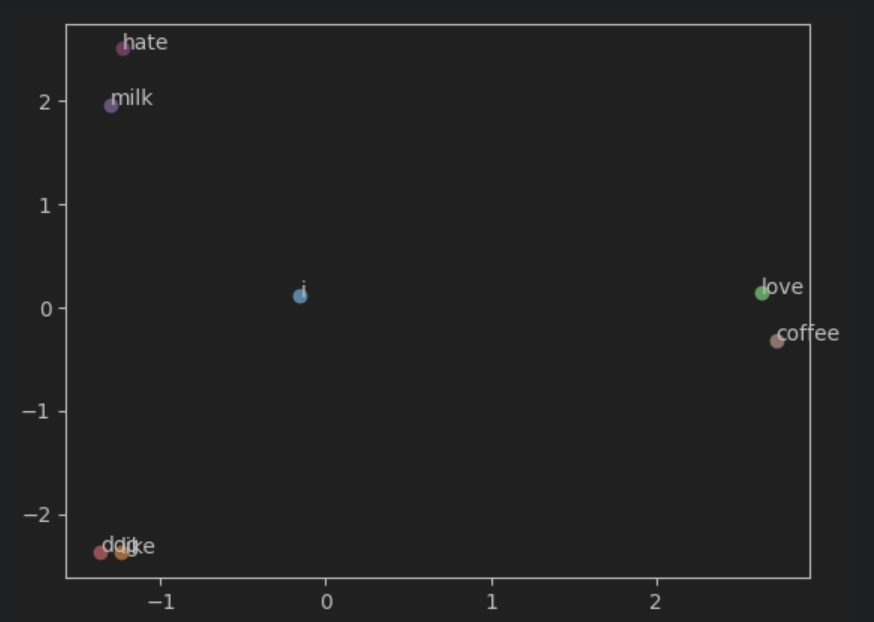
结果如下：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-2a911ea1c2bbedf7630b492b372b6b9dc68173ec%2FCBOW-EMBEDDING.png?alt=media" alt=""><figcaption><p>CBOW-EMBEDDING</p></figcaption></figure>

#### 4.1.2 Skip-gram

* 原理
  * Skip-gram通过当前词来预测周围的词。输入为一个中心词的词向量，预测该词周围一定窗口大小内的上下文词。
* 实现方式
  * 输入层：中心词的one-hot编码
  * 隐藏层：通过权重矩阵将输入转为低维的密集向量
  * 输出层：为上下文中的每个词分配概率
* 优缺点
  * 优点：在处理小数据集上表现更好，尤其是在捕捉稀有词上。通常能够学习到更好更细致的词向量表示。

**4.1.2.1 Skip-gram的实现**

Skip-gram的实现与CBOW基本类似，只是输入和输出的处理方式不同，所以这里就不再赘述。

### 4.2 fastText

#### 4.2.1 分层softmax

sigmoid函数如下：

$$
\sigma(x) = \frac{1}{1+e^{-x}}
$$

sigmoid函数的输出是一个0到1之间的数，可以看作是一个概率值。

softmax函数如下：

$$
\sigma(x)*i = \frac{e^{x\_i}}{\sum*{j=1}^{n} e^{x\_j}}
$$

softmax函数计算的是某一项$$x\_i$$在所有项中出现的概率，分母计算时需要用到所有项的值，因此计算复杂度为$$O(n)$$。

分层softmax是一种加速softmax计算的方法，它其实就是利用多个sigmoid函数进行二分类来达到多酚类的效果。分层softmax的计算复杂度为$$O(log(n))$$。

#### 4.2.2 fastText的原理

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-97620372b1d7f8e2f225fa4dc7eedbf1e7c999be%2FFASTTEXT.jpg?alt=media" alt=""><figcaption><p>fastText</p></figcaption></figure>

fastText模型架构和word2vec中的CBOW十分类似。不同的是：

1. CBOW的输入是目标单词的上下文，而fastText的输入是多个单词及其字符级n-gram特征。word2vec把语料库中的每个单词看作一个原子单元，而fastText把每个单词看作字符级n-gram的集合。比如，对于单词`where`，fastText会考虑`<wh>`, `<he>`, `<er>`, `<re>`等n-gram特征。
2. fastText输出的是文档对应的类别，使用分层softmax来加速训练。

### 4.3 GloVe

GloVe（Global Vectors for Word Representation）与传统的词嵌入方法相比，不仅关注单词的共现次数，还考虑了单词之间的全局统计信息。

#### 4.3.1 共现矩阵

共现矩阵是一个$$V \times V$$的矩阵，其中$$V$$是词汇表的大小。矩阵的每个元素$$X\_{ij}$$表示单词$$i$$和单词$$j$$在上下文中共现的次数。

共现矩阵主要用于发现主题。滑动窗口的word-word共现矩阵可以挖掘语法和语义信息，例如：

```
I like deep learning
```

设置滑动窗口为2，可以得到以下共现矩阵：

|          | I | like | deep | learning |
| -------- | - | ---- | ---- | -------- |
| I        | 0 | 1    | 0    | 0        |
| like     | 1 | 0    | 1    | 0        |
| deep     | 0 | 1    | 0    | 1        |
| learning | 0 | 0    | 1    | 0        |

#### 4.3.2 共现矩阵与条件概率

对于一个单词$$i$$，一行表示其它单词在$$i$$的上下文中出现的次数。条件概率$$P(j|i)$$表示单词$$j$$在单词$$i$$的上下文中出现的概率。

我们定义两个条件概率的比值为：

$$
ratio\_{i,j,k} = \frac{P(k|i)}{P(k|j)}
$$

指的是单词$$k$$在单词$$i$$的上下文中出现的概率与单词$$k$$在单词$$j$$的上下文中出现的概率的比值。这在一定程度上反映了单词$$i$$和单词$$j$$的相似性。

$$ratio\_{i,j,k}$$的普遍规律为：

|              | 单词$$j,k$$相关 | 单词$$j,k$$不相关 |
| ------------ | ----------- | ------------ |
| 单词$$i,k相关$$  | 接近1         | 远大于1         |
| 单词$$i,k不相关$$ | 远小于1        | 接近1          |

#### 4.3.3 词向量和共现矩阵的近似关系

那么，可以通过学习获得词向量，是的词向量的表征计算出来的条件概率比值接近于共现矩阵的条件概率比值。

假设$$g(w\_i, w\_j, \tilde{w}\_k) = \frac{P(k|i)}{P(k|j)}$$，其中$$w\_i, w\_j, \tilde{w}\_k$$分别是单词$$i, j, k$$的词向量。

损失函数是二者的均方误差：

$$
J = \sum\_{i,j,k}^{N} (\frac{P(k|i)}{P(k|j)} - g(w\_i, w\_j, \tilde{w}\_k))^2
$$

接下来需要合理推测$$g(w\_i, w\_j, \tilde{w}\_k)$$的形式。

1. 在线性空间中考量两个单词的相似性，可以使用$$w\_i - w\_j$$，因此$$g(w\_i, w\_j, \tilde{w}\_k)$$中可能包含这一项
2. $$ratio$$是一个标量，因此$$g(w\_i, w\_j, \tilde{w}\_k)$$可能是一个内积，即$$(w\_i - w\_j)^T \tilde{w}\_k$$
3. 由于$$ratio$$是一个比值，因此可以在外面套一层指数函数，即$$\exp((w\_i - w\_j)^T \tilde{w}\_k)$$

因此：

$$
g(w\_i, w\_j, \tilde{w}\_k) = \frac{P(k|i)}{P(k|j)} = \frac{exp(w\_i^T \tilde{w}\_k)}{exp(w\_j^T \tilde{w}\_k)}
$$

因此，GloVe的目标是学习一个词向量矩阵$$W$$，使得词向量之间的内积等于共现矩阵的对数值：

$$
W\_i^T \tilde{W}\_j + b\_i + \tilde{b}*j = \log(X*{ij})
$$

其中，$$W\_i$$和$$\tilde{W}\_j$$分别是单词$$i$$和单词$$j$$的词向量，$$b\_i$$和$$\tilde{b}\_j$$是偏置项。

GloVe的损失函数为：

$$
J = \sum\_{i, j=1}^{V} f(X\_{ij})(W\_i^T \tilde{W}\_j + b\_i + \tilde{b}*j - \log(X*{ij}))^2
$$

其中，$$f(X\_{ij})$$是权重函数，用于平衡高频词和低频词的权重。我们希望：

* 高频共现的单词的权重要大于低频共现的单词，因此这个函数是非递减的
* 但是这个权重不应过大，在到达一定阈值后应该不再增加
* 如果两个单词没有在一起出现，则权重应该为0，它们不应该参与损失函数的计算

因此，一个常用的权重函数为：

$$
f(X\_{ij}) = \begin{cases} (X\_{ij}/X\_{max})^\alpha & X\_{ij} < X\_{max} \ 1 & X\_{ij} \geq X\_{max} \end{cases}
$$

除开权重函数，loss函数的其它部分则是一个标准的均方误差。

#### 4.3.3 手撕GloVe

TODO: 可以阅读mittens Glove源码

## 参考资料

1. <https://www.jiqizhixin.com/articles/2018-12-03-6>
2. <https://zhuanlan.zhihu.com/p/568064512>
3. <https://zhuanlan.zhihu.com/p/79573970>
4. <https://blog.csdn.net/Magical\\_Bubble/article/details/89160032>
5. <https://zhuanlan.zhihu.com/p/58389508>


# 深度学习基础


# LLM基础

###


# 思考模式切换

当前业界主流推理模型主要采用三种不同的技术路线来实现思考模式的切换：

#### 1 硬分叉

通过维护独立的模型权重来实现模式区分，简单来说，就是两个不同的模型，一个能够思考，一个不能。例如25年7月后，Qwen3被划分为两种模型：Qwen3-Instruct-2507 and Qwen3-Thinking-2507。

这两类模型一般会使用不同的监督微调（SFT）数据和强化学习（RL）策略分别训练。思考模型会强制模型输出由`<think>`标签包裹的推理链；而非思考模型则通过指令微调压制思考行为，直接生成最终答案。

#### 2 软切换

软切换机制允许同一模型通过提示词或参数动态切换行为模式。早期的Qwen3提供`/think`和`/no_think`指令配合`enable_thinking`参数；DeepSeek-V3.1则通过修改对话模板实现切换。

该路线依赖训练数据的混合策略：同时包含带`<think>`标签和不带标签的SFT数据，使模型学会根据指令选择生成模式。具体实现中常采用模板约束技术，例如通过预填充空的思考块强制模型跳过推理阶段：

```
messages = [
    {"role": "user", "content": "问题 /no_think"},
    {"role": "assistant", "content": "<think>\n\n</think>\n"}
]
```

这种方法利用Transformer的因果注意力机制，使模型基于已生成的空思考块判断"思考阶段已完成"，直接进入答案生成。\
软切换机制的优势在于部署成本（仅需加载一套权重）、多轮对话灵活性（支持逐轮切换思考模式），以及API兼容性（保持统一接口格式）。

#### 3 动态计算预算

动态计算预算架构在同一模型内通过参数控制测试时计算量（Test-Time Compute）。Claude-4通过API参数调节"thinking efforts"量级；Kimi k1.5则采用"Long2Short"技术，通过长思维链蒸馏实现可变深度推理。该路线的底层原理涉及强化学习对思考深度的控制：在RL阶段引入思考长度奖励，训练模型根据问题难度自适应调整推理步数。同时通过`max_tokens`、`temperature`或专门的`thinking_budget`参数物理限制推理token数量。Kimi k1.5的Long2Short技术进一步将长思维链知识蒸馏到短思维链，实现可伸缩推理。

这种设计追求认知一致性（避免能力割裂）、粒度控制（精细调节思考强度），以及效率优化（简单任务自动缩短思考长度，复杂任务自动扩展）。

#### 4 训练阶段的差异

不同模型在SFT和RL阶段植入思考行为的方式存在差异：

* DeepSeek-R1采用纯RL驱动策略，不提供思考过程数据，让模型自主探索`<think>`标签的使用方式
* Qwen3采用SFT混合数据加RLHF，人工构造带/不带思考标签的并行数据，显式教授模式切换指令
* Claude-4则采用可变长度RL，奖励函数同时考虑答案正确性和思考效率（以最少步骤获得正确答案）。


# 为什么现在的LLM都是decoder-only架构

### 先搞清楚三种架构

Transformer原论文提出的是Encoder-Decoder架构，后来演化出三条路线：

| 架构                  | 代表模型                         | 注意力机制                       | 典型任务          |
| ------------------- | ---------------------------- | --------------------------- | ------------- |
| **Encoder-Only**    | BERT, RoBERTa                | 双向注意力（每个token能看到所有token）    | 分类、NER、语义理解   |
| **Encoder-Decoder** | T5, BART, Flan-T5            | Encoder双向 + Decoder因果       | 翻译、摘要、seq2seq |
| **Decoder-Only**    | GPT系列, LLaMA, Qwen, DeepSeek | 因果注意力（每个token只能看到它之前的token） | 文本生成、对话、推理    |

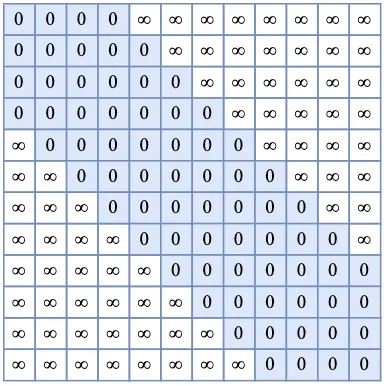
三者的核心区别在于**注意力掩码**：Encoder-Only用全连接注意力，Decoder-Only用下三角因果掩码，Encoder-Decoder两者都用。

### Decoder-Only为什么赢了

#### 1. 训练效率：Next Token Prediction的暴力美学

Decoder-Only的训练目标极其简单——给定前面所有token，预测下一个token。这个目标有一个关键优势：**序列中的每一个位置都是一个训练样本**。

一条长度为 N 的序列，一次前向传播就能产生 N−1 个训练信号。而Encoder-Decoder架构中，Encoder端的表示学习依赖Decoder的梯度回传，信号传递路径更长，Encoder部分的参数利用效率相对较低。

BERT那种Masked Language Model（随机遮15%的token去预测）每条样本只有15%的位置产生损失，训练信号的密度远低于自回归目标。

#### 2. 扩展性：大力出奇迹的最佳载体

Scaling Law（Kaplan et al., 2020; Hoffmann et al., 2022）反复验证了一件事：**模型越大、数据越多、算力越多，性能就越好**，而且这个关系是可预测的幂律。

Decoder-Only架构在scaling上有天然优势：

* **架构极简**。只有一个组件（堆叠的Transformer Decoder Block），没有Encoder-Decoder之间的cross-attention，超参数更少，调参空间更小，更容易找到最优配置。
* **参数全部集中在一个模块**。不存在"Encoder分多少层、Decoder分多少层"的分配问题。Raffel et al.（T5论文）做过大量实验，发现Encoder-Decoder在总参数量相同时，并不比Decoder-Only有明显优势，但调参成本高得多。
* **训练基础设施更容易优化**。单一结构意味着更规整的计算图，更容易做tensor并行、pipeline并行、序列并行等分布式策略。

当你要训练万亿参数的模型时，架构的简洁性直接决定工程可行性。

#### 3. 涌现能力：Zero-shot和In-context Learning

GPT-2/GPT-3揭示了一个关键现象：**足够大的自回归语言模型天然具备in-context learning能力**——不需要微调，只需要在prompt里给几个例子，模型就能学会新任务。

这种能力对Decoder-Only特别友好，因为：

* 自回归本身就是一个序列建模过程，prompt里的few-shot examples和实际任务的boundary是模糊的，模型可以无缝地从"理解例子"过渡到"执行任务"。
* BERT类模型的\[MASK]预测范式很难自然地做生成式的in-context learning。
* Encoder-Decoder架构虽然也能做（Flan-T5表现不错），但需要额外的工程设计来处理输入输出的边界。

当in-context learning成为LLM最重要的能力之一后，Decoder-Only就成了天然的最佳选择。

#### 4. 统一范式：一切皆生成

Decoder-Only把所有任务都转化为文本生成：

* 分类 → 生成类别名
* 翻译 → 生成目标语言文本
* 问答 → 生成答案
* 推理 → 生成推理链 + 答案
* 代码 → 生成代码

这种**统一性**意味着：

* 一个模型、一套训练流程、一个推理接口就能覆盖几乎所有NLP任务
* 不需要为每个任务设计特定的head或loss
* 多任务训练变得trivial——只要把不同任务的数据混在一起训就行

相比之下，BERT时代每换一个任务就要加一个分类头再微调，这在LLM时代已经显得笨拙。

#### 5. 推理效率：KV Cache的天然适配

自回归生成时，Decoder-Only可以使用**KV Cache**——已生成token的Key和Value缓存下来，每一步只需要计算新token的注意力，复杂度从 O(n2) 降到 O(n)。

这个优化对Decoder-Only来说是天然的，因为因果掩码保证了已有token的表示不会因为后续token的出现而改变。Encoder-Only或Encoder-Decoder的双向注意力部分无法直接使用这个trick，因为每个新token理论上会改变所有已有token的表示。

在实际部署中，KV Cache是让LLM能以可接受延迟逐token流式输出的关键技术。

#### 6. 数据红利：互联网就是最大的自回归语料库

Next Token Prediction的训练数据就是**原始文本**——不需要标注、不需要配对、不需要人工设计mask策略。互联网上有数万亿token的文本，全都可以直接拿来训练。

Encoder-Decoder架构虽然也能用无监督数据预训练（T5用的是span corruption），但其天然适合的场景是有明确输入输出对的任务（翻译、摘要），这类配对数据的规模远小于纯文本。

当预训练数据从GB级别涨到TB级别时，能最高效利用纯文本数据的架构就是赢家。

### 一些常见疑问

#### Encoder-Decoder真的不行吗？

不是不行。Flan-T5、UL2等模型证明Encoder-Decoder在同等参数量下的表现可以很好，某些任务上甚至更好。但问题是：

1. 工程复杂度更高，scaling更难
2. 社区生态已经完全倾向Decoder-Only，工具链、推理框架、对齐技术（RLHF/DPO）都是为Decoder-Only设计的
3. 在绝对性能上，靠堆参数量的Decoder-Only最终还是会追上来

这是一个**技术选择 + 生态效应**共同导致的结果。

#### 双向注意力不是信息更丰富吗？

是的。理论上双向注意力能捕获更多上下文信息。但实践表明：

* 当模型足够大时，因果注意力通过建模足够长的上下文，也能隐式地学到"双向"的信息
* 在预训练阶段，自回归目标的训练信号密度更高（每个位置都有loss），弥补了单向性的信息损失
* 对于生成任务来说，因果注意力是天然匹配的，强行引入双向注意力反而需要额外处理

#### 有没有可能未来架构会变？

完全可能。一些值得关注的方向：

* **Mamba / State Space Models**：用线性复杂度替代注意力，但核心仍然是自回归生成
* **Mixture of Experts (MoE)**：如DeepSeek-V2/V3、Mixtral，在Decoder-Only基础上做稀疏激活，不改变基础范式
* **Diffusion-based LLM**：用扩散过程替代自回归，理论上可以并行生成，但目前还不成熟
* **Hybrid架构**：比如在Decoder-Only中引入少量双向attention层（部分研究在探索）

但至少目前，Decoder-Only的地位还非常稳固。

### 总结

Decoder-Only赢在**简洁、易扩展、与数据和任务的天然适配**。它不一定是理论上最优的架构，但它是工程实践中最实用的架构。在AI发展的当前阶段——数据充足、算力增长、scaling law有效——这种"大力出奇迹"的路线恰好需要一个最简洁的载体，Decoder-Only就是那个载体。

核心逻辑其实就一句话：**当你有足够的数据和算力时，最简单的方法往往最有效。**


# Prompt Engineering


# Tree of Thoughts

## TOT概述

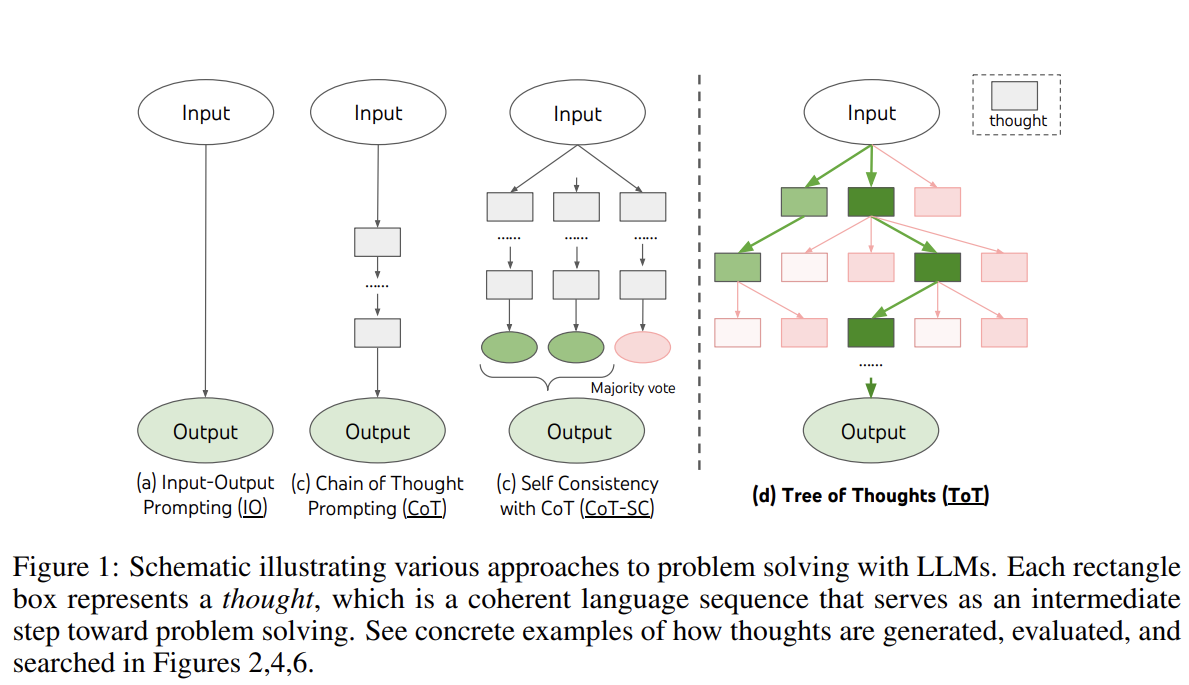
对于需要探索或预判战略的复杂任务来说，传统或简单的提示技巧是不够的。TOT通过构建并维护一颗思维树，引导语言模型将思维作为中间步骤来解决复杂问题。

LLM的自回归机制，从左到右逐个生成token并作出决策，这种简单的策略，似乎不能够让LLM成为通用的问题求解器。

人类在决策的时候有两种模式——快速、自动、无意识的"直觉"和缓慢、深思熟虑、有意识的"分析"。解决问题可以看作是在问题空间中搜索解空间的过程，将问题空间用树表示，每个节点代表解决问题的中间想法。有助于让LLM进行自我评估，并展示思维过程。

用LLM解决一般问题的两大不足可以用树结构来解决：

1. 没有探索思维过程中的不同延续——即树的分支
2. 没有融入任何类型的规划、探索或者预测

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-fd17e08355a67a40edfc18f503a90c4b8e60c9ff%2FTOT-1.png?alt=media" alt=""><figcaption><p>TOT</p></figcaption></figure>

## TOT实例

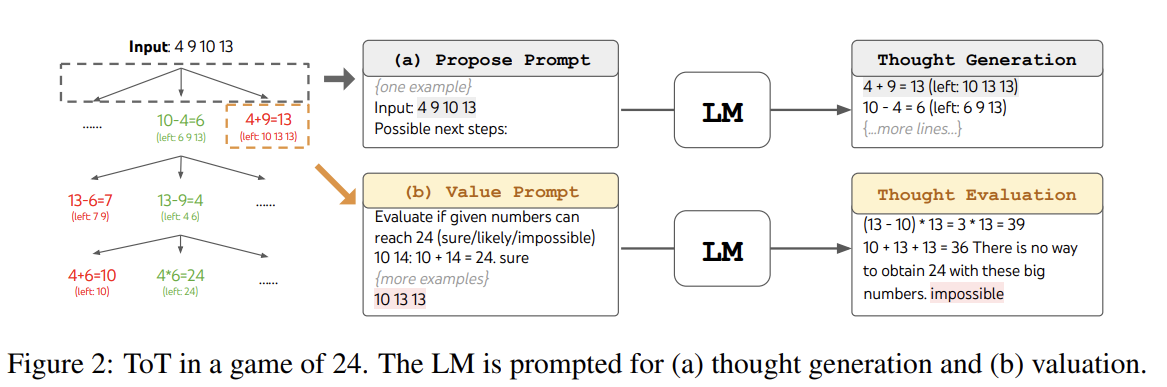
以算24点的游戏任务为例：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-75e9337c22d70d015b1b433c8d29302256960b6a%2FTOT-2.png?alt=media" alt=""><figcaption><p>Game of 24</p></figcaption></figure>

由于是4个数字做四则运算，因此可以分为3个思维步骤，每个步骤都保留最优的5个候选项。每次思维的候选项都要求LLM给出能否得到24点的评估：\
sure/maybe/possible

目的是得到经过少量向前尝试就可以验证正确（sure）的局部解，基于‘太大/太小’的常识消除那些不可能（impossible）的局部解，其余的局部解作为‘maybe’保留。

## 基于RL的TOT

<https://arxiv.org/abs/2305.08291>

## TOT提示法

<https://github.com/dave1010/tree-of-thought-prompting>

## 参考资料

1. <https://www.promptingguide.ai/zh/techniques/tot>
2. <https://arxiv.org/abs/2305.10601>


# Transformer


# Tokenizer

## 1 为什么LLM需要Tokenization

人类的幼崽在学会说话后，就已经有了对于这个世界的先验知识。比如，它知道“香蕉”是一种黄色的好吃的水果，它知道“水果”是什么，它能够利用已经学会的词汇解释新的词汇，它知道“香蕉”和“苹果”在潜在的表意空间中很接近。

但是，如果我们想要教会一个一无所知的机器去阅读文本、理解语义，我们是否还需要从单词开始教起？机器暂时还没有眼睛，所以我们无法拿着香蕉告诉它这是香蕉。但是，我们至少可以告诉它，“香蕉”是一个单独的词汇，这个句子应该这样读：“香蕉”是一种水果，而不是：香“蕉是”一种水果。

同时，我们希望尽可能多的告诉它人类语言的基本规律。

例如，“香蕉”可能经常和“苹果”一起出现（或者“牛奶”）。

对于没有任何语言结构知识的模型来说，直接输入一段文本无疑于输入一段乱码。

而我们希望像 BERT 或 GPT 这样的模型，在理解语义之前，首先需要在一个较低级别的层次上学习语法知识，这一点可以利用**特殊的结构设计**实现。

分词让我们更方便地做到以下两点：

* **将输入的长串文本转为更细粒度的划分，即token**
* **将输入转为向量，通过向量之间的关系表示词与词之间的关系，可以作为更高级别 NLP 任务（例如文本分类）的输入**

这样，使得输入的一段话，成为拥有上下文语义背景的一段话。例如：”香蕉是一种水果“。我们知道香蕉是什么，水果是什么（或者类似什么）。

## 2 分词粒度

在教会LLM说话之前，需要准备一个词表，要尽可能高效地表征人类语言的基础用法。因此，在评价分词粒度好坏的时候，一般是以下几个角度：

* 词表大小是否合适？
* 词表能否有效表征语义？

### 2.1 字符级别

一个字母（英文）或者一个字（中文）就是一个字符，每个字符作为一个token。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6b137bcbf8cefd6677c23d60e62710e969c87b0f%2FUntitled.png?alt=media" alt=""><figcaption><p>字符级别</p></figcaption></figure>

优点：

* 词表很小。像英文只有26个字符，中文用5000个常用汉字也能适用于大部分场景

缺点：

* 为每个字符学习嵌入向量时，每个向量容纳了太多的语义在内，表征能力不足
* 基本上没有利用词汇的边界信息和语义信息（然而对于中文来说一个字是有表意功能的，因此可以使用字符级别的分词，有时可能效果更好）
* 长文本需要一个超长的向量表示，容易遇到性能瓶颈

### 2.2 word级别

对于英文及拉丁语系的语言来说，词与词之间有着天然的空格作为分割。而对于中文来说，词与词之间连在一起，需要首先经过分词算法。

优点：

* 符合人类的阅读习惯，保留了词汇的边界信息和语义信息

缺点：

* 由于**长尾效应**，词汇表可能过于庞大
* 词表中的低频词/稀疏词在模型训练过程中无法得到充分训练，进而模型不能充分理解这些词的语义
* 仍然有很多新词，容易OOV(Out-of-vocabulary)
* 不同词性的词，比如”banana”和“bananas”很难得到有效的表示（无法理解关联性）

### 2.3 子词级别

subword/子词级，它介于字符和单词之间。是**当前最广泛的使用方法。**

统计每个词的词频。

1. 对于频率高的词，不进行拆分
2. 对于频率低的词，拆分成小的有意义的词
3. 对于后缀，一般前面会增加一个特殊标记，例如将`tokenization` 实际会拆成 `token` 和 `##ization` ，`##`标记`ization`是一个后缀

优点：

1. 用一个适量的词表大小几乎就可以表示所有词
2. 模型甚至可以理解没见过的词

缺点：

1. 无法解决单词拼写错误的问题

## 3 常用Tokenize算法

### 3.1 BPE

#### **Byte Pair Encoding**

步骤：

1. 准备足够大的语料库C
2. 定义好需要的词表大小V\_size
3. 将单词拆分成字符序列，在每个单词末尾添加后缀\</w>，并统计单词频率
   1. 停止符\</w>表明subword是词后缀，如`st` 不加 `</w>` 可以出现在词首，如 `st ar`；加了 `</w>` 表明该子词位于词尾，如 `we st</w>`，二者意义截然不同
4. 将语料库中所有单词拆分为单个字符，用所有单个字符建立最初的词典，并统计每个字符的频率，本阶段的 subword 的粒度是字符
5. 挑出频次最高的符号对 ，比如说 t 和 h 组成的 th，将新字符加入词表，然后将语料中所有该字符对融合，即所有 t 和 h 都变为 th。新字符依然可以参与后续的 merge，有点类似哈夫曼树，BPE 实际上就是一种贪心算法
6. 重复5操作，直到词表中单词数达到设定量V\_size或下一个最高频数为 1

**例子**

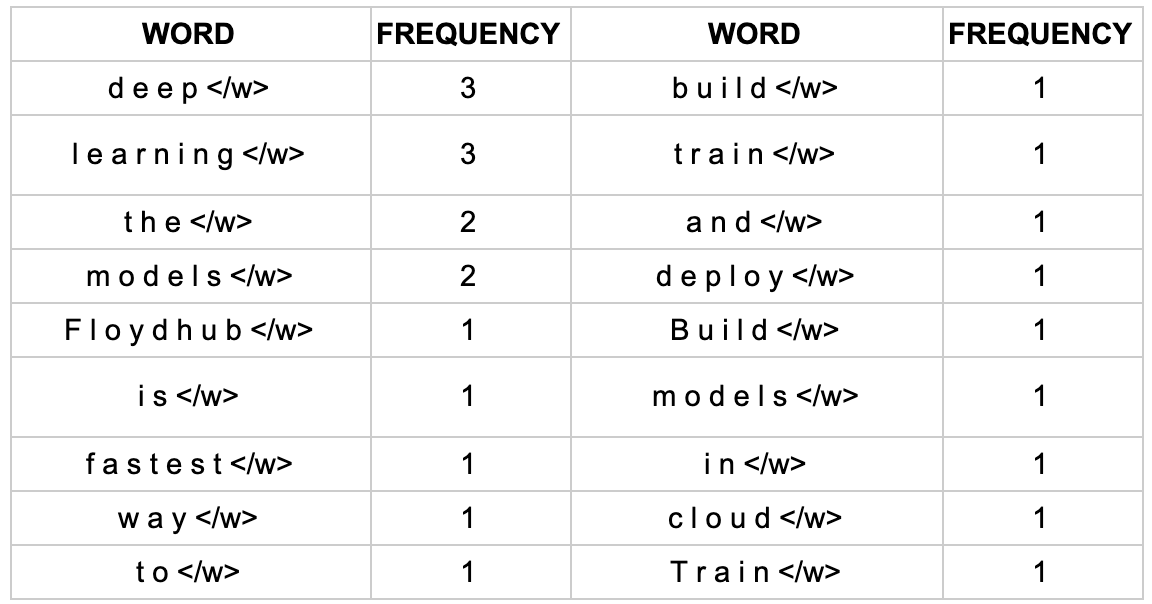
1. 获取语料库，这样一段话为例：“ FloydHub is the fastest way to build, train and deploy deep learning models. Build deep learning models in the cloud. Train deep learning models. ”
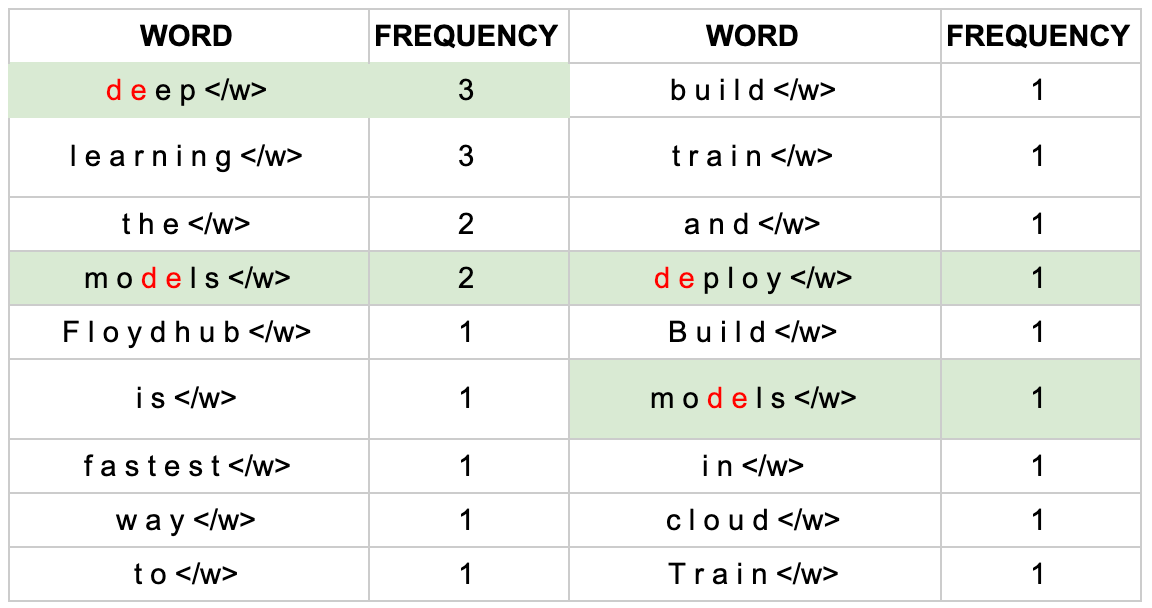
2. 拆分，加后缀，统计词频：

   <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-62105ed7ca57fd826addd0213a0997afddd8df72%2FBPE-1.png?alt=media" alt=""><figcaption><p>词频</p></figcaption></figure>
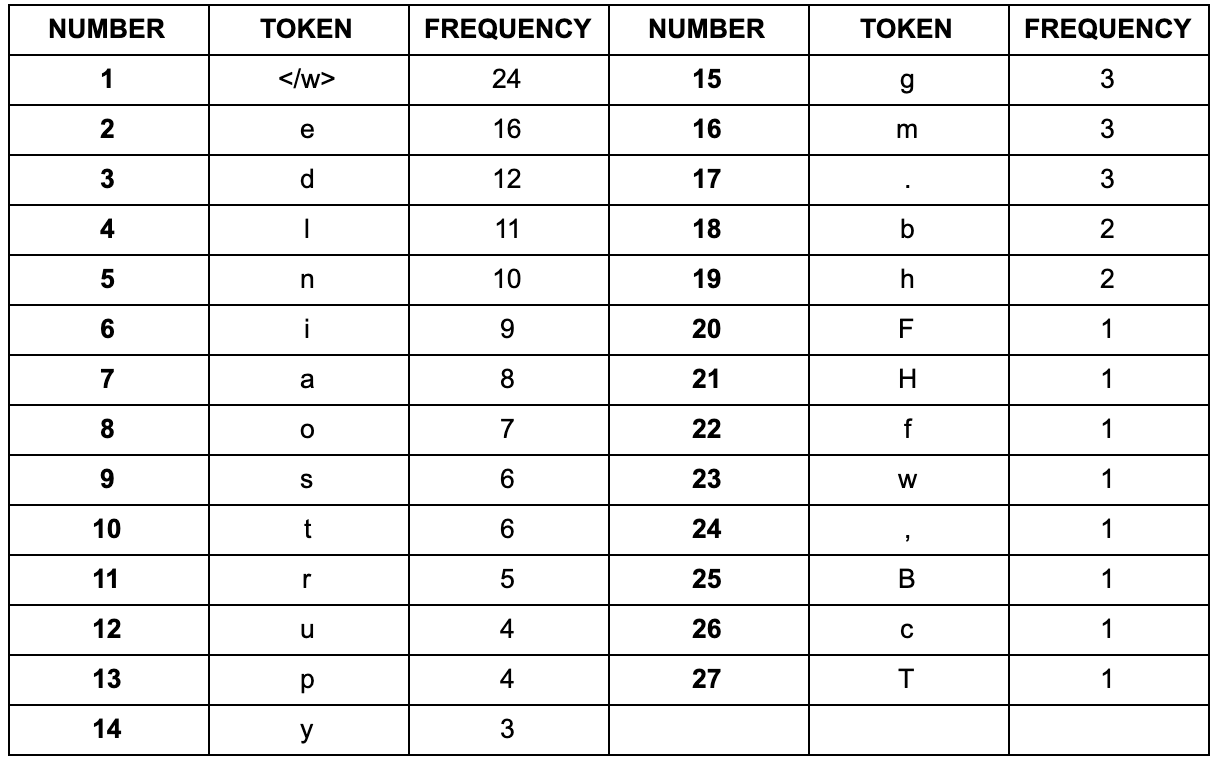
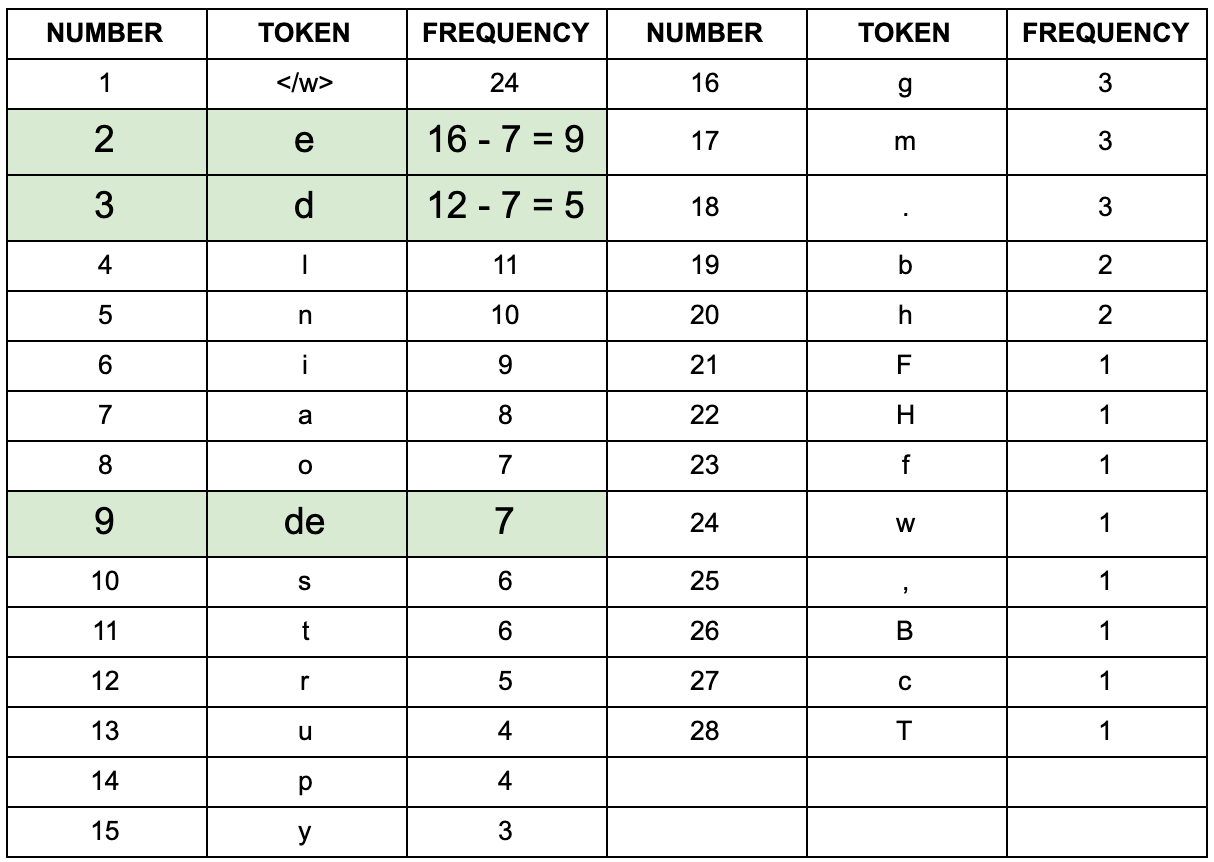
3. 建立词表，统计字符频率，排序：

   <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-9b2ca3fd3d77fca047e6af40e9994799be71fcd9%2FBPE-2.png?alt=media" alt=""><figcaption><p>字符频率</p></figcaption></figure>
4. 以第一次迭代为例，将字符频率最高的`d`和`e`替换为`de`，后面依次迭代：

   <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6db0a6799717f396c01e475e278a0cf955ed2c72%2FBPE-3.png?alt=media" alt=""><figcaption><p>第一次迭代</p></figcaption></figure>
5. 更新词表

   <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-a00bcdab82f395492168c4c76703e01e3c7f46de%2FBPE-4.png?alt=media" alt=""><figcaption><p>更新词表</p></figcaption></figure>

如果将词表大小设置为 10，最终的结果为：

```plaintext
d e
r n
rn i
rni n
rnin g</w>
o de
ode l
m odel
l o
l e
```

**优点**

* 可以很有效地平衡词典大小和编码步骤数。

随着合并的次数增加，词表大小通常先增加后减小。迭代次数太小，大部分还是字母，几乎就是字符级别的分词；迭代次数多，又变成了word级别的分词。所以词表大小要取一个中间值。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-3d66da1eabc5bca86d6d62dbdd7ee5765ffe30c1%2FBPE-5.png?alt=media" alt=""><figcaption><p>词表大小变化</p></figcaption></figure>

BPE 一般适用在欧美语言拉丁语系中，因为欧美语言大多是字符形式，涉及前缀、后缀的单词比较多。而中文的汉字一般不用 BPE 进行编码，因为中文是字无法进行拆分。对中文的处理通常只有分词和分字两种。理论上分词效果更好，更好的区别语义。分字效率高、简洁，因为常用的字不过 5000 字，词表更加简短。

#### **Byte-level BPE**

* Byte-level BPE使用原始字节作为基本 token，能够表示任意文本，避免OOV的情况。
* 可以与各种文本编码兼容，确保广泛的适用性

**实现**

* 调包

  ```python
  from tokenizers import Tokenizer, models, pre_tokenizers, decoders, trainers, processors

  # Initialize a tokenizer
  tokenizer = Tokenizer(models.BPE())

  # Customize pre-tokenization and decoding
  tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=True)
  tokenizer.decoder = decoders.ByteLevel()
  tokenizer.post_processor = processors.ByteLevel(trim_offsets=True)

  # And then train
  trainer = trainers.BpeTrainer(
     vocab_size=20000,
     min_frequency=2,
     initial_alphabet=pre_tokenizers.ByteLevel.alphabet()
  )
  tokenizer.train([
     'toy_data.txt'
  ], trainer=trainer)

  # And Save it
  tokenizer.save("byte-level-bpe.tokenizer.json", pretty=True)
  ```
* 手撕

  ```python
  import re, collections

  # 获取词表，在后面加上</w>作为词的结束符
  def get_vocab(filename):
     vocab = collections.defaultdict(int)
     with open(filename, 'r', encoding='utf-8') as f:
        for line in f:
           words = line.strip().split()
           for word in words:
              vocab[' '.join(list(word)) + ' </w>'] += 1
     return vocab

  # 统计词频
  def get_stats(vocab):
     pairs = collections.defaultdict(int)
     for word, freq in vocab.items():
        symbols = word.split()
        for i in range(len(symbols)-1):
           pairs[symbols[i], symbols[i+1]] += freq
     return pairs

  # 合并词表
  def merge_vocab(pair, v_in):
     v_out = {}
     # 对特殊字符转义
     bigram = re.escape(' '.join(pair))
     # 对于每个词，将pair合并
     p = re.compile(r'(?<!\S)' + bigram + r'(?!\S)')
     for word in v_in:
        w_out = p.sub(''.join(pair), word) # 替换，不再出现空格
        v_out[w_out] = v_in[word]
     return v_out

  # 获取最终词表
  def get_tokens(vocab):
     tokens = collections.defaultdict(int)
     for word, freq in vocab.items():
        word_tokens = word.split()
        for token in word_tokens:
           tokens[token] += freq
     return tokens

  # 训练
  def train_bpe(filename, num_merges):
     vocab = get_vocab(filename)
     for i in range(num_merges):
        pairs = get_stats(vocab)
        if not pairs:
           break
        best = max(pairs, key=pairs.get)
        vocab = merge_vocab(best, vocab)
     tokens = get_tokens(vocab)
     return tokens
  ```

### 3.2 WordPiece

与BPE思想类似，WordPiece在开始时也是按照字符级别初始化一个词表。

最大的区别在于选择两个子词进行合并的规则： BPE 按频率，WordPiece 按能够使得 LM 概率最大的相邻子词加入词表

概率计算方式：

$$score = \frac{freq\_{pair}}{freq\_{first\_element} \times freq\_{second\_element}}$$

WordPiece倾向于融合那些，各自的子部分在词表中更少出现的组合。

例如：尽管("un", "##able")出现的次数很多，但是WordPiece不会选择融合，因为有很多un和很多able在其它地方出现，保持它们的独立能够更好地表征语意。相反，像("hu", "##gging")这样的组合更容易被融合。

和BPE的另一个区别在于推理阶段的分词方式。 WordPiece最后仅仅保存最终的词表，而BPE保留了融合的规则。WordPiece会根据首字母找到最长的subword进行分割，而BPE则是根据保留的规则进行分割。 举个例子，对于`hugs`，最长的subword是`hug`，因此WordPiece会将其分割为`hug`和`s`，而BPE则会将其分割为`hu`和`gs`。

**实现**

* 调包

  ```python
  from tokenizers import Tokenizer, models, pre_tokenizers, decoders, trainers, processors

  # Initialize a tokenizer
  tokenizer = Tokenizer(models.WordPiece())

  # Customize pre-tokenization and decoding
  tokenizer.pre_tokenizer = pre_tokenizers.Whitespace()
  tokenizer.decoder = decoders.WordPiece()
  tokenizer.post_processor = processors.TemplateProcessing(
     single="<s> $A </s>",
     special_tokens=[
        ("<s>", 0),
        ("</s>", 1)
     ]
  )

  # And then train
  trainer = trainers.WordPieceTrainer(
     vocab_size=20000,
     min_frequency=2
  )
  tokenizer.train([
     'toy_data.txt'
  ], trainer=trainer)

  # And Save it
  tokenizer.save("wordpiece.tokenizer.json", pretty=True)
  ```
* 手撕

  ```python
  import re, collections


  # 获取词表
  def get_vocab(filename):
     vocab = collections.defaultdict(int)
     with open(filename, 'r', encoding='utf-8') as f:
        for line in f:
              words = line.strip().split()
              for word in words:
                 vocab[word] += 1
     return vocab

  vocab = get_vocab('README.md')
  print(vocab)


  # 获取alphabet
  def get_alphabet(vocab):
     alphabet = set()
     for word in vocab.keys():
        alphabet.add(word[0])
        for letter in word[1:]:
              alphabet.add(f"##{letter}") # 用##代表非首字母
     return alphabet

  alphabet = get_alphabet(vocab)
  print(alphabet)

  splits = {
     word: [c if i == 0 else f"##{c}" for i, c in enumerate(word)]
     for word in vocab.keys()
  }
  print(splits)


  def compute_pair_scores(splits):
     letter_freqs = collections.defaultdict(int)
     pair_freqs = collections.defaultdict(int)
     for word, freq in vocab.items():
        split = splits[word]
        if len(split) == 1:
              letter_freqs[split[0]] += freq
              continue
        for i in range(len(split) - 1):
              pair = (split[i], split[i+1])
              pair_freqs[pair] += freq
              letter_freqs[split[i]] += freq
        letter_freqs[split[-1]] += freq
     scores = {
        pair: freq / letter_freqs[pair[0]] / letter_freqs[pair[1]]
        for pair, freq in pair_freqs.items()
     }
     return scores

  pair_scores = compute_pair_scores(splits)
  print(pair_scores)

  def merge_pair(pair, splits):
     a, b = pair
     for word in vocab:
        split = splits[word]
        if len(split) == 1:
              continue
        i = 0
        while i < len(split) - 1:
              if split[i] == a and split[i + 1] == b:
                 merge = a + b[2:] if b.startswith("##") else a + b
                 split = split[:i] + [merge] + split[i + 2:]
              else:
                 i += 1
        splits[word] = split
     return splits

  def train(vocab, splits, vocab_size):
     while len(vocab) < vocab_size:
        pair_scores = compute_pair_scores(splits)
        best = max(pair_scores, key=pair_scores.get)
        if pair_scores[best] <= 1:
              break
        splits = merge_pair(best, splits)
        vocab = get_vocab(splits)
     return vocab, splits
  ```

### 3.3 Unigram

与BPE和WordPiece不同的是，Unigram的词表是从大到小变化的。 即先初始化一个大词表（可以用词频或者BPE初始化），根据评估准则不断丢弃词表，直到满足限定条件。Unigram 算法考虑了句子的不同分词可能，因而能够输出带概率的多个子词分段。 评判标准：Unigram loss 尝试删去一个 token，并计算对应的 unigram loss，删除使得 loss 增加最少的 token，因为它们可能是“最不被需要的”。 这个过程的计算量可能很大，所以我们可以一次移除p%的token，p是一个可以设置的超参，通常为10或20。 假设我们已经算得了词频：

```python
("hug", 10), ("pug", 5), ("pun", 12), ("bun", 4), ("hugs", 5)
```

并获得了所有substring

```python
["h", "u", "g", "hu", "ug", "p", "pu", "n", "un", "b", "bu", "s", "hug", "gs", "ugs"]
```

在Unigram模型中，我们假设每个token都是独立的，依据前面n个token推测第n+1个token的概率就是第n+1个token的概率。 概率则是由词频决定的，因此

$$
P(token) = \frac{freq(token)}{total\_freq}
$$

其中， $$total\_freq$$是所有token的词频之和。 给定一个单词，我们可以计算其概率：

$$
P(\["p", "u", "g"]) = P("p") \times P("u") \times P("g")
$$

$$
P\["pu", "g"] = P("pu") \times P("g")
$$

一个单词会被tokenize成概率最高的情况。

```python
["p", "u", "g"] : 0.000389
["p", "ug"] : 0.0022676
["pu", "g"] : 0.0022676
```

那么，"pug"会被分成"p"和"ug"或者"pu"和"g"。

loss计算

$$
loss = -\sum\_{i=1}^{n} log(P(token\_i))
$$

```python
"hug": ["hug"] (score 0.071428)
"pug": ["pu", "g"] (score 0.007710)
"pun": ["pu", "n"] (score 0.006168)
"bun": ["bu", "n"] (score 0.001451)
"hugs": ["hug", "s"] (score 0.001701)
```

所有loss是：

$$
10 \* (-log(0.071428)) + 5 \* (-log(0.007710)) + 12 \* (-log(0.006168)) + 4 \* (-log(0.001451)) + 5 \* (-log(0.001701)) = 169.8
$$

我们需要计算移除每个token后对于loss的影响，然后移除使得loss增加最少的token。

实现

* 调包

  ```python
  from tokenizers import Tokenizer, models, pre_tokenizers, decoders, trainers, processors

  # Initialize a tokenizer
  tokenizer = Tokenizer(models.Unigram())

  # Customize pre-tokenization and decoding
  tokenizer.pre_tokenizer = pre_tokenizers.Whitespace()
  tokenizer.decoder = decoders.Unigram()

  # And then train
  trainer = trainers.UnigramTrainer(
     vocab_size=20000,
     min_frequency=2
  )
  tokenizer.train([
     'toy_data.txt'
  ], trainer=trainer)

  # And Save it
  tokenizer.save("unigram.tokenizer.json", pretty=True)
  ```
* 手撕

  ```python
  from math import log

  # 示例语料库
  corpus = [
     "This is the Hugging Face Course.",
     "This chapter is about tokenization.",
     "This section shows several tokenizer algorithms.",
     "Hopefully, you will be able to understand how they are trained and generate tokens."
  ]

  # 计算词频
  word_freqs = defaultdict(int)
  for text in corpus:
     words = text.split()
     for word in words:
        word_freqs[word] += 1

  # 初始化字符和子词频率
  char_freqs = defaultdict(int)
  subwords_freqs = defaultdict(int)

  for word, freq in word_freqs.items():
     for i in range(len(word)):
        char_freqs[word[i]] += freq
     for j in range(i + 2, len(word) + 1):
        subwords_freqs[word[i:j]] += freq

  # 排序并创建初始词汇
  sorted_subwords = sorted(subwords_freqs.items(), key=lambda x: x[1], reverse=True)
  token_freqs = list(char_freqs.items()) + sorted_subwords[:300 - len(char_freqs)]
  token_freqs = {token: freq for token, freq in token_freqs}

  # 计算概率模型
  total_sum = sum(freq for token, freq in token_freqs.items())
  model = {token: -log(freq / total_sum) for token, freq in token_freqs.items()}

  # Viterbi 算法进行标记化
  def encode_word(word, model):
     best_segmentations = [{"start": 0, "score": 1}] + [{"start": None, "score": None} for _ in range(len(word))]
     
     for start_idx in range(len(word)):
        best_score_at_start = best_segmentations[start_idx]["score"]
        for end_idx in range(start_idx + 1, len(word) + 1):
              token = word[start_idx:end_idx]
              if token in model and best_score_at_start is not None:
                 score = model[token] + best_score_at_start
                 if best_segmentations[end_idx]["score"] is None or best_segmentations[end_idx]["score"] > score:
                    best_segmentations[end_idx] = {"start": start_idx, "score": score}

     segmentation = best_segmentations[-1]
     if segmentation["score"] is None:
        return ["<unk>"], None

     start = segmentation["start"]
     end = len(word)
     tokens = []
     while start != 0:
        tokens.insert(0, word[start:end])
        next_start = best_segmentations[start]["start"]
        end = start
        start = next_start
     tokens.insert(0, word[start:end])
     return tokens, segmentation["score"]

  # 测试标记化
  print(encode_word("Hopefully", model))
  print(encode_word("This", model))
  ```

### 3.4 SentencePiece

BPE，WordPiece，Unigram的缺点：

* 假设输入文本使用空格来分隔单词，如果不是则需要提前分词

为了解决这个问题：

* SentencePiece将输入视为输入字节流，包括空格
* 然后使用 Byte-level BPE 或 unigram 算法来构建适当的词汇表

## 4 应用与实践：训练古汉语Tokenizer并与Qwen Tokenizer融合

### 4.1 为什么要词表拓展

* 词表拓展可以提高模型的泛化能力，使得模型能够处理更多的未知词汇
* 词表拓展可以提高模型的性能，使得模型能够更好地处理特定领域的文本

例如，Llama3的Tokenizer使用的是SentencePiece，词表大小为128256，且大部分是英文。如果用Llama3的Tokenizer处理古汉语文本，基本上都会退化成字节级别的分词，这样会导致丢失部分语义信息。

以《离骚》中的一句为例：

```plaintext
荃不查余之中情兮，反信谗而齌怒。
```

```
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained(r'D:\Project\Meta-Llama-3-8B-Instruct', trust_remote_code=True)
print(len(tokenizer))
string = "荃不查余之中情兮，反信谗而齌怒。"
tokenized_string = tokenizer.tokenize(string)
tokenized_ids = tokenizer.convert_tokens_to_ids(tokenized_string)
tokenized_string_list = []
for token in tokenized_ids:
    tokenized_string_list.append(tokenizer.decode(token))
print(tokenized_string_list)
```

输出：

```plaintext
['�', '�', '不', '查', '余', '之', '中', '情', '�', '�', '，', '反', '信', '�', '�', '而', '�', '�', '怒', '。']
```

表现形式就是出现'�'。

如果我们需要训练一个古汉语专用的LLM（例如[XunziALLM](https://github.com/Xunzi-LLM-of-Chinese-classics/XunziALLM)），可能需要对它的Tokenizer进行拓展。

### 4.2 古汉语词表拓展

#### 4.2.1 准备语料

作为toy dataset，我们使用《离骚》全篇作为语料库，将其保存为`corpus.txt`。

#### 4.2.2 训练Tokenizer

```python
import time
import sentencepiece as spm

start_time = time.time()
spm.SentencePieceTrainer.train(
    input='corpus.txt',  # 输入文件
    model_prefix='lisao',  # 模型前缀
    shuffle_input_sentence=False,  # 是否打乱句子
    train_extremely_large_corpus=True,
    # hyperparameters of tokenizer
    max_sentence_length=16384,  # 句子最大长度
    pad_id=3,
    model_type="BPE",
    vocab_size=5000,
    split_digits=True,
    split_by_unicode_script=True,
    byte_fallback=True,
    allow_whitespace_only_pieces=True,
    remove_extra_whitespaces=False,
    normalization_rule_name="nfkc",
)

end_time = time.time()
print(end_time - start_time)
```

#### 4.2.3 与Llama3 Tokenizer融合

```python
from transformers import AutoTokenizer
import sentencepiece as spm

model_file = "lisao.model"

# 原生Llama3 Tokenizer
llama3_tokenizer = AutoTokenizer.from_pretrained(r'D:\Project\Meta-Llama-3-8B-Instruct', trust_remote_code=True)
# 自定义Tokenizer
lisao_tokenizer = spm.SentencePieceProcessor(model_file=model_file)

# print number of tokens
llama3_token_count = len(llama3_tokenizer)
lisao_token_count = lisao_tokenizer.GetPieceSize()
print(llama3_token_count, lisao_token_count)

# merge two tokenizers
llama3_token_set = set(llama3_tokenizer.get_vocab().keys())
print("Before merge:", len(llama3_token_set))

for i in range(lisao_token_count):
    token = lisao_tokenizer.id_to_piece(i)
    if token not in llama3_token_set:
        llama3_tokenizer.add_tokens(token)

llama3_token_set = set(llama3_tokenizer.get_vocab().keys())
print("After merge:", len(llama3_token_set))

# save the merged tokenizer
llama3_tokenizer.save_pretrained("lisao-llama3-tokenizer")
```

#### 4.2.4 性能测试

使用融合后的Tokenizer对《离骚》进行分词，输出为：

```
['荃不', '查余之中情', '兮', '，', '反信谗而', '�', '�', '怒', '。']
```

可以看到，'�'少了很多。

## 5 总结

* Transformer的输入是什么？
* Tokenize/分词的作用？
* 三种不同级别的Tokenizers及其优缺点
  * 字符级别
  * word级别
  * subword级别
* 四种Subword-based Tokenizers（拆分方法）
  * BPE/BBPE
  * WordPiece
  * Unigram
  * SentencePiece（使用BBPE或者Unigram）

## 6 参考资料

1. <https://cloud.tencent.com/developer/article/2317900>
2. <https://jinhanlei.github.io/posts/Transformers快速入门-二-用Tokenizer从零开始训练词表/>
3. <https://huggingface.co/learn/nlp-course/chapter6>
4. <https://github.com/QwenLM/Qwen/blob/main/tokenization\\_note\\_zh.md>


# Embeddings

## 1 为什么LLM需要Embedding

西瓜有很多特征，比如大小、颜色、重量等等，这些特征可以用一个向量表示，比如`[0.1, 0.2, 0.3]`。当然，它可以有无数的特征，但是如果只选择一些关键特征作为表征就已经足够了，即用低维向量表示高维特征。

LLM的输入是一个token序列，Embedding的作用是将词汇映射到向量空间，使得语义上相似的词汇在向量空间中也相近。Embedding是表示学习的一种形式，它允许模型从数据中自动学习到有用的特征表示，而不需要人为设计特征。

因此，Embedding的目的是：

* 数值化表示：将离散的高维数据映射到低维的连续向量空间。这个过程会生成由实数构成的向量，用于捕捉原始数据的潜在关系和结构。
* 捕捉语义信息：在训练过程中，模型会学习将具有相似含义或上下文的单词映射到相近的向量空间位置，使得向量之间的距离或夹角能够反映单词之间的语义相似度。
* 提取复杂特征：能够更全面地捕捉数据的复杂特征，使模型能够更好地学习并应用这些特征。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6d56622126777168f9ce5589577051b6691b914e%2FEMBEDDING-1.png?alt=media" alt=""><figcaption><p>Embedding</p></figcaption></figure>

## 2 Embedding分类

文本表示的类型：

* 基于one-hot、tf-idf等的bag-of-words：[Bag-of-words](/llm-everything/basics/machine-learning-basics/feature-extraction/text-representation-models/bag-of-words)
* 主题模型：LSA（SVD）、pLSA、LDA： [Topic Model](/llm-everything/basics/machine-learning-basics/feature-extraction/text-representation-models/topic-model)
* 基于词向量的固定表征：word2vec、fastText、glove： [Static Word Embeddings](/llm-everything/basics/machine-learning-basics/feature-extraction/text-representation-models/static-word-embeddings)
* 基于词向量的动态表征：ELMO、GPT、bert： [ELMO](/llm-everything/transformer/embeddings/elmo)、 [BERT](/llm-everything/transformer/embeddings/bert)、 [GPT](/llm-everything/transformer/embeddings/gpt)

LLM 的 Embedding 模型通常是**基于词向量的动态表征，**&#x662F;LLM模型架构本身的一部分，通常是输入层（有时也包括输出层）。在固定表征中，每个词都有一个固定的向量表示。但是在动态表征中，每个词的向量表示是根据上下文动态生成的。这种上下文感知的 embedding 能更好地捕捉词义的多样性。

## 参考资料

1. <https://developer.volcengine.com/articles/7389519179202134025>
2. <https://zhuanlan.zhihu.com/p/69521198>
3. <https://zhuanlan.zhihu.com/p/384452959>


# ELMO

## 1 ELMO模型结构

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-8a84acfae991968f409625fb031597f80b0f4c88%2FELMO-1.png?alt=media" alt=""><figcaption><p>ELMO</p></figcaption></figure>

输入的句子维度是$$B \times W \times C$$，其中$$B$$是batch size，$$W$$是句子长度，$$C$$是`max_characters_per_token`，即每个token的最大字符数，论文使用了固定值50。

经过Char Encoder Layer层后，输出的维度是$$B \times W \times D$$，其中$$D$$是`projection_dim`。ELMO是基于char的，所以会对每个单词内的所有char进行编码，得到这个单词的表示。Char Encoder Layer层输出一个句子在单词级别上的编码维度。

biLMs层是一个双向语言模型，分开训练了正向和反向的语言模型，而后将其特征进行拼接，最终得到的输出维度是$$(L+1) \times B \times W \times 2D$$，其中$$L$$是语言模型的层数，+1则是类似residual connection的操作，加上了初始的embedding层。

得到biLMs层的表征后，会经过一个混合层，会将前面的biLMs层的输出进行线性融合，得到最终的ELMO向量，维度为$$B \times W \times 2D$$。

### 1.1 Char Encoder Layer

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-79e48e4d4363286ba3e6977d5b94f7941b229eb1%2FELMO-2.png?alt=media" alt=""><figcaption><p>Char Encoder Layer</p></figcaption></figure>

1. Char Embedding。在一个较小的char词表中进行编码。输入的维度是$$B \times W \times C$$，首先被reshape成$$B*W \times C$$，然后经过embedding层，得到的维度是$$B*W \times C \times d$$，其中$$d$$是字符级别的embeddding。
2. Multi-Scale。使用不同scale的卷积层，在宽度上进行拓展，即输入都是一样的，卷积的kernel\_size和channel\_size不同，用于捕捉不同n-grams之间的信息。
3. Concat。将m个不同维度的矩阵进行拼接，得到的维度是$$B\*W \times m \times (d\_1 + d\_{2} + ... + d\_{m})$$。
4. Highway层。全连接+残差。
5. Linear映射。将输出的维度映射到$$B \times W \times D$$。

### 1.2 biLMs

ELMo主要是建立在biLMs（双向语言模型）上的。

给定一个有N个token的序列$$x = (t\_1, t\_2, ..., t\_N)$$，biLMs的目标是最大化下面的概率：

$$
p(t\_1, t\_2, ..., t\_N) = \prod\_{i=1}^{N} p(t\_i | t\_1, t\_2, ..., t\_{i-1}; \theta)
$$

在每一个位置$$i$$，模型都会在每一层预测一个上下文相关的表征$$h\_i^{LM}$$。顶层的输出$$h\_i^{LM}$$会被用来预测下一个token的概率。

而反向的语言模型跟正向一样，只是输入是相反的。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-441e95d620030cd811d6094bcdf6fa1851dfba32%2FELMO-3.png?alt=media" alt=""><figcaption><p>biLMs</p></figcaption></figure>

## 2 ELMO两阶段

ELMO是一个两阶段过程：

第一阶段：利用biLMs语言模型训练。

第二阶段：做下游任务时，从预训练网络中提取对应单词的网络各层的Word Embedding作为新特征补充到下游任务中。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FJseXynie9cybCsvi2oJo%2Fimage.png?alt=media&amp;token=4bf8058b-94e5-49e0-a1a0-2063cffc67fc" alt=""><figcaption></figcaption></figure>

输入文本后分别可以的得到三个特征：

1. E1：单词特征
2. E2：句法特征
3. E3：语义特征

之后给这三个Embedding分别一个权重（可以通过学习获得），加权整合成一个Embedding，作为下游任务的输入。

ELMO缺点（与BERT和GPT对比）：

1. LSTM抽取特征的能力远弱于Transformer
2. 拼接方式双向融合特征融合能力偏弱

## 3 ELMO代码实现

```python
import torch.nn as nn

class ELMo(nn.Module):
    def __init__(self, vocab_size, embedding_dim, hidden_dim, num_layers):
        super(ELMo, self).__init__()
        self.embedding = nn.Embedding(vocab_size, embedding_dim)
        self.lstm = nn.LSTM(embedding_dim, hidden_dim, num_layers, bidirectional=True)
        self.linear = nn.Linear(hidden_dim * 2, vocab_size)

    def forward(self, x):
        x = self.embedding(x)
        x, _ = self.lstm(x)
        x = self.linear(x)
        return x

vocab_size = len(vocab)
embedding_dim = 100
hidden_dim = 128
num_layers = 2
model = ELMo(vocab_size, embedding_dim, hidden_dim, num_layers)
```

## 参考

1. [从Word Embedding到Bert模型—自然语言处理中的预训练技术发展史 - 知乎](https://zhuanlan.zhihu.com/p/49271699)
2. <https://blog.csdn.net/weixin_42878111/article/details/131024910>
3. <https://blog.csdn.net/Magical_Bubble/article/details/89160032>


# BERT

### 1 BERT为什么叫BERT

BERT（Bidirectional Encoder Representations from Transformers）由 Google 于 2018 年推出，它的名字说明了一切：和ELMO相比，它的特征提取器是Transformer；和GPT相比，它又是双向LM建模的。

BERT的输入是一串 token 序列，该向量既可以随机初始化，也可以利用 Word2Vector等算法进行预训练以作为初始值。

输出有两种：

* 需要处理句子中的**每个单词/位置**（如找人名、判断每个词的词性） → 用 **`get_sequence_output()` →**&#x6574;个句子每一个token的向量表示，输出shape是\[batch\_size, seq\_length, hidden\_size]**→ 每个输入的token一个向量**
* 只需要给**整个句子/句子对打一个标签或分数**（如判断情感、判断两个句子是否相关） -> 用 **`get_pooled_output()` →**&#x8F93;出\[CLS]的表示，输出shape是\[batch size,hidden size]**→ 整个句子输出一个向量**

### 2 BERT的双向方法

如何才能在Transformer这个结构上做双向语言模型任务？

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-7d36eaa716e25e845fd2686174cc6336a4827be8%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

在Word2Vec的介绍中曾提到CBOW方法，就是选择一个单词，根据它的上文Context-Before和下文Context-after来预测。BERT采用了类似的方法来训练语言模型：

* 掩码语言模型 (Masked Language Model，MLM)
  * 选择语料中15%的单词
    * **80% 的概率：** 将被选中的词替换为 `[MASK]` 标志。
      * **示例：** `my dog is hairy` -> `my dog is [MASK]`
    * **10% 的概率：** 将被选中的词替换为一个随机的词。
      * **示例：** `my dog is hairy` -> `my dog is apple`
    * **10% 的概率：** 保持被选中的词不变。
      * **示例：** `my dog is hairy` -> `my dog is hairy`
  * **为什么这么做？**
    * 如果全部使用 `[MASK]`，模型在训练阶段会一直见到这个特殊标志，但在实际使用时却不会。训练与推理时不匹配。**引入随机词的作用**迫使模型不仅要学习上下文对词的表示，还要学习判断一个词在其上下文中是否合理。**保持原词**是为了告诉模型，即使是看起来正常的词，也可能是需要被预测的，迫使模型对整个序列的表示进行更细致的学习。
* 预测下一句 (Next Sentence Prediction，NSP)
  * 分两种情况选择两个句子
    * 一是选择语料中真正顺序相连的两个句子
    * 二是从语料库中随机选择一个句子拼到第一个句子后面
  * **为什么这么做？**

    很多NLP任务是句子关系判断任务，单词预测粒度的训练到不了句子关系这个层级，增加这个任务有助于下游句子关系判断任务。

#### 2.1 双向方法的优点

主要强调理解输入序列而不是生成输出序列，实现了对上下文的完整理解，对消除歧义有很大作用，为下游任务提供了更强大的语义表示。

### 3 BERT Embedding

BERT中的输入表示包括token embedding、segment embedding、position embedding三种，输入embedding由三种embedding相加得到。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-ecaed6017f69dc46667799114e8f93bf4a052140%2FBERT-1.png?alt=media" alt=""><figcaption><p>BERT Embedding</p></figcaption></figure>

1. Token Embeddings：输入的句子首先会被分词，然后每个词会被映射到一个词向量。最初的词向量是随机初始化的，然后会在训练过程中通过优化目标（如Masked Language Model）进行调整。
2. Segment Embeddings：BERT是为了处理句子对任务而设计的，因此在输入的时候会加入句子对的信息。对于一个句子对，BERT会在输入的时候加入一个特殊的标记，用来区分两个句子。第一个句子的segment embedding是全0，第二个句子的segment embedding是全1。
3. Position Embeddings：BERT没有使用RNN或CNN，因此没有位置信息。为了加入位置信息，BERT使用了位置编码。位置编码是一个维度为$$d\_{model}$$的向量，对于一个长度为$$L$$的句子，每个位置$$l$$都会有一个位置编码$$PE\_l$$，然后将Token Embeddings、Segment Embeddings和Position Embeddings相加，得到最终的BERT Embedding。BERT使用的是交替三角函数的位置编码。

### 4 BERT代码

```python
import torch.nn as nn

from .transformer import TransformerBlock
from .embedding import BERTEmbedding

class BERT(nn.Module):
    """
    BERT model : Bidirectional Encoder Representations from Transformers.
    """

    def __init__(self, vocab_size, hidden=768, n_layers=12, attn_heads=12, dropout=0.1):
        """
        :param vocab_size: vocab_size of total words
        :param hidden: BERT model hidden size
        :param n_layers: numbers of Transformer blocks(layers)
        :param attn_heads: number of attention heads
        :param dropout: dropout rate
        """

        super().__init__()
        self.hidden = hidden
        self.n_layers = n_layers
        self.attn_heads = attn_heads

        # paper noted they used 4*hidden_size for ff_network_hidden_size
        self.feed_forward_hidden = hidden * 4

        # embedding for BERT, sum of positional, segment, token embeddings
        self.embedding = BERTEmbedding(vocab_size=vocab_size, embed_size=hidden)

        # multi-layers transformer blocks, deep network
        self.transformer_blocks = nn.ModuleList(
            [TransformerBlock(hidden, attn_heads, hidden * 4, dropout) for _ in range(n_layers)])

    def forward(self, x, segment_info):
        # attention masking for padded token
        # torch.ByteTensor([batch_size, 1, seq_len, seq_len)
        mask = (x > 0).unsqueeze(1).repeat(1, x.size(1), 1).unsqueeze(1)

        # embedding the indexed sequence to sequence of vectors
        x = self.embedding(x, segment_info)

        # running over multiple transformer blocks
        for transformer in self.transformer_blocks:
            x = transformer.forward(x, mask)

        return x
```

### 参考

1. [技术详解：BERT的分词预处理、输入Embedding、中间编码与输出向量解析\_bert分词-CSDN博客](https://blog.csdn.net/xxue345678/article/details/141758926)
2. [从Word Embedding到Bert模型—自然语言处理中的预训练技术发展史 - 知乎](https://zhuanlan.zhihu.com/p/49271699)
3. [万字长文，带你搞懂什么是BERT模型（非常详细）看这一篇就够了！-CSDN博客](https://blog.csdn.net/star_nwe/article/details/143227601)
4. <https://github.com/codertimo/BERT-pytorch/blob/master/bert_pytorch/model/bert.py>
5. <https://zhuanlan.zhihu.com/p/403495863>


# GPT

### 1 GPT为什么叫GPT

GPT是一个单向语言模型，输入的句子是从左到右的，因此在训练的时候，每个位置的词都可以看到前面的词，但是不能看到后面的词。

GPT的全称是Generative Pre-trained Transformer。与 BERT 专注于“理解”不同，GPT 的目标是“生成”。可以将BERT理解为Transformer的Encoder，而GPT可以理解为Transformer的Decoder。

GPT也采用两阶段过程：

* 第一阶段使用LM进行预训练
* 第二阶段使用fine-tuning的方式处理下游任务

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-fb8cbcc12cd0737e16f904cec2e36f09f457dce0%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

GPT使用的是单项的语言模型：严格的“从左到右”的预测模式，通过 Decoder 内部使用 **Masked Self-Attention** 实现。与 BERT 复杂的 MLM 策略（`[MASK]`, `random`, `unchanged`）不同，GPT 的训练目标更加简单。通过大量数据，使得模型能够深入学习语言的内在结构和逻辑，从而获得了更好的生成能力。

### 2 GPT Embedding

输入 embedding 由 **token embedding** 和 **position embedding** 相加得到。

* **Token Embedding**：
  * 与 BERT 相同，GPT 首先构建一个固定大小的词汇表
  * 使用输入的 `input_ids` 在词汇表矩阵中查找每个 token 对应的向量
  * 输出 shape 为 `[batch_size, seq_length, embedding_size]`
* **Position Embedding**：
  * **绝对位置信息**：GPT 需要知道每个 token 在序列中的绝对位置，以理解词序
  * **学习嵌入向量**：与 BERT 类似，GPT 的位置嵌入也是通过模型在预训练过程中**学习**得到的。模型会创建一个位置嵌入矩阵，大小为 `[max_position_embeddings, embedding_size]`，`max_position_embeddings` 通常是一个固定的最大序列长度。无论输入序列内容是什么，第一个 token 总是加上第一个位置的嵌入向量，第二个 token 总是加上第二个位置的嵌入向量，以此类推。

### 3 GPT代码实现

```python
import torch
import torch.nn as nn
from .transformer import TransformerBlock

class GPTEmbedding(nn.Module):
    """
    GPT Embedding which is consisted with Token and Position Embedding.
    """
    def __init__(self, vocab_size, embed_size, max_len=512, dropout=0.1):
        """
        :param vocab_size: total vocab size
        :param embed_size: embedding size of token embedding
        :param max_len: max sequence length
        """
        super().__init__()
        self.token = nn.Embedding(vocab_size, embed_size)
        self.position = nn.Embedding(max_len, embed_size)
        self.dropout = nn.Dropout(p=dropout)
        self.embed_size = embed_size

    def forward(self, sequence):
        # sequence: [batch_size, seq_length]
        batch_size, seq_len = sequence.size()
        
        # position_ids: [0, 1, 2, ..., seq_len-1] repeated for batch_size times
        position_ids = torch.arange(seq_len, dtype=torch.long, device=sequence.device)
        position_ids = position_ids.unsqueeze(0).expand_as(sequence)
        
        # Summing token and position embeddings
        token_embeddings = self.token(sequence)
        position_embeddings = self.position(position_ids)
        
        embedding = token_embeddings + position_embeddings
        return self.dropout(embedding)

class GPT(nn.Module):
    """
    GPT model: Generative Pre-trained Transformer.
    """

    def __init__(self, vocab_size, hidden=768, n_layers=12, attn_heads=12, dropout=0.1):
        """
        :param vocab_size: vocab_size of total words
        :param hidden: GPT model hidden size
        :param n_layers: numbers of Transformer blocks(layers)
        :param attn_heads: number of attention heads
        :param dropout: dropout rate
        """
        super().__init__()
        self.hidden = hidden
        self.n_layers = n_layers
        self.attn_heads = attn_heads

        # paper noted they used 4*hidden_size for ff_network_hidden_size
        self.feed_forward_hidden = hidden * 4

        # embedding for GPT, sum of positional and token embeddings
        self.embedding = GPTEmbedding(vocab_size=vocab_size, embed_size=hidden)

        # multi-layers transformer blocks, deep network
        # NOTE: TransformerBlock here is a Decoder-style block with Masked Self-Attention
        self.transformer_blocks = nn.ModuleList(
            [TransformerBlock(hidden, attn_heads, hidden * 4, dropout) for _ in range(n_layers)])
        
        # Final linear layer to project to vocab size
        self.output_layer = nn.Linear(hidden, vocab_size)

    def _make_causal_mask(self, seq_len, device):
        # Create a causal mask to prevent attending to future tokens.
        # The mask is a lower triangular matrix.
        # shape: [seq_len, seq_len]
        mask = torch.tril(torch.ones(seq_len, seq_len, device=device)).unsqueeze(0).unsqueeze(1)
        return mask == 0 # True for positions to be masked

    def forward(self, x):
        # x shape: [batch_size, seq_len]
        batch_size, seq_len = x.size()

        # attention masking for generative model (causal mask)
        # mask shape: [1, 1, seq_len, seq_len]
        mask = self._make_causal_mask(seq_len, x.device)

        # embedding the indexed sequence to sequence of vectors
        x = self.embedding(x)

        # running over multiple transformer blocks
        for transformer in self.transformer_blocks:
            # Here, the TransformerBlock's forward should accept a mask
            x = transformer.forward(x, mask)

        # Projecting the output of the last transformer block to the vocab space
        output = self.output_layer(x)
        
        # output shape: [batch_size, seq_len, vocab_size]
        return output
```

### 参考

1. <https://github.com/affjljoo3581/GPT2/blob/master/src/gpt2/modeling/transformer.py>
2. [万字长文，带你搞懂什么是BERT模型（非常详细）看这一篇就够了！-CSDN博客](https://blog.csdn.net/star_nwe/article/details/143227601)
3. <https://arxiv.org/pdf/1810.04805>


# Positional Encoding

在任何一门语言中，词语的位置和顺序对句子意思表达都是至关重要的。传统RNN模型天然有序，在处理句子时，以序列的模式逐个处理句子中的词语，这使得词语的顺序信息在处理过程中被天然的保存下来，并不需要额外的处理。

由于Transformer模型没有RNN或CNN的顺序结构，句子中的词语都是同时进入网络进行处理，所以没有明确的关于单词在源句子中位置的相对或绝对的信息。为了让模型理解序列中每个单词的位置/顺序，Transformer论文中提出了使用一种叫做 Positional Encoding（位置编码） 的技术。这种技术通过为每个单词添加一个额外的编码来表示它在序列中的位置，这样模型就能够理解单词在序列中的相对位置。

## 1 位置敏感性

位置敏感性（position-insensitive）的定义是：

* 如果模型的输出会随着输入文本数据顺序的变化而变化，那么这个模型就是关于位置敏感的，反之则是位置不敏感的。
  * RNN和textCNN是位置敏感的
  * 无位置编码的Transformer是位置不敏感的

Positional Encoding的引入，就是用来表征文本中词与词之间的顺序关系，解决Transformer的位置敏感性问题。

## 2 Positional Encoding的概念

Positional Encoding就是将位置信息嵌入到Embedding词向量中，让Transformer保留词向量的**位置信息**，可以提高模型对序列的理解能力。

理想的位置编码应该满足：

1. 为序列中每个位置的token输出唯一的编码
2. 不同长度的句子之间，任意两个字的差值应该保持一致
3. 外推性：编码值应该是有界的，应该能在不付出任何努力的条件下泛化到更长的句子中

## 3 Positional Encoding的分类

最朴素的想法是为每个token赋予一个数字，如第一个字为1，第二个字为2。

但是这个数字会随着文本长度变长而变得很大。在推理时，如果没有看过某个特定长度的样本，会导致外推性很弱。比如训练时长度为2K，用户输入是4K，可能会导致模型性能急剧下降。

### 3.1 可学习位置编码

`Learned Positional Embedding`方法直接对不同的位置随机初始化一个position embedding，加在word enbedding上输出模型，作为参数进行训练。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FlpQZHbWGWedjjTPjTI3V%2Fimage.png?alt=media&amp;token=ed7cc25f-507a-47f5-9a64-6753e88ae508" alt=""><figcaption></figcaption></figure>

BERT使用的位置编码就是可学习位置编码。

**优点**

1. **灵活性高：**&#x80FD;适应特定任务的需求，无需人工设计规则

**缺点**

1. **外推性差：**&#x8BAD;练时的最大序列长度限制了推理时的外推能力。若测试文本远超训练长度，新增位置编码未经过训练，可能导致性能下降
2. **依赖海量数据：**&#x9700;要大量数据才能学习到有意义的编码，小数据集可能导致过拟合或编码无意义

### 3.2 sinusoidal位置编码

使用sin，cos交替创建positional encoding，用正余弦表示绝对位置，通过内积来表征相对位置。

$$
PE\_{(pos, 2i)} = sin(\frac{pos}{10000^{\frac{2i}{d\_{model}}}})
$$

$$
PE\_{(pos, 2i+1)} = cos(\frac{pos}{10000^{\frac{2i}{d\_{model}}}})
$$

pos代表token在序列中的位置，假设句子的长度为L，则 $$pos=0,1,\dots,L-1$$。i的范围可以从0取到 $$\frac {d\_{model}}{2}$$，最终$$PE$$的维度和$$d\_{model}$$一样。

$$
\begin{equation}\overrightarrow{PE}=\left\[\begin{array}{c}\sin \left(\omega\_1 \cdot pos\right) \\\cos \left(\omega\_1 \cdot pos\right) \\\sin \left(\omega\_2 \cdot pos\right) \\\cos \left(\omega\_2 \cdot pos\right) \\\vdots \\\vdots \\\sin \left(\omega\_{d / 2} \cdot pos\right) \\\cos \left(\omega\_{d / 2} \cdot t\right)\end{array}\right]\_{d \times 1}\end{equation}
$$

* `10000` 是一个经验值，其作用类似于**调节频率范围的超参**
  * 较小的分母会导致波长较短，**意味着相邻位置的编码差异剧烈，**&#x76F8;隔稍远的两个位置，其编码值已经几乎没有统计相关性，导致过度关注局部信息，难以建立长依赖
  * 较大的分母会导致波长较长，**意味着相邻 token 之间的位置编码差值非常小**，容易丢失局部细节

**为什么这样的正余弦的组合可以表示一个位置或者顺序？**

假设用一个二进制的形式表示数字：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6bd733f83ad962e92f23b288072c62a344f49a0a%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

可以观察到不同位之间变化的速度：最低位之间每个数字交替变化，第二低位每两个数字翻转一次。但是用二进制值会在浮点世界里造成空间浪费。所以反过来，我们可以使用它们对应的浮点连续值——三角函数。实际上，它们等价于交替变换的位。而且，通过降低它们的频率，我们也可以实现从红色的位走到橙色的位。

三角位置编码的另一个特性是，它允许模型毫无费力地把握相对位置。这是一段原论文的引用：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-ec5579ef08d4b2ff088e1a703b517b07f8fa0a65%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

公式：

$$sin(\alpha+\beta)=sin\alpha \cdot cos\beta + cos\alpha\cdot sin\beta$$

$$cos(\alpha+\beta) = cos\alpha\cdot cos\beta - sin\alpha\cdot sin\beta$$

对于位置pos+k的positional encoding：

$$PE\_{(pos+k, 2i)} = sin(w\_{i}\cdot (pos+k)) = sin(w\_{i}pos)cos(w\_{i}k)+cos(w\_{i}pos)sin(w\_{i}k)$$

$$PE\_{(pos+k, 2i+1)} = cos(w\_{i}\cdot (pos+k)) = cos(w\_{i}pos)cos(w\_{i}k)-sin(w\_{i}pos)sin(w\_{i}k)$$

其中，$$w\_{i} = \frac{1}{10000^{2i/d\_{model}}}$$

则：

$$PE\_{(pos+k, 2i)} = cos(w\_{i}k)PE\_{(pos, 2i)}+sin(w\_{i}k)PE\_{(pos, 2i+1)}$$

$$PE\_{(pos+k, 2i+1)} = cos(w\_{i}k)PE\_{(pos,2i+1)}-sin(w\_{i}k) PE\_{(pos, 2i)}$$

因此：

$$\left \[\begin{matrix} PE\_{(pos+k,2i)} \ PE\_{(pos+k, 2i+1)} \end{matrix} \right]=\left \[\begin{matrix} u & v \ -v & u \end{matrix} \right]\times\left \[\begin{matrix} PE\_{(pos,2i)} \ PE\_{(pos, 2i+1)} \end{matrix} \right]$$

其中$$u = cos(w\_{i}\cdot k), v = sin(w\_{i} \cdot k)$$为常数

所以$$PE\_{pos+k}$$可以被$$PE\_{pos}$$线性表示

计算两者的内积，可以发现：

$$\begin{align} PE\_{pos} \cdot PE\_{pos+k} &= \sum\_{i=0}^{\frac{d}{2}-1}sin(w\_ipos)\cdot sin(w\_i(pos+k)) + cos(w\_ipos) \cdot cos(w\_i(pos+k)) \ &=\sum\_{i=0}^{\frac{d}{2}-1} cos(w\_i(pos-(pos+k)) \ &=\sum\_{i=0}^{\frac{d}{2}-1} cos(w\_ik) \end{align}$$

内积会随着相对位置的递增而减小，从而表征位置的相对距离。

但是由于距离的对称性，虽然能反映相对位置的距离关系，但是无法区分方向。

**位置嵌入还有一种更直觉的解释，就是把它想象成一个钟（因为余弦和正弦就是单元圆的概念）。位置编码的每两个维度可以看成是钟的针（时针、分针、秒针等）。它们从一个位置移动到下一个位置就是在不同的频率下旋转它们的针。所以，尽管没有公式推导，它也能立刻告诉你为什么那个旋转矩阵存在。**

#### **3.2.1 正余弦位置编码的代码实现**

```python
import torch
import torch.nn as nn

class PositionalEncoding(nn.module):
	'''sincos'''
	def __init__(self, d_model, seq_len):
		super().__init__()
		
		# 和输入一样大小的维度
		self.encoding = torch.zeros(seq_len, d_model)
		# 不需要计算梯度
		self.encoding.requires_grad = False
		
		pos = torch.arrange(0, seq_len)
		pos = pos.float.unsqueeze(dim=1)

		_2i = torch.arange(0, d_model, step=2).float()

		self.encoding[:, 0::2] = torch.sin(pos / (10000 ** (_2i / d_model)))
    self.encoding[:, 1::2] = torch.cos(pos / (10000 ** (_2i / d_model)))

	def forward(self, x):
		batch_size, seq_len = x.size()
		return self.encoding[:seq_len, :]

class TokenEmbedding(nn.Embedding):
    """
    Token Embedding using torch.nn
    they will dense representation of word using weighted matrix
    """

    def __init__(self, vocab_size, d_model):
        """
        class for token embedding that included positional information
        :param vocab_size: size of vocabulary
        :param d_model: dimensions of model
        """
        super(TokenEmbedding, self).__init__(vocab_size, d_model, padding_idx=1)

class TransformerEmbedding(nn.Module):
    """
    token embedding + positional encoding (sinusoid)
    positional encoding can give positional information to network
    """

    def __init__(self, vocab_size, max_len, d_model, drop_prob, device):
        """
        class for word embedding that included positional information
        :param vocab_size: size of vocabulary
        :param d_model: dimensions of model
        """
        super(TransformerEmbedding, self).__init__()
        self.tok_emb = TokenEmbedding(vocab_size, d_model)
        self.pos_emb = PositionalEncoding(d_model, max_len, device)
        self.drop_out = nn.Dropout(p=drop_prob)

    def forward(self, x):
        tok_emb = self.tok_emb(x)
        pos_emb = self.pos_emb(x)
        return self.drop_out(tok_emb + pos_emb)
```

### **3.3 旋转位置编码RoPE**

RoPE主要借助了复数的思想

$$\begin{equation}\begin{aligned}\boldsymbol{q}\_m & =f\_q\left(\boldsymbol{x}\_m, m\right) \\\boldsymbol{k}\_n & =f\_k\left(\boldsymbol{x}\_n, n\right) \\\boldsymbol{v}\_n & =f\_v\left(\boldsymbol{x}\_n, n\right)\end{aligned}\end{equation}$$

为了能利用上 token 之间的相对位置信息，假定query向量$$q\_m$$和key向量$$k\_n$$之间的内积操作，可以被一个函数$$g$$表示：

$$\begin{equation}\<f\_q\left(x\_m, m\right), f\_k\left(x\_n, n\right)>=g\left(x\_m, x\_n, m-n\right)\end{equation}$$

* 左边是含有绝对位置信息的q和k，右边的输入是相对位置信息

假定现在词嵌入向量的维度是两维$$d=2$$，RoPE利用2维度平面上的向量的几何性质，再结合复数的性质，神奇般的找到了满足上述等式的$$f$$和$$g$$，其形式如下：

$$
\begin{equation}\begin{aligned}& f\_q\left(\boldsymbol{x}\_m, m\right)=\left(\boldsymbol{W}\_q \boldsymbol{x}\_m\right) e^{i m \theta} \\& f\_k\left(\boldsymbol{x}\_n, n\right)=\left(\boldsymbol{W}\_k \boldsymbol{x}\_n\right) e^{i n \theta} \\& g\left(\boldsymbol{x}\_m, \boldsymbol{x}\_n, m-n\right)=\operatorname{Re}\left\[\left(\boldsymbol{W}\_q \boldsymbol{x}\_m\right)\left(\boldsymbol{W}\_k \boldsymbol{x}\_n\right)^\* e^{i(m-n) \theta}\right]\end{aligned}\end{equation}
$$

这里面的 Re 表示复数的实部，推导后可以这样表示：

$$\begin{equation}\begin{aligned}f\_q\left(\boldsymbol{x}\_m, m\right) & =\left(\begin{array}{cc}\cos m \theta & -\sin m \theta) \\\sin m \theta & \cos m \theta\end{array}\right)\left(\begin{array}{ll}W\_q^{(1,1)} & W\_q^{(1,2)} \W\_q^{(2,1)} & W\_q^{(2,2)}\end{array}\right)\binom{x\_m^{(1)}}{x\_m^{(2)}} \\& =\left(\begin{array}{cc}\cos m \theta & -\sin m \theta) \\\sin m \theta & \cos m \theta\end{array}\right)\binom{q\_m^{(1)}}{q\_m^{(2)}}\end{aligned}\end{equation}$$

同理，

$$
\begin{align\*}
f\_k(x\_m, m) &=
\begin{pmatrix}
\cos m\theta & -\sin m\theta \\
\sin m\theta & \cos m\theta
\end{pmatrix}
\begin{pmatrix}
W\_k^{(1,1)} & W\_k^{(1,2)} \\
W\_k^{(2,1)} & W\_k^{(2,2)}
\end{pmatrix}
\begin{pmatrix}
x\_m^{(1)} \\
x\_m^{(2)}
\end{pmatrix} \\
&=
\begin{pmatrix}
\cos m\theta & -\sin m\theta \\
\sin m\theta & \cos m\theta
\end{pmatrix}
\begin{pmatrix}
k\_m^{(1)} \\
k\_m^{(2)}
\end{pmatrix}
\end{align\*}
$$

最终，

$$\begin{align\*} g(\mathbf{x}\_m, \mathbf{x}\_n, m - n) =  \begin{pmatrix} \mathbf{q}\_m^{(1)} & \mathbf{q}\_m^{(2)} \end{pmatrix} \begin{pmatrix} \cos((m - n)\theta) & -\sin((m - n)\theta) \ \sin((m - n)\theta) & \cos((m - n)\theta) \end{pmatrix} \begin{pmatrix} k\_n^{(1)} \ k\_n^{(2)} \end{pmatrix} \end{align\*}$$$$\begin{align\*} g(\mathbf{x}\_m, \mathbf{x}\_n, m - n) =  \begin{pmatrix} \mathbf{q}\_m^{(1)} & \mathbf{q}\_m^{(2)} \end{pmatrix} \begin{pmatrix} \cos((m - n)\theta) & -\sin((m - n)\theta) \ \sin((m - n)\theta) & \cos((m - n)\theta) \end{pmatrix} \begin{pmatrix} k\_n^{(1)} \ k\_n^{(2)} \end{pmatrix} \end{align\*}$$

RoPe self-attention的计算步骤是：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-316da96553f60f81db0e915eeb05f60a791e7d03%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

1. 对于 token 序列中的每个词嵌入向量，首先计算其对应的 query 和 key 向量
2. 然后对每个 token 位置都计算对应的旋转位置编码
3. 接着对每个 token 位置的 query 和 key 向量的元素按照 两两一组 应用旋转变换
4. 最后再计算 query 和 key 之间的内积得到 self-attention 的计算结果

#### **3.3.1 旋转位置编码的代码实现**

```python
import torch
import torch.nn as nn
import torch.nn.functional as F
import math
 
 
def RoPE(q, k):
    # q,k: (bs, head, max_len, output_dim)
    batch_size = q.shape[0]
    nums_head = q.shape[1]
    max_len = q.shape[2]
    output_dim = q.shape[-1]
 
    # (bs, head, max_len, output_dim)
    pos_emb = sinusoidal_position_embedding(batch_size, nums_head, max_len, output_dim, q.device)
 
 
    # cos_pos,sin_pos: (bs, head, max_len, output_dim)
    # 看rope公式可知，相邻cos，sin之间是相同的，所以复制一遍。如(1,2,3)变成(1,1,2,2,3,3)
    cos_pos = pos_emb[...,  1::2].repeat_interleave(2, dim=-1)  # 将奇数列信息抽取出来也就是cos 拿出来并复制
    sin_pos = pos_emb[..., ::2].repeat_interleave(2, dim=-1)  # 将偶数列信息抽取出来也就是sin 拿出来并复制
 
    # q,k: (bs, head, max_len, output_dim)
    q2 = torch.stack([-q[..., 1::2], q[..., ::2]], dim=-1)
    q2 = q2.reshape(q.shape)  # reshape后就是正负交替了
 
    # 更新qw, *对应位置相乘
    q = q * cos_pos + q2 * sin_pos
 
    k2 = torch.stack([-k[..., 1::2], k[..., ::2]], dim=-1)
    k2 = k2.reshape(k.shape)
    # 更新kw, *对应位置相乘
    k = k * cos_pos + k2 * sin_pos
 
    return q, k
```

### 3.4 ALiBi

ALiBi全称是Attention with Linear Biases，线性偏差注意力。不像标准transformer那样，在embedding层添加位置编码，而是在softmax的结果后添加一个静态的不可学习的偏置项。也就是说，通过改变 **注意力机制的权重计算** 来实现对位置的记录。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6c139859cc7fe44058c59572367e38a7892cdcef%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

传统注意力计算公式为：

$$\text{Attention}(Q, K, V) = \text{softmax}\left( \frac{QK^T}{\sqrt{d\_k}} \right)V$$

加入 ALiBi 偏置后的注意力机制公式为：

$$\text{Attention}(Q, K, V) = \text{softmax}\left( \frac{QK^T}{\sqrt{d\_k}} + b \right)V$$

$$b$$ 是一个与**每对 Query-Key 之间的相对距离相关的偏置矩阵。**

#### **3.4.1 偏置矩阵的构造方式**

1. 一个二维矩阵，其中第 $$(i,j)$$ 项表示第 $$i$$ 个token和第 $$j$$ 个token的相对距离
2. 对于每一个注意力头，指定一个斜率，越靠近的 token，其偏置越小，越远的 token，其偏置越大。
3. 整个偏置矩阵会被加到注意力 logits 上

#### 3.4.2 ALiBi的代码实现

```python
import torch

def build_alibi_bias(seq_len, num_heads):
    # 斜率的设定，通常用不同的值给不同头（这只是个例子）
    slopes = torch.tensor([-(2 ** (-i)) for i in range(num_heads)]).unsqueeze(1).unsqueeze(1)  # shape: (heads, 1, 1)

    # 构造相对距离矩阵 shape: (1, seq_len, seq_len)
    # entry [i][j] = j - i
    position_ids = torch.arange(seq_len).unsqueeze(0)
    relative_positions = position_ids - position_ids.T  # shape: (seq_len, seq_len)
    relative_positions = relative_positions.unsqueeze(0)  # (1, seq_len, seq_len)

    # 广播乘法，得到最终 bias：每个头一个
    alibi_bias = slopes * relative_positions  # shape: (heads, seq_len, seq_len)
    return alibi_bias

# 示例
num_heads = 4
seq_len = 6
alibi_bias = build_alibi_bias(seq_len, num_heads)
```

优点

* 不用对模型结构做任何更改

缺点

* 如果直接把位置外推到没见过的地方会导致模型灾难性崩溃

## 4 外推性问题

现如今很多大模型都开始支持超过4096长度的推理，例如GPT-4支持超过30k，ChatGLM2-6B也支持最长为32K的文本，但是由于显存资源的限制，这些大模型在真正在训练过程中不一定要训练这么长的文本，通常在预训练时只会设计到4k左右，因此如何确保在模型推理阶段可以支持远远超过预训练时的长度，是目前大模型的核心问题之一，我们将这一问题归为大模型的外推性。

训练和预测的长度不一致的问题，主要体现在两个方面：

* 预测的时候用到了没训练过的位置编码（不论是绝对位置还是相对位置）
* 预测的时候注意力机制所处理的token数量远超训练时的数量。

解决长文本外推性问题的一个简单有效的方法是Attention Mask，如图所示：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-b9c38b23f7e3a8be288a14e46f48482ab81c32d1%2Fattention-mask.png?alt=media" alt=""><figcaption></figcaption></figure>

* 通过类似滑动窗口的结构，约束一个每个token只能对局部区域的token计算Attention值，因此对于相对位置大小不会超过窗口大小
* Attention只会在窗口内计算，避免了对大量的token的Attention进行加权平均导致最终权重过度“平滑”现象。

qk之后减去一个矩阵M，M的形状如下：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-249427dd799702a6ced9265205f1fd0aaa0c37c9%2Fmatrix-m.png?alt=media" alt=""><figcaption></figcaption></figure>

## 5 总结

* 为什么需要位置编码
* 什么是位置敏感性
* 理想的位置编码应该满足什么条件
* 常见的位置编码介绍一下
* 三角函数位置编码的公式
  * 为什么频率上要除以10000
  * 相对位置关系如何表征
* 手撕三角函数编码
* 为什么RoPe具有很强的外推性

### 参考

1. <https://www.xiaohongshu.com/explore/6646e1220000000005005675>
2. [【Transformer系列】深入浅出理解Positional Encoding位置编码-CSDN博客](https://blog.csdn.net/m0_37605642/article/details/132866365)
3. [深度探讨大模型位置编码及其外推性-CSDN博客](https://wjn1996.blog.csdn.net/article/details/131753251)
4. [Transformer架构：位置编码（sin/cos编码）\_transformer位置编码为啥用sin和cos-CSDN博客](https://blog.csdn.net/weixin_43406046/article/details/130745363)
5. [一文通透位置编码：从标准位置编码、旋转位置编码RoPE到ALiBi、LLaMA 2 Long(含NTK-aware简介)-CSDN博客](https://blog.csdn.net/v_JULY_v/article/details/134085503)


# Self Attention

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-29b33070d5fab4429c4b6800494937e680e213b2%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 1 Self-Attention的概念

NLP任务中，输入的文本序列充当了上下文的作用。

人类在处理长文本时，需要知道一个单词与其它单词之间的相关性，也就是“语境”。**相关性**是人类对两个词在语义或语法上有多大关联”的直觉判断。比如，“apple”和“fruit”相关性强，“apple”和“car”相关性弱。

自注意力机制将单个序列的不同位置关联起来，用来计算同一序列的注意力权重。**注意力权重**是LLM通过训练任务（如语言建模、翻译、分类等）**自动学到的数值**，表示在某个特定上下文中，一个token对另一个token的“依赖程度”，和人类所说的“相关性”类似。

在一般的注意力机制中（Encoder-Decoder框架），query和key是不同来源的。例如在中译英模型中，query是中文单词特征，而key是英文单词特征。但self-attention的query和key都来自同一组元素，相互之间做注意力汇聚。

Self Attention可以捕获同一个句子中单词之间的一些句法特征或者语义特征。

引入Self Attention后会**更容易捕获句子中长距离的相互依赖的特征**。如果是RNN/LSTM，需要按照次序依次计算，对于远距离相互依赖的特征，要经过若干步的信息累计才能将两者联系起来，而距离越远，有效捕捉的可能性越小。

## 2 Self-Attention V.S. CNN

如果把Self-Attention用于图像：

* 优点
  * 可以建立全局的依赖关系，扩大图像的感受野。相比于CNN，其感受野更大，可以获取更多上下文信息。在全局建模能力上，Self-Atten有明显优势，它可以显式捕捉序列中任意两个元素之间的关系，不论它们的距离，在处理长距离依赖和全局信息方面非常强大
* 缺点
  * **自注意力机制是通过筛选重要信息，过滤不重要信息实现的，这就导致其有效信息的抓取能力会比CNN小一些**
  * 无法利用图像本身具有的尺度，平移不变性，以及图像的特征局部性这些先验知识，**只能通过大量数据进行学习。这就导致自注意力机制只有在大数据的基础上才能有效地建立准确的全局关系，而在小数据的情况下，其效果不如CNN**

## 3 Self-Attention原理

Self-Attention的**架构**

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-7cbbf5dde3d693445142449ed4c0bd330f9b5018%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Attention函数将query和一系列键值对mapping到一个output。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-04fbc1a07caa0ea3905d1425306623c6286d1a6c%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

主要步骤如下：

1. 将query和每个key进行**相似度计算**得到权重，相似度函数有点积、拼接、感知机等
2. 使用softmax函数将这些权重进行归一化
3. 将权重和对应的value相乘得到最后的attention

在Self-Atten中，输入序列中的每个词的**key**和**value**实际上是同一组线性变换后的表示。Key是用于检索的索引，类似于搜索引擎的关键词，value是被检索的内容，即搜搜结果的具体信息。而在Self-Atten中，每个词**既是检索者，也是被检索者。**

* 键值对形式的Attention计算公式

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-de2f7fe04d834f6ebc8e8d8a31a3345ef8f716cc%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

**为什么要除以** $$\sqrt{d\_k}$$ **?**

* 压缩softmax输入值，将方差重新缩放到 1，避免输入值过大，进入饱和区，导致梯度值太小（求导之后发现）难以训练

在Self-Atten中，公式中的Q、K、V的来源都是输入矩阵X与矩阵的乘积，本质上是X的线性变换：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-8b34ff3e3b96da786e2c96cab6d196e7ba01136b%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 4 代码实现

```python
import torch
import torch.nn as nn
import torch.function as F

class Attention(nn.module):
	def __init__(self, embeded_size):
		super().__init__()
		self.linear_q = nn.Linear(embeded_size, embeded_size, bias=False)
		self.linear_k = nn.Linear(embeded_size, embeded_size, bias=False)
		self.linear_v = nn.Linear(embeded_size, embeded_size, bias=False)
		
		self.norm = 1/math.sqrt(embeded_size)
	
	def forward(self, x):
		# x: batch_size, seq_len, embeded_size
		batch_size, seq_len, _ = x
		q = self.linear_q(x) # (batch_size, seq_len, embed_size)
		k = self.linear_k(x)
		v = self.linear_v(x)
		
		# dot production
		attention = torch.bmm(q, k.transpose(1,2)) * self.norm
		attention = F.softmax(attention, dim=-1) # (batch_size, seq_len, seq_len)
		
		out = torch.bmm(attention, values)
		return out
		
```

**为什么bias=False**

* 由于 softmax 函数会将输入转换成一个概率分布，其输出值的范围在0到1之间，并且各输出值的和为1，这减少了偏置项对模型性能的影响。因此，在这种情况下，省略偏置项可以减少模型的参数数量，提高训练速度，简化模型复杂度，并且有助于避免过拟合，提高模型的泛化能力。

## 5 Self-Attention例子

输入：

```python
”The animal didn't cross the street because it was too tired”
```

这句话中的单词"it"指的是什么呢？它是指“street”还是“animal”呢？

我们当然知道它是指”animal”，但是对于计算机而言，很难辨别。而自注意力机制允许寻找单词之间的相关性，帮助模型将“it”和“animal”放在一起处理。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-b4c7c09fc6a211cb117ff1a7dd48e2a57f828d16%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

1. 我们将query和key点乘后得到注意力score。以单词“Thinking”为例，我们需要计算出当前单词“Thinking”的其它所有单词的score。score通过计算query和其它各个单词key的内积得到，因此query和key必须拥有相同的维度。

   例如，在处理单词“Thinking”时，在其自身“Thinking”上的Score为112，而在单词“Machines”上的Score则为96。
2. 将得到的score除以key向量的维度开方，这一步会使得模型在训练时有着更稳定的梯度
3. 对上面的结果进行softmax处理，softmax使得上面的score都为正值，并相加等于1。这里得到的是在处理当前单词的时候每个单词的重要程度
4. 最后，用soft score和value相乘，这一步中，我们保持了那些需要注意的单词的完整性，并冲淡了那些与单词关联性不强的单词

## 6 Self-Attention的问题

1. **缺乏位置信息**：Self-Attention虽然考虑了所有的输入向量，但是没有考虑到向量的位置信息。可以通过位置编码来解决这个问题，将位置信息添加到输入序列中。
2. **计算复杂度高**：计算复杂度为$$n^2$$，对于长序列，计算成本显著增加

   可以使用优化算法和更高效的硬件（GPU）来加速计算，稀疏注意力等也能减小成本
3. **对长序列处理能力有限**：虽然自注意力可以处理长序列，但是在实际应用中，可能需要对非常长的序列进行有效处理

   可以使用分段注意力机制或者层次化注意力结构
4. 对小数据集泛化能力有限

## 7 总结

* 解释self-attention
* self-atten和CNN做对比（NLP和CV）
* self-atten和CNN的本质区别
* self-atten的公式
* **为什么要除以** $$\sqrt{d\_k}$$
* **为什么bias=False**
* self-atten的问题
* 手撕self-atten

## 参考

1. [一文搞定自注意力机制（Self-Attention）-CSDN博客](https://blog.csdn.net/weixin_42110638/article/details/134016569)
2. [attention各种形式总结\_attention公式-CSDN博客](https://blog.csdn.net/qq_41058526/article/details/80783925)
3. [CNN与注意力机制的本质区别 (qq.com)](https://mp.weixin.qq.com/s/XJy0EMFp7HvwBaOmkn5_Yg?poc_token=HLx0wWajBnIDELzlapiDLDrP8dmMlQRmT-qAxtfc)


# Multi-Head Attention

## 1 Multi-Head Attention概述

一段文字可能蕴含了不同维度的特征，比如情感、时间、逻辑等，为了能够从不同的维度抓取信息的重点，会使用Multi-Head Attention。Multi-Head Attention 是由多个 Self-Attention 组合形成。每个self-attention会产生一个维度上的输出特征，当使用多头注意力时，允许模型从不同的子空间捕捉不同级别的特征和信息，使模型从不同的角度理解数据。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-8bb18d277f48e096226dc1f0797b890013b378e3%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

在这里，V,K,Q三个矩阵通过h个线性变换，分别得到h组V,K,Q，每一组经过Attention公式计算，得到h个Attention Score进行拼接，最后通过一个线性变换得到输出。

## 2 Multi-Head Attention 例子

输入词：X=\[‘图’, ’书’, ’馆’]，句子长度为3，词向量的维度为4。

这里将词向量分为2个头，线性变换后得到2组$$(V\_0, K\_0, Q\_0)$$和$$(V\_1, K\_1, Q\_1)$$。每组$$(V, K, Q)$$进行Self-Attention计算得到两个Score即$$Z\_0$$和$$Z\_1$$，将$$Z\_0$$和$$Z\_1$$进行拼接Concat后进行线性变换得到输出向量Z，其维度与输入矩阵维度相同。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-28a3e02f42eb487ed310816ff0f440faa06ce5dd%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

```python
import torch
import torch.nn as nn
import numpy as np
import torch.nn.funcational as F

class MultiHeadAttention(nn.module):
	def __init__(self, embeded_size, num_heads, attention_head_size):
		super().__init__()
		self.num_heads = num_heads
		self.attention_head_size = attention_head_size
		self.embeded_size = embeded_size
		
		self.W_query = nn.Linear(embeded_size, attention_head_size)
		self.W_key = nn.Linear(embeded_size, attention_head_size)
		self.W_value = nn.Linear(embeded_size, attention_head_size)
	
	def forward(self, x):
		batch_size, seq_len, _ = x.size()
		querys = self.W_query(x) # (batch_size, sequence_len, attention_head_size)
		keys = self.W_keys(x)
		values = self.W_values(x)
		
		assert self.attention_head_size % self.num_heads == 0
		split_size = self.attention_head_size // self.num_heads
		
		querys = torch.view(self.num_heads, batch_size, seq_len, split_size) # (h, batch_size, sequence_len, split_size)
		keys = torch.view(self.num_heads, batch_size, seq_len, split_size)
		values = torch.view(self.num_heads, batch_size, seq_len, split_size)
		
		scores = torch.matmul(querys, keys.transpose(2, 3))
		scores = scores / (split_size ** 0.5)
		
		scores = F.softmax(scores, dim=-1)
		
		out = torch.matmul(scores, values) 	# (h, batch_size, sequence_len, split_size)
		out = out.transpose(0, 1) 	# (batch_size, h, sequence_len, split_size)
		out = out.transpose(1, 2).contiguous().view(batch_size, seq_len, -1) 
		
		return out, scores


```

`contiguous()`:

* 这个操作是为了确保张量在内存中是连续存储的，这样我们才能使用 `view()` 方法进行张量的重塑。

## 3 MQA & GQA

MHA是一种基础的注意力机制，它通过将输入分割成多个头来并行计算注意力，每个头学习输入的不同部分，最终将结果合并，以捕获序列的不同方面信息 。

MQA则是一种优化的注意力机制，它通过让所有头共享相同的键和值，减少了参数量和计算量，从而加快了推理速度，但可能会牺牲一些精度 。

GQA作为MHA和MQA的折中方案，它将查询头（query heads）分组，每组共享一个键和值，而不是所有头都共享。这样，GQA能够在减少计算量的同时，保持更多的多样性，从而在推理速度和模型精度之间取得平衡 。

* GQA-1：一个单独的组，等同于 Multi-Query Attention (MQA)。
* GQA-H：组数等于头数，基本上与 Multi-Head Attention (MHA) 相同。
* GQA-G：一个中间配置，具有G个组，平衡了效率和表达能力。

具体来说，GQA通过分组的方式，减少了需要缓存的键和值的数量，从而减少了内存的使用，同时由于不是所有头都共享键和值，它能够比MQA更好地保持MHA的多样性和精度 。例如，如果GQA使用2个头的键和值，那么每个组包含4个查询头，这样在保持速度的同时，精度损失会比MQA小 。

```
class  MultiQueryAttention(Attention):
    r"""
    https://arxiv.org/pdf/1911.02150.pdf
    """
    def __init__(self, word_size: int = 512, embed_dim: int = 64, n_query:int=8) -> None:
        super().__init__(word_size, embed_dim)
        self.n_query = n_query
        self.proj = nn.Linear(in_features=embed_dim * n_query,
                              out_features=embed_dim, bias=False)
        delattr(self, 'query')
        self.querys = nn.ModuleList([
            nn.Linear(in_features=word_size, out_features=embed_dim, bias=True)
            for _ in range(n_query)
        ])
        self.key = nn.Linear(in_features=word_size, out_features=embed_dim, bias=True)
        self.value = nn.Linear(in_features=word_size, out_features=embed_dim, bias=True)

    def forward(self, x: Tensor, mask:Optional[BoolTensor]=None) -> Tensor:
        K = self.key(x)
        V = self.value(x)
        Z_s = torch.cat([
            self.self_attention(query(x), K, V, mask) for query in self.querys
        ], dim=1)
        Z = self.proj(Z_s)
        return Z


class  GroupedQueryAttention(Attention):
    r"""
    https://arxiv.org/pdf/2305.13245.pdf
    """
    def __init__(self, word_size: int = 512, embed_dim: int = 64,
                 n_grouped: int = 4, n_query_each_group:int=2) -> None:
        super().__init__(word_size, embed_dim)
        delattr(self, 'query')
        delattr(self, 'key')
        delattr(self, 'value')

        self.grouped = nn.ModuleList([
            MultiQueryAttention(word_size, embed_dim, n_query=n_query_each_group)
            for _ in range(n_grouped)
        ])
        self.proj = nn.Linear(in_features=embed_dim * n_grouped,
                              out_features=embed_dim, bias=False)

    def forward(self, x: Tensor, mask:Optional[BoolTensor]=None) -> Tensor:
        Z_s = torch.cat([head(x, mask) for head in self.grouped], dim=1)
        Z = self.proj(Z_s)
        return Z
```

## 4 总结

* 多头注意力的作用
* 手撕多头注意力
* contiguous的作用是什么

## 参考

1. [一文搞定自注意力机制（Self-Attention）-CSDN博客](https://blog.csdn.net/weixin_42110638/article/details/134016569)
2. [https://zhuanlan.zhihu.com](https://zhuanlan.zhihu.com/p/30483365941)[/p/30483365941](https://zhuanlan.zhihu.com/p/30483365941)
3. <https://blog.51cto.com/u_16163453/12100632>


# Add & Norm

Transformer的Encoder层和Decoder层中都用到了Add\&Norm操作。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-ea05ea6f2119cf37875c4c746b9a2a0165bac42d%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

## 1 Add

残差连接就是把网络的输入和输出相加，即网络的输出为$$F(x)+x$$

在网络结构比较深的时候，网络梯度反向传播更新参数时，容易造成梯度消失的问题（每一层都乘以一个小于1的数，几十次一乘就几乎变成了0），但是如果每层的输出都加上一个$$x$$的时候，就变成了$$F(x)+x$$，对$$x$$求导结果为1，所以就相当于每一层求导时都加上了一个常数项 1 ，有效解决了梯度消失问题。

## 2 Norm

### 2.1 Norm的作用

当我们使用梯度下降法做优化时，随着网络深度的增加，输入数据的特征分布会不断发生变化，为了**保证数据特征分布的稳定性**，会加入Normalization。从而可以使用更大的学习率，**加速模型的收敛速度**。同时，Normalization也有一定的**抗过拟合**作用，使训练过程更加平稳。&#x20;

BN（BatchNorm）和LN（LayerNorm）是两种最常用的Normalization的方法，它们都是将输入特征转换为均值为0，方差为1的数据，它们的形式是：

<p align="center"><span class="math">\begin{equation} B N\left(x_i\right)=\alpha \times \frac{x_i-\mu_b}{\sqrt{\sigma_B^2+\epsilon}}+\beta \end{equation} </span></p>

<p align="center"><span class="math">\begin{equation}L N\left(x_i\right)=\alpha \times \frac{x_i-\mu_L}{\sqrt{\sigma_L^2+\epsilon}}+\beta\end{equation} </span></p>
<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6bd45b8bce27c89bd1c25ca38d380bf22bb78bee%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

BatchNorm一般用于CV，LayerNorm一般用于NLP

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-f2194a109ab466a104fd01372d7b642697160998%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

### 2.2 BatchNorm

假设把中国的收入水平进行标准化（变成标准正态分布），这时中国高收入人群的收入值接近3，中收入人群的收入值接近0，低收入人群接近-3。不难发现，标准化后的相对大小是不变的，即中国富人的收入水平在标准化前和标准化后都比中国穷人高。 **把中国的收入水平看成一个分布的话，我们可以说一个分布在标准化后，分布内的样本还是可比较的。**

假设把中国和印度的收入水平分别进行标准化，这时中国和印度的中收入人群的收入值都为0，但是这两个0可比较吗？印度和中国的中等收入人群的收入相同吗？不难发现，中国和印度的收入水平在归一化后，两国间收入值已经失去了可比性。 **把中国和印度的收入水平各自看成一个分布的话，我们可以说，不同分布分别进行标准化后，分布间的数值不可比较**

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-fb867f15120c08d8af4a2b2188603a653cb800ca%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

BatchNorm把一个batch中同一通道的所有特征（如上图红色区域）视为一个分布（有几个通道就有几个分布），并将其标准化。这意味着:

* 不同图片同一通道的相对关系是保留的，即不同图片的同一通道的特征是可比较的
* 同一图片的不同通道的特征失去了可比性

feature的每个通道都对应一种特征（如低纬特征的颜色、纹理、亮度等，高纬特征的人眼、鸟嘴等）。BatchNorm之后，颜色特征是可以相互比较的，但是颜色特征与纹理特征其实没有必要比较。

#### 2.2.1 BatchNorm代码实现

```python
import torch
import torch.nn as nn

class BatchNorm(nn.Module):
    def __init__(self, num_features, eps=1e-5):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(num_features))
        self.bias   = nn.Parameter(torch.zeros(num_features))

    def forward(self, x):
        # 判断 2-D 还是 4-D
        if x.dim() == 2:                       # (B, C)
            dims = (0,)
        else:                                  # (B, C, H, W)
            dims = (0, 2, 3)

        mean = x.mean(dim=dims, keepdim=True)
        var  = x.var(dim=dims, keepdim=True, unbiased=False)
        x_hat = (x - mean) / (var + self.eps).sqrt()

        # 广播 γ, β
        return self.weight.view_as(mean) * x_hat + self.bias.view_as(mean)
```

### 2.3 LayerNorm

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-6c445f52601a9a6c27d7bb45897588cce799dd06%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

同一句子中词义向量（上图中的V1, V2, …, VL）的相对大小是保留的

考虑两个句子，“教练，我想打篮球！” 和 “老板，我要一打包子。”。通过比较两个句子中 “打” 的词义我们可以发现，词义并非客观存在的，而是由上下文的语义决定的。 因此进行标准化时不应该破坏同一句子中不同词义向量的可比性，而LayerNorm是满足这一点的，BatchNorm则是不满足这一点的。且不同句子的词义特征也不应具有可比性，LayerNorm也是能够把不同句子间的可比性消除。

#### 2.3.1 LayerNorm代码实现

```python
import torch
import torch.nn as nn

class LayerNorm(nn.Module):
	def __init__(self, dim, eps=1e-6):
		super().__init__()
		self.eps = eps
		self.weight = nn.Parameter(torch.ones(dim))
		self.bias = nn.Parmaeter(torch.zeros(dim))
	def forward(self, x):
		mean = x.mean(-1, keepdim=True)
		std = x.std(-1, keepdim=True, unbiased=False)
		return self.weight * (x - mean) / (std + self.eps) + self.bias
```

### 2.4 RMSNorm

虽然LayerNorm很好，但是它每次需要计算均值和方差。RMSNorm的思想就是移除(1)式中$$\mu$$的计算部分。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-877e3db065ed1df9d6a357601a9ab077bbe1e6d6%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

相当于仅使用$$x$$的均方根来对输入进行归一化，它简化了层归一化的计算，变得更加高效。

```python
import torch
import torch.nn as nn
from torch import Tensor

class RMSNorm(nn.Module):
  def __init__(self, hidden_size: int, eps: float = 1e-6) -> None:
    super().__init__()
    self.eps = eps
    self.weight = nn.Parameter(torch.ones(hidden_size))
  
  def _norm(self, hidden_states: Tensor) -> Tensor:
    variance = hidden_states.pow(2).mean(-1, keepdim=True)
    return hidden_states * torch.rsqrt(variance + self.eps)
  
  def forward(self, hidden_states: Tensor) -> Tensor:
    return self.weight * self._norm(hidden_states.float()).type_as(hidden_states)
    

```

RMSNorm使用示例：

```python
import torch
import torch.nn as nn
from torch import Tensor

class SimpleNet(nn.Module):
    def __init__(self):
        super(SimpleNet, self).__init__()
        self.linear = nn.Linear(in_features=10, out_features=5)
        self.rmsnorm = RMSNorm(hidden_size=5)

    def forward(self, x):
        x = self.linear(x)
        x = self.rmsnorm(x)
        return x

net = SimpleNet()

input_data = torch.randn(2, 10)  # 2个样本，每个样本包含10个特征

output = net(input_data)

print("Input Shape:", input_data.shape)
print("Output Shape:", output.shape)

```

### 2.5 DeepNorm

DeepNorm用于超深层 Transformer 的稳定训练，是 **LayerNorm 的改进版本**，具体来说，**把残差分支的结果先放大 α 倍，再做 LayerNorm，从而在千层网络里保持梯度量级恒定，训练更稳。**

$$DeepNorm(x) = LayerNorm(α·x + Sublayer(x))$$&#x20;

α>1，由总层数 N 决定。

#### 2.5.1 DeepNorm代码实现

```python
import torch
import torch.nn as nn
import math

class DeepNorm(nn.Module):
    """单层的 DeepNorm（Post-Norm 版）"""
    def __init__(self, d_model: int, N: int):  # N = 模型总层数
        super().__init__()
        self.alpha = (2 * N) ** 0.25
        self.beta  = (8 * N) ** -0.25
        self.norm  = nn.LayerNorm(d_model)

    def forward(self, x, sublayer):
        """
        x:    残差输入 (B, L, d)
        sublayer: 一个 nn.Module，例如 Attention 或 FFN
        """
        return self.norm(self.alpha * x + sublayer(x * self.beta))
```

### 2.6 Post-norm & Pre-norm

论文 *On Layer Normalization in the Transformer Architecture* 提出了两种Layer Normalization方式并进行了对比。

把Transformer架构中传统的**Add\&Norm**做layer normalization的方式叫做Post-LN，并针对Post-LN，模型提出了Pre-LN，即把layer normalization加在残差连接之前，如下图所示：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-24c346d7a8208659f2b0c514b3ec00d58420e008%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

归一化的位置也有区别，分为后归一化（PostNorm）和前归一化（PreNorm），其中PostNorm在操作后进行归一化，而PreNorm在操作前进行归一化。PreNorm相较于Postnorm无需warmup,模型的收敛速度更快,但是实际应用中一般PreNorm效果不如PostNorm，因为PreNorm多层叠加的结果更多是增加宽度而不是深度。

## 总结

1. 残差连接的作用是什么？
2. norm的作用是什么？
3. LN和BN的区别
4. 手撕LN和BN
5. 手撕RMSNorm
6. RMS Norm 相比于 Layer Norm 有什么特点？
7. 手撕Deep Norm
8. Deep Norm 有什么优点？
9. LN在LLMs中的不同位置有什么区别吗？
10. LLMs各模型分别用了哪种LN

## 参考

1. <https://www.xiaohongshu.com/explore/6648b5680000000005005849>
2. [对Transformer中Add\&Norm层的理解-CSDN博客](https://blog.csdn.net/weixin_51756104/article/details/127232344)
3. [BERT用的LayerNorm可能不是你认为的那个Layer Norm？ (qq.com)](https://mp.weixin.qq.com/s/HNCl6MPS_hjTVHNt7UkYyw)
4. [Llama改进之——均方根层归一化RMSNorm-CSDN博客](https://blog.csdn.net/yjw123456/article/details/138139970)
5. <https://arxiv.org/abs/2203.00555>


# FeedForward

### 1 FeedForward原理

FeedForward的输入是Multi-Head Attention的输出做了残差连接和Norm之后的数据。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-5a9c9be41e065edee84656d27395894aa296865a%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

FeedForward做了两次线性线性变换，为的是更加深入的提取特征。每次线性变换都引入了非线性激活函数。在Multi-Head Attention中，对于输入主要是进行矩阵乘法进行线性变换，而线性变换的学习能力不如非线性变换的学习能力强。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-7a79a83fd71f5dadac5cd6bd4b849d11979250d6%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

#### 1.1 激活函数的选择

* RELU

  * 原始Transformer使用，计算高效，但是存在“死区”，模仿人脑，半饱和，可以有效对抗梯度爆炸/消失的问题

  <figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-eee92e47b066ec5950a1e4683d9c811a9e11c40b%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>
* GELU

将不重要的激活信息规整为0。对于每一个输入x，其服从标准的正太分布，它会乘上一个伯努利分布。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-c83dfee13751c6f02f754e7db8cb667adf0dc9f1%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

早期FFN层的激活函数用ReLU，现在BERT、GPT等主流模型多用GELU。GELU可以看作是ReLU的平滑近似，它在负值区不是完全置零，而是有一个平滑的曲线，近似神经元的随机正则化效果，被认为在处理自然语言任务时能提供更好的性能，因为它允许更丰富的梯度信息流动。

#### 1.2 Position-wise

Position-wise 代表对每个 token 应用同样的变换，但相互独立。它和注意力层形成功能互补：注意力负责“横向”的token间信息流动，FFN负责“纵向”的单个token信息深化。

### 2 FeedForward作用

通过线性变换和非线性激活函数，先将数据映射到高纬度的空间再映射到低纬度的空间，提取了更深层次的特征；通过激活函数引入非线性变换，增强模型对复杂模式的拟合能力。

如果没有FFN提供的非线性，那么多层Transformer堆叠在一起，其表达能力将大打折扣。因为多层线性变换的叠加本质上仍然是一个线性变换。非线性使得模型能够学习和拟合更加复杂的函数和模式。

**简单来说？**

* **提供“思考空间”**：升维操作可以被看作是给模型一个更大的“特征空间”或“思考空间”。在这个高维空间里，原始空间中线性不可分的特征可能变得更容易被分开和处理。

### 3 FFN层的参数量

在Transformer模型中，FFN层占据了绝大部分的参数。

* **举例**：以BERT-base为例， $$d\_{model} = 768，d\_{ff} = 3072$$
  * FFN层的参数量约等于：$$d\_{model} \times d\_{ff} + d\_{ff} \times d\_{model} = 2 \times 768 \times 3072 \approx 4.7 M$$
  * 而自注意力层中，Q/K/V的投影矩阵参数量为 $$3 \times d\_{model} \times d\_{model} = 3 \times 768 \times 768 \approx 1.8 M$$
* 模型的大部分“知识”或者说模式记忆，实际上是存储在FFN的权重中的。因此，FFN也被认为是Transformer中实现“记忆”功能的重要部分。
  * 后续的工作如**MoE (Mixture of Experts)**，就是通过将一个巨大的FFN层替换为多个稀疏激活的“专家”FFN网络，来在不显著增加计算量的情况下，极大扩展模型参数量。

### 4 FFN层的实现

```python
import torch
import torch.nn as nn
import torch.nn.functional as F

class FeedForward(nn.Module):
    def __init__(self, d_model: int, d_ff: int = None, activation: str = "gelu", dropout: float = 0.1):
        """
        Args:
            d_model: 输入/输出维度（即 Transformer 的隐藏层维度）
            d_ff:    中间层维度（默认扩展为 4*d_model）
            activation: 激活函数，支持 "gelu" 或 "relu"
            dropout:  Dropout 概率
        """
        super().__init__()
        d_ff = d_ff or 4 * d_model  # 默认扩展比例为4倍

        # 定义两个线性层
        self.linear1 = nn.Linear(d_model, d_ff)  # 扩展维度
        self.linear2 = nn.Linear(d_ff, d_model)  # 压缩回原维度
        
        # 激活函数选择
        self.activation = F.gelu if activation == "gelu" else F.relu
        
        # Dropout 层（可选）
        self.dropout = nn.Dropout(dropout) if dropout > 0 else nn.Identity()

        # 参数初始化（关键！）
        self._init_weights()

    def _init_weights(self):
        # 使用 He/Kaiming 初始化（适合 ReLU）
        nn.init.kaiming_normal_(self.linear1.weight, nonlinearity='relu')
        nn.init.zeros_(self.linear1.bias)
        
        # 缩小输出层的初始化范围
        nn.init.xavier_normal_(self.linear2.weight, gain=0.02)
        nn.init.zeros_(self.linear2.bias)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """
        输入形状: (batch_size, seq_len, d_model)
        输出形状: (batch_size, seq_len, d_model)
        """
        x = self.linear1(x)       # (batch, seq, d_ff)
        x = self.activation(x)    # 非线性激活
        x = self.dropout(x)       # 可选 Dropout
        x = self.linear2(x)       # (batch, seq, d_model)
        return x
```

### 参考

1. [前馈神经网络（Feed-Forward Neural Network）-腾讯云开发者社区-腾讯云](https://cloud.tencent.com/developer/article/2511089)
2. [对Transformer中FeedForward层的理解\_feedforward层的作用-CSDN博客](https://blog.csdn.net/weixin_51756104/article/details/127250190)


# Linear & Softmax

Transformer最终会为需要预测的下一个 token 生成一个高维向量。从高维向量到具体的词，例如“猫”、“学习”或者“天空”，需要经过 Linear & Softmax 层。

## 1 Linear

通过一次线性变换，将输入的上下文向量投影到词表空间。输出的长向量被称为 Logits，Logits中的每个元素都对应词汇表中的一个单词，其数值代表模型认为该单词是下一个正确单词的原始、未经归一化的置信度分数。分数越高，代表模型的信心越足。

## 2 Softmax

Logits分数虽然直观地表达了模型的偏好，但它们并不是标准的概率，存在两个问题：

1. 数值范围不固定，可以是任意正负实数。
2. 所有分数的总和不是1，无法直接用于概率计算或抽样。

Softmax的工作过程：

1. **指数化：** 通过指数函数 ($$ex$$) 将所有的Logits分数转换成正数。拉大高分和低分之间的差距，让模型的选择更加坚定。
2. **归一化：**&#x5C06;每个转换后的分数除以所有分数之和。

经过了Softmax之后的元素的值，代表了对应单词是下一个正确单词的最终预测概率。

## 参考

1. <https://blog.csdn.net/qq_52099920/article/details/146389675>
2.


# Decoding Strategy

Transformer 的 decoder 在生成文本时，并非一次性输出完整的句子，而是自回归逐个生成 token。在生成每个 token 时，模型会基于已经生成的 token 和编码器对输入信息的理解，计算出词汇表中所有可能 token 的概率分布。

如何从这个概率分布中选择下一个 token？

* 每次选择概率最高的 token——恭喜你，发明了 Greedy Search
* 每次保留概率最高的几个 token，再选择一条总概率最高的路径——恭喜你，发明了 Beam Search
* 如果不想要每次都走选最正确的路，希望有一点随机性——恭喜你，发明了 Sampling

## **1 Greedy Search**

Greedy Search 有时也称作启发式搜索，在 LLM 中，通常指在每个 ***t*** 时刻选择下一个词时，根据  ***wt=argmaxwP(w|w1:t−1)*** 选择概率最高的词。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-3fff94b2b86e471dafba3fb84dd82dae0d7b41f6%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

Greedy Search 是一种合理的策略，但也有一些缺点，例如：

* 输出可能会卡在重复循环中。就像智能输入法给出的下一词建议，当你不断选择建议最高的单词时，它可能会变成重复的句子。

## **2 Beam Search**

与 Greedy Search 不同，Beam Search 为了避免错过隐藏的高概率词，通过参数 ***num\_beams*** 的配置，可以在每个时刻，记录概率最高的前 *num\_beams* 个路径，在下一个时刻可以有多个基础路径同时搜索。

如上图，当 t=1 时，最大概率的路径是（“The”、“nice”），Beam Search 同时也会记录概率排第二的路径（“The”、“dog”）；当t=2时，集束搜索也会发现路径（“The”、“dog”、“has”）有0.36的概率超过了路径（“The”、“nice”、“women”）的概率0.2。因此，两条路径中，找到了概率最高的路径，得到了更为合理的答案。 不过，在开放领域生成任务的时候，Greedy Search 和 Beam Search 都不是很好的解码方式，因为可能会导致缺乏创造性、趣味性、多样性。

### 2.1 Beam Search 代码实现

```python
class BeamHypotheses(object):
    def __init__(self, num_beams, max_length, length_penalty):
        self.max_length = max_length - 1   # ignoring bos_token
        self.num_beams = num_beams
        self.beams = []
        self.worst_score = 1e9
 
    def __len__(self):
        return len(self.beams)
 
    def add(self, hyp, sum_logprobs):
        score = sum_logprobs / len(hyp) ** self.length_penalty
        if len(self) < self.num_beams or score > self.worst_score:
            # 可更新的情况：数量未饱和或超过最差得分
            self.beams.append((score, hyp))
            if len(self) > self.num_beams:
                # 数量饱和需要删掉一个最差的
                sorted_scores = sorted([(s, idx) for idx, (s, _) in enumerate(self.beams)])
                del self.beams[sorted_scores[0][1]]
                self.worst_score = sorted_scores[1][0]
            else:
                self.worst_score = min(score, self.worst_score)
 
    def is_done(self, best_sum_logprobs, cur_len=None):
        """
        相关样本是否已经完成生成。
        best_sum_logprobs是新的候选序列中的最高得分。
        """
 
        if len(self) < self.num_beams:
            return False
        else:
            if cur_len is None:
                cur_len = self.max_length
            cur_score = best_sum_logprobs / cur_len ** self.length_penalty
            # 是否最高分比当前保存的最低分还差
            ret = self.worst_score >= cur_score
            return ret

# 建立beam容器，每个样本一个
generated_hyps = [
    BeamHypotheses(num_beams, max_length, length_penalty, early_stopping=early_stopping)
    for _ in range(batch_size)
]
 
# 每个beam容器的得分，共batch_size*num_beams个
beam_scores = torch.zeros((batch_size, num_beams), dtype=torch.float, device=encoder_input_ids.device)
beam_scores = beam_scores.view(-1)
 
# 每个样本是否完成生成，共batch_size个
done = [False for _ in range(batch_size)]
 
# 为了并行计算，一次生成batch_size*num_beams个序列
# 第一步自动填入bos_token
input_ids = torch.full(
    (batch_size*num_beams, 1),
    bos_token_id,
    dtype=torch.long,
    device=next(self.parameters()).device,
)
 
# 当前长度设为1
cur_len = 1

while cur_len < max_length:
    # 将编码器得到的上下文向量和当前结果输入解码器，即图中1
    output = decoder.decode_next_step(context, input_ids)
    # 输出矩阵维度为：(batch*num_beams)*cur_len*vocab_size
    
    # 取出最后一个时间步的各token概率，即当前条件概率
    # (batch*num_beams)*vocab_size
    scores = next_token_logits = output[:, -1, :]
 
    ###########################
    # 这里可以做一大堆操作减少重复 #
    ###########################
 
    # 计算序列条件概率的，因为取了log，所以直接相加即可。得到图中2矩阵
    # (batch_size * num_beams, vocab_size)
    next_scores = scores + beam_scores[:, None].expand_as(scores)
 
    # 为了提速，将结果重排成图中3的形状
    next_scores = next_scores.view(
            batch_size, num_beams * vocab_size
        )  # (batch_size, num_beams * vocab_size)
 
    # 取出分数最高的token（图中黑点）和其对应得分
    # sorted=True，保证返回序列是有序的
    next_scores, next_tokens = torch.topk(next_scores, 2 * num_beams, dim=1, largest=True, sorted=True)
 
    # 下一个时间步整个batch的beam列表
    # 列表中的每一个元素都是三元组
    # (分数, token_id, beam_id)
    next_batch_beam = []
 
    # 对每一个样本进行扩展
    for batch_idx in range(batch_size):
 
        # 检查样本是否已经生成结束
        if done[batch_idx]:
            # 对于已经结束的句子，待添加的是pad token
            next_batch_beam.extend([(0, pad_token_id, 0)] * num_beams)  # pad the batch
            continue
 
        # 当前样本下一个时间步的beam列表
        next_sent_beam = []
 
        # 对于还未结束的样本需要找到分数最高的num_beams个扩展
        # 注意，next_scores和next_tokens是对应的
        # 而且已经按照next_scores排好顺序
        for beam_token_rank, (beam_token_id, beam_token_score) in enumerate(
            zip(next_tokens[batch_idx], next_scores[batch_idx])
        ):
            # get beam and word IDs
            # 这两行可参考图中3进行理解
            beam_id = beam_token_id // vocab_size
            token_id = beam_token_id % vocab_size
 
            effective_beam_id = batch_idx * num_beams + beam_id
 
            # 如果出现了EOS token说明已经生成了完整句子
            if (eos_token_id is not None) and (token_id.item() == eos_token_id):
                # if beam_token does not belong to top num_beams tokens, it should not be added
                is_beam_token_worse_than_top_num_beams = beam_token_rank >= num_beams
                if is_beam_token_worse_than_top_num_beams:
                    continue
                # 往容器中添加这个序列
                generated_hyps[batch_idx].add(
                    input_ids[effective_beam_id].clone(), beam_token_score.item(),
                )
            else:
                # add next predicted word if it is not eos_token
                next_sent_beam.append((beam_token_score, token_id, effective_beam_id))
 
            # 扩展num_beams个就够了
            if len(next_sent_beam) == num_beams:
                break
 
        # 检查这个样本是否已经生成完了，有两种情况
        # 1. 已经记录过该样本结束
        # 2. 新的结果没有使结果改善
        done[batch_idx] = done[batch_idx] or generated_hyps[batch_idx].is_done(
            next_scores[batch_idx].max().item(), cur_len=cur_len
        )
 
        # 把当前样本的结果添加到batch结果的后面
        next_batch_beam.extend(next_sent_beam)
 
    # 如果全部样本都已经生成结束便可以直接退出了
    if all(done):
        break
    
    # 把三元组列表再还原成三个独立列表
    beam_scores = beam_scores.new([x[0] for x in next_batch_beam])
    beam_tokens = input_ids.new([x[1] for x in next_batch_beam])
    beam_idx = input_ids.new([x[2] for x in next_batch_beam])
 
    # 准备下一时刻的解码器输入
    # 取出实际被扩展的beam
    input_ids = input_ids[beam_idx, :]
    # 在这些beam后面接上新生成的token
    input_ids = torch.cat([input_ids, beam_tokens.unsqueeze(1)], dim=-1)
 
    # 更新当前长度
    cur_len = cur_len + 1
    # end of length while
```

## **3 Sampling**

### **3.1 Top-K 固态采样**

Beam Search 每次会选择在 Beam 中最大概率的词汇，Top-k 采样是对 Greedy Search 的优化，它从排名前 k 的 token 中进行抽样，允许其他概率较高的 token 也有机会被选中，也就是有一定机率不选最大概率的词，而其引入的随机性有助于在许多情况下提高生成质量。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-b7331d1705e68096fdd013377b0ee2c1cee61a5f%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

#### **3.1.1 代码实现**

```python
import torch
import torch.nn.functional as F

def top_k_sampling(logits, k, temperature=1.0):
    """
    对给定的 logits 执行 Top-K 采样。

    Args:
        logits (torch.Tensor): 模型输出的原始 logits，形状为 (vocab_size,)。
        k (int): 只从概率最高的 k 个词元中采样。
        temperature (float): 温度参数，用于调整概率分布的平滑度。

    Returns:
        int: 被采样的词元的 ID。
    """
    # 1. 对 logits 应用 temperature
    if temperature != 1.0:
        logits = logits / temperature

    # 2. 找到 top k 的 logits 和它们的索引
    # torch.topk 会返回 (values, indices)
    top_k_values, top_k_indices = torch.topk(logits, k)
    
    # 3. 创建一个新的 logits 张量，只保留 top k 的值，其余设为负无穷
    # 这是一种高效的过滤方法，因为 e^(-inf) = 0
    filtered_logits = torch.full_like(logits, -float('Inf'))
    filtered_logits[top_k_indices] = top_k_values
    
    # 4. 对过滤后的 logits 应用 softmax，得到一个合法的概率分布
    # 那些被设为 -inf 的位置，其概率会变为 0
    probabilities = F.softmax(filtered_logits, dim=-1)
    
    # 5. 从新的概率分布中随机采样一个词元
    # torch.multinomial 要求输入是概率，而不是 logits
    next_token_id = torch.multinomial(probabilities, num_samples=1)
    
    return next_token_id.item()
```

### **3.2 Top-P 动态采样**

Top-P方法可以动态设置token候选列表的大小。这种方法也称为 *Nucleus Sampling（核采样）*，通过选择可能性总和不超过特定值的高概率token来创建候选名单。可以看下面的示意图：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-ac198686540ab838da9fc5c5fc7bbf74cd489358%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

#### 3.2.1 代码实现

```python
import torch
import torch.nn.functional as F

def top_p_sampling(logits, p, temperature=1.0):
    """
    对给定的 logits 执行 Top-p (Nucleus) 采样。

    Args:
        logits (torch.Tensor): 模型输出的原始 logits，形状为 (vocab_size,)。
        p (float): 累积概率阈值，介于 0 和 1 之间。
        temperature (float): 温度参数。

    Returns:
        int: 被采样的词元的 ID。
    """
    # 1. 对 logits 应用 temperature 并计算概率
    if temperature != 1.0:
        logits = logits / temperature
    probabilities = F.softmax(logits, dim=-1)

    # 2. 对概率进行降序排序，并保留原始索引
    # sorted_probs: 排序后的概率值
    # sorted_indices: 排序后概率值对应的原始索引
    sorted_probs, sorted_indices = torch.sort(probabilities, descending=True)

    # 3. 计算累积概率
    cumulative_probs = torch.cumsum(sorted_probs, dim=-1)

    # 4. 找到需要保留的词元的索引（构建 Nucleus）
    # 我们移除那些累积概率超过 p 的词元。
    # 注意：我们至少保留一个概率最高的词元。
    sorted_indices_to_remove = cumulative_probs > p
    # 将第一个词元（概率最高的）的移除标记设为 False，确保至少有一个词被保留
    sorted_indices_to_remove[..., 1:] = sorted_indices_to_remove[..., :-1].clone()
    sorted_indices_to_remove[..., 0] = 0

    # 5. 创建一个只包含 Nucleus 中词元的新概率分布
    # 创建一个全零的分布
    filtered_probs = torch.zeros_like(probabilities)
    # 使用 scatter_ 将要保留的词的原始概率放回新分布中
    # sorted_indices[~sorted_indices_to_remove] 得到要保留的词的原始索引
    # sorted_probs[~sorted_indices_to_remove] 得到这些词的概率值
    indices_to_keep = sorted_indices[~sorted_indices_to_remove]
    probs_to_keep = sorted_probs[~sorted_indices_to_remove]
    filtered_probs.scatter_(dim=-1, index=indices_to_keep, src=probs_to_keep)

    # 6. 对新分布进行重新归一化
    renormalized_probs = filtered_probs / torch.sum(filtered_probs)

    # 7. 从重新归一化的分布中采样
    next_token_id = torch.multinomial(renormalized_probs, num_samples=1)
    
    return next_token_id.item()
```

### **3.3 Temperature 强化采样**

如上面的代码所示，Temperature 在模型计算出最终的词汇表概率分布（通过 Softmax 函数）之前，对原始的 `logits`进行缩放。

公式为：

$$
Probabilities=softmax( \frac{logits}{temperature})
$$

高 Temperature 意味着更多的随机性。这可以帮助模型提供更多创造性的输出。

通常我们是将 top-k、top-p、Temperature 联合起来使用。使用的先后顺序是`top-k->top-p->Temperature` 。

### 总结

1. 有哪些采样策略
2. 手撕
3. topp, topk, temperature是如何协同工作的

### 参考

1. [大模型（LLM）解码：从Greedy Search到Top-P\_大模型解码策略-CSDN博客](https://blog.csdn.net/Mike0010/article/details/138326166)
2. <https://zh.d2l.ai/chapter_recurrent-modern/beam-search.html>
3. <https://www.cnblogs.com/nickchen121/p/15499576.html>


# LLM应用


# 信息检索

####


# 相似度度量

> 在推荐系统、搜索引擎、RAG、图像检索等场景中，"相似度计算"是最底层、最核心的操作之一。衡量两个向量之间"有多像"，这个问题看似简单，但选错度量方法，整个系统的效果可能天差地别。

### 1 为什么"相似度"需要量化？

人类判断相似性靠直觉——你一眼就能看出"猫"和"狗"比"猫"和"卡车"更像。但机器没有直觉，它只能依靠数字来判断。

在这里，文本、图像、音频等各种数据，都会先被编码成**向量**（embedding）。一段话是一个 768 维向量，一张图是一个 512 维向量。两个东西"像不像"，就变成了一个纯粹的数学问题：<mark style="color:$primary;">**两个向量之间的"距离"或"相似度"是多少？**</mark>

#### 什么是好的相似度度量？

一个好的度量函数应该满足几个直觉：

* **自身最相似**：一个向量和自己的相似度应该是最大值
* **对称性**：A 和 B 的相似度 = B 和 A 的相似度
* **区分度**：真正相似的向量得分高，不相似的得分低
* **计算高效**：在亿级数据中，这个函数要被调用几亿次，不能太慢

### 2 余弦相似度

#### 2.1 几何直觉

余弦相似度的核心思想极其直观：**只看方向，不看长度**。

想象二维平面上的两个箭头。如果它们指向几乎相同的方向，无论长短，我们都认为它们"相似"。余弦相似度衡量的就是这两个箭头之间夹角的余弦值。

* 夹角 $$= 0^\circ$$（完全同向） $$\rightarrow \cos(0^\circ) = 1$$（最相似）
* 夹角 $$= 90^\circ$$（正交，毫无关系） $$\rightarrow \cos(90^\circ) = 0$$
* 夹角 $$= 180^\circ$$（完全反向） $$\rightarrow \cos(180^\circ) = -1$$（最不相似）

#### 2.2 数学公式

给定两个向量 $$\mathbf{a} = (a\_1, a\_2, \ldots, a\_n)$$ 和 $$\mathbf{b} = (b\_1, b\_2, \ldots, b\_n)$$，余弦相似度定义为：

$$
\cos\_sim(\mathbf{a}, \mathbf{b}) = \frac{\mathbf{a} \cdot \mathbf{b}}{|\mathbf{a}| \cdot |\mathbf{b}|} = \frac{\sum\_{i=1}^{n} a\_i b\_i}{\sqrt{\sum\_{i=1}^{n} a\_i^2} \cdot \sqrt{\sum\_{i=1}^{n} b\_i^2}}
$$

其中：

* $$\mathbf{a} \cdot \mathbf{b}$$ 是向量点积：

  $$
  \mathbf{a} \cdot \mathbf{b} = \sum\_{i=1}^{n} a\_i b\_i = a\_1b\_1 + a\_2b\_2 + \cdots + a\_nb\_n
  $$
* $$|\mathbf{a}|$$ 是向量 $$\mathbf{a}$$ 的 L2 范数（模长）：

  $$
  |\mathbf{a}| = \sqrt{\sum\_{i=1}^{n} a\_i^2} = \sqrt{a\_1^2 + a\_2^2 + \cdots + a\_n^2}
  $$

**取值范围**：$$\[-1, 1]$$

实际上，在大多数 embedding 模型的输出中（如 Sentence-BERT、text2vec），向量的各维度都是正数居多，所以实际范围通常在 $$\[0, 1]$$ 附近。

#### 2.3 为什么它对向量长度不敏感

这是余弦相似度最重要的特性。看公式，分母是两个向量的模长之积，这本质上是在做归一化。

举个例子：

$$
\mathbf{a} = (1, 2, 3), \quad \mathbf{b} = (2, 4, 6) \quad (\mathbf{b} = 2\mathbf{a}，方向完全相同，长度翻倍)
$$

$$
\begin{aligned}
\cos\_sim(\mathbf{a}, \mathbf{b}) &= \frac{1 \times 2 + 2 \times 4 + 3 \times 6}{\sqrt{14} \times \sqrt{56}} \\
&= \frac{28}{28} \\
&= 1.0 \quad \leftarrow \text{完全相似}
\end{aligned}
$$

向量 $$\mathbf{b}$$ 只是 $$\mathbf{a}$$ 的两倍长，但余弦相似度认为它们完全一样。这在文本场景中特别有用：一篇长文章和一篇短文章，如果讨论的是同一个话题，它们的 embedding 方向应该一致，只是"强度"（模长）不同。余弦相似度不会因为文档长度不同而给出不公平的分数。

如果向量已经做过 L2 归一化（即 $$|\mathbf{a}| = |\mathbf{b}| = 1$$），那么：

$$
\cos\_sim(\mathbf{a}, \mathbf{b}) = \mathbf{a} \cdot \mathbf{b}
$$

余弦相似度退化为点积。这就是为什么很多系统会先归一化，再直接算点积——更快，结果一样。

#### 2.4 Python 实现

```python
import numpy as np

def cosine_similarity(a, b):
    """计算两个向量的余弦相似度"""
    dot = np.dot(a, b)
    norm_a = np.linalg.norm(a)
    norm_b = np.linalg.norm(b)
    if norm_a == 0 or norm_b == 0:
        return 0.0
    return dot / (norm_a * norm_b)

# 示例
a = np.array([1, 2, 3])
b = np.array([2, 4, 6])   # 与 a 同方向
c = np.array([3, -1, 2])  # 与 a 方向不同

print(cosine_similarity(a, b))  # 1.0（完全相似）
print(cosine_similarity(a, c))  # 0.41（有一定相似性）
```

### 3 点积 <a href="#id-3-e7-82-b9-e7-a7-afdot-product-inner-product" id="id-3-e7-82-b9-e7-a7-afdot-product-inner-product"></a>

#### 3.1 从余弦相似度到点积

点积是最"朴素"的向量运算：

$$
\text{dot}(\mathbf{a}, \mathbf{b}) = \mathbf{a} \cdot \mathbf{b} = \sum\_{i=1}^{n} a\_i b\_i = a\_1b\_1 + a\_2b\_2 + \cdots + a\_nb\_n
$$

回顾余弦相似度的公式，我们知道：

$$
\mathbf{a} \cdot \mathbf{b} = |\mathbf{a}| \cdot |\mathbf{b}| \cdot \cos(\theta)
$$

也就是说：

$$
\text{点积} = \text{余弦相似度} \times \text{两个向量的模长之积}
$$

这意味着点积同时编码了两个信息：

1. **方向的一致性**（$$\cos(\theta)$$ 部分）
2. **向量的"强度"**（模长部分）

<mark style="color:$primary;">当模长本身携带有意义的信息时，点积比余弦更合适。</mark>

一个经典的例子是推荐系统。假设：

* 用户向量的模长代表用户的活跃度（活跃用户向量更长）
* 物品向量的模长代表物品的热门程度（热门物品向量更长）

如果用余弦相似度，一个冷门物品和一个热门物品只要方向一致，得分就一样。但实际上，你可能希望热门物品天然有更高的分数（因为用户更可能点击）。这时候点积就能自然地做到这一点。

再举一个更具体的例子：

$$
\begin{aligned}
\mathbf{user} &= (0.5, 0.3) \quad \text{# 不太活跃的用户，偏好方向：}(5, 3) \\
\mathbf{item}\_A &= (4.0, 2.4) \quad \text{# 热门物品，方向与用户一致} \\
\mathbf{item}\_B &= (0.5, 0.3) \quad \text{# 冷门物品，方向与用户一致}
\end{aligned}
$$

$$
\cos\_sim(\mathbf{user}, \mathbf{item}\_A) = 1.0 \quad \leftarrow \text{余弦看来完全一样}
$$

$$
\cos\_sim(\mathbf{user}, \mathbf{item}\_B) = 1.0
$$

$$
\mathbf{user} \cdot \mathbf{item}\_A = 2.0 + 0.72 = 2.72 \quad \leftarrow \text{点积能区分热门和冷门}
$$

$$
\mathbf{user} \cdot \mathbf{item}\_B = 0.25 + 0.09 = 0.34
$$

#### 3.3 内积搜索（MIPS）问题

在大规模检索中，如果你用点积作为度量，需要找到与 query 向量点积最大的 top-k 向量，这就是 Maximum Inner Product Search (MIPS) 问题。

MIPS 比最近邻搜索（NNS）更棘手，因为：

* 欧氏距离最近邻搜索有成熟的数据结构（KD-Tree、Ball Tree 等）
* 但点积不满足三角不等式，传统方法不能直接用

解决方案通常是把 MIPS 转化为 NNS。一个经典技巧：给向量增加一个额外维度，使得点积最大等价于欧氏距离最小。具体来说，对于向量 $$\mathbf{x}$$，构造：

$$
\mathbf{x}' = \left(\mathbf{x}, \sqrt{M^2 - |\mathbf{x}|^2}\right) \quad \text{其中 } M = \max\_{\mathbf{x}} |\mathbf{x}| \text{ 对所有 } \mathbf{x}
$$

这样就可以用 Faiss 等工具的 L2 索引来做 MIPS 了。

实际工程中，Faiss 的 `IndexFlatIP` 直接支持内积搜索，底层已经做了类似的优化。

#### 3.4 点积的取值范围

没有固定范围，取决于向量的模长和维度。这是点积的一个"缺点"——不同 query 的点积分数不可直接比较。如果需要可比较的分数，要么归一化后用余弦，要么对分数做后处理（如 softmax）。

#### 3.5 Python 实现

```python
import numpy as np

def dot_product(a, b):
    """计算两个向量的点积"""
    return np.dot(a, b)

# 示例：点积能区分模长
user = np.array([0.5, 0.3])
item_hot = np.array([4.0, 2.4])   # 热门物品
item_cold = np.array([0.5, 0.3])  # 冷门物品

print(dot_product(user, item_hot))   # 2.72
print(dot_product(user, item_cold))  # 0.34
```

### 4 欧氏距离

#### 4.1 最符合直觉的"距离"

欧氏距离就是日常生活中"两点之间的直线距离"，推广到 $$n$$ 维空间：

$$
d(\mathbf{a}, \mathbf{b}) = \sqrt{\sum\_{i=1}^{n} (a\_i - b\_i)^2} = \sqrt{(a\_1-b\_1)^2 + (a\_2-b\_2)^2 + \cdots + (a\_n-b\_n)^2}
$$

也叫 L2 距离。注意，欧氏距离是距离（越小越相似），而不是相似度（越大越相似）。

实际计算中，经常省略开方，直接用平方欧氏距离，因为：

* 开方不改变排序关系
* 省掉开方运算更快

$$
d^2(\mathbf{a}, \mathbf{b}) = \sum\_{i=1}^{n} (a\_i - b\_i)^2 = |\mathbf{a} - \mathbf{b}|^2
$$

#### 4.2 与余弦相似度的数学等价

这是一个非常重要的结论：**当向量经过 L2 归一化后，欧氏距离和余弦相似度是等价的。**

证明如下。设 $$|\mathbf{a}| = |\mathbf{b}| = 1$$，则：

$$
\begin{aligned}
|\mathbf{a} - \mathbf{b}|^2 &= (\mathbf{a} - \mathbf{b}) \cdot (\mathbf{a} - \mathbf{b}) \\
&= \mathbf{a}\cdot\mathbf{a} - 2\mathbf{a}\cdot\mathbf{b} + \mathbf{b}\cdot\mathbf{b} \\
&= |\mathbf{a}|^2 - 2(\mathbf{a}\cdot\mathbf{b}) + |\mathbf{b}|^2 \\
&= 1 - 2(\mathbf{a}\cdot\mathbf{b}) + 1 \\
&= 2 - 2\cos\_sim(\mathbf{a}, \mathbf{b}) \\
&= 2(1 - \cos\_sim(\mathbf{a}, \mathbf{b}))
\end{aligned}
$$

所以：

$$
|\mathbf{a} - \mathbf{b}|^2 = 2(1 - \cos\_sim(\mathbf{a}, \mathbf{b}))
$$

这意味着：**对归一化向量来说，用余弦相似度排序和用欧氏距离排序，结果完全一样。**&#x20;

这就是为什么 Faiss 中 `IndexFlatL2`（L2 距离）和 `IndexFlatIP`（内积）在归一化向量上给出相同的检索结果。

#### 4.3 维度灾难：高维空间中欧氏距离的失效

这是一个反直觉但极其重要的现象。

在高维空间中，随机采样的点之间的欧氏距离趋于集中。也就是说，最近的点和最远的点之间的距离差异变得非常小。

数学上可以证明，对于 $$n$$ 维空间中的随机向量：

$$
\lim\_{n \to \infty} \frac{d\_{\max} - d\_{\min}}{d\_{\min}} \to 0
$$

#### 4.4 Python 实现

```python
import numpy as np

def euclidean_distance(a, b):
    """计算两个向量的欧氏距离"""
    return np.linalg.norm(a - b)

def squared_euclidean_distance(a, b):
    """计算平方欧氏距离（省去开方，更快）"""
    diff = a - b
    return np.dot(diff, diff)

# 示例
a = np.array([1.0, 2.0, 3.0])
b = np.array([1.1, 2.1, 3.1])  # 很近
c = np.array([5.0, 0.0, -1.0]) # 很远

print(euclidean_distance(a, b))  # 0.173（很近）
print(euclidean_distance(a, c))  # 5.099（很远）

# 验证归一化后的等价关系
a_norm = a / np.linalg.norm(a)
b_norm = b / np.linalg.norm(b)
cos_sim = np.dot(a_norm, b_norm)
l2_sq = np.sum((a_norm - b_norm) ** 2)
print(f"2(1 - cos_sim) = {2 * (1 - cos_sim):.6f}")
print(f"L2² = {l2_sq:.6f}")
```

***

### 5 汉明距离

汉明距离衡量的是两个等长序列中，对应位置上不同元素的个数。

对于二进制向量（0/1 向量），就是不同 bit 的个数：

```
a = 1 0 1 1 0 1 0 0
b = 1 0 0 1 1 1 0 0
    ✓ ✓ ✗ ✓ ✗ ✓ ✓ ✓

Hamming(a, b) = 2（第 3 位和第 5 位不同）
```

汉明距离的计算可以用两个硬件原语完成：

$$
\text{Hamming}(\mathbf{a}, \mathbf{b}) = \text{popcount}(\mathbf{a} \oplus \mathbf{b})
$$

* **XOR（异或）**：相同位得 0，不同位得 1。一条 CPU 指令
* **popcount（位计数）**：统计结果中 1 的个数。现代 CPU 有专用指令（POPCNT）

对于一个 64-bit 的二进制向量，整个汉明距离计算只需要 2 条 CPU 指令。相比之下，余弦相似度在 64 维向量上需要约 200 次浮点运算。

更重要的是，二进制向量的存储极其紧凑：

* 一个 768 维的 float32 embedding = 3072 字节
* 同样信息量，用 768-bit 的二进制哈希 = 96 字节（压缩 32 倍）

#### 5.1 与 SimHash / 局部敏感哈希（LSH）的关系

但你可能会问：文本 embedding 是浮点数向量，怎么变成二进制向量？

这就是**局部敏感哈希（Locality-Sensitive Hashing, LSH）** 的工作。LSH 的核心思想是：

> 设计一个哈希函数，使得相似的输入以高概率映射到相似的哈希值（汉明距离小），不相似的输入映射到不相似的哈希值。

**SimHash** 就是一种经典的 LSH 方法，常用于文本去重。它的流程是：

1. 对文本进行分词，提取特征（如 n-gram）
2. 每个特征通过普通哈希函数映射到一个固定长度的二进制串
3. 根据特征的权重（如 TF-IDF），对每一位进行加权投票
4. 最终每一位：正数票多 → 1，负数票多 → 0

```
文本 A → SimHash: 10110100...（64 bit）
文本 B → SimHash: 10100100...（64 bit）
```

两个文本的相似度判断就变成了：汉明距离 $$\leq$$ 阈值（通常取 3）就认为近似重复。

Google 早期用 SimHash 做网页去重，在几十亿网页中快速发现重复内容。64-bit SimHash + 汉明距离 $$\leq 3$$ 的方案，可以在毫秒级别完成判断。

#### 5.2 汉明距离的局限

* **信息损失大**：从 float32 到 1-bit 是极端的量化，精度会有明显下降
* **只适合粗筛**：通常作为第一步快速过滤，后续再用余弦等精确度量进行重排
* **阈值敏感**：汉明距离是离散的整数值，对阈值的选择很敏感

#### 5.3 Python 实现

```python
def hamming_distance_bin(a: int, b: int) -> int:
    """计算两个整数的二进制汉明距离"""
    return bin(a ^ b).count('1')

# 示例
a = 0b10110100
b = 0b10100100
print(hamming_distance_bin(a, b))  # 2

# 用 numpy 处理二进制向量
import numpy as np

def hamming_distance_vec(a, b):
    """计算两个 0/1 向量的汉明距离"""
    return np.sum(a != b)

a = np.array([1, 0, 1, 1, 0, 1, 0, 0])
b = np.array([1, 0, 0, 1, 1, 1, 0, 0])
print(hamming_distance_vec(a, b))  # 2
```

***

### 6. 横向对比总结

| 度量    | 类型         | 取值范围                   | 是否关注模长   | 计算复杂度       | 典型场景                 |
| ----- | ---------- | ---------------------- | -------- | ----------- | -------------------- |
| 余弦相似度 | 相似度（越大越相似） | $$\[-1, 1]$$           | ❌ 不关注    | $$O(n)$$    | 文本 embedding 比较、语义搜索 |
| 点积    | 相似度（越大越相似） | $$(-\infty, +\infty)$$ | ✅ 关注     | $$O(n)$$    | 推荐系统、模长有意义的场景        |
| 欧氏距离  | 距离（越小越相似）  | $$\[0, +\infty)$$      | ✅ 关注     | $$O(n)$$    | 低维几何距离、聚类、归一化后检索     |
| 汉明距离  | 距离（越小越相似）  | $$\[0, n]$$（$$n$$ 为维度） | N/A（二进制） | $$O(1)^\*$$ | 大规模去重、粗筛、LSH         |

\*$$O(1)$$ 指的是利用硬件 XOR + POPCNT 指令，对固定长度的二进制串，计算时间与"维度"无关。

### 参考

1. <https://github.com/shibing624/similarities>


# 文本表示方法

给你一段文本，怎么把它变成机器能计算的东西？这个问题在 NLP 领域被反复回答了几十年，诞生了无数方案。

### 1 词袋模型

词袋模型（Bag of Words, BoW）的假设：一段文本 = 一堆词的集合，就像拿着袋子装着一堆词一样，不需要考虑词序。

比如下面两句话：

```
A: "猫追狗"
B: "狗追猫"
```

在词袋模型眼里，A 和 B 是**完全相同**的——都是 `{猫, 追, 狗}`。

### 2. TF-IDF

#### 2.1 词频和逆文档频率

TF-IDF 的全称是 **Term Frequency - Inverse Document Frequency**，由两部分组成：

* **TF（词频）：一个词在当前文档中出现得越多，越重要。**
  * $$\text{TF}(t, d) = \frac{\text{词 } t \text{ 在文档 } d \text{ 中出现的次数}}{\text{文档 } d \text{ 的总词数}}$$
* **IDF（逆文档频率）：一个词在越多文档中出现，越不重要。**
  * $$\text{IDF}(t) = \log \frac{N}{1 + \text{df}(t)}$$，其中 N 是总文档数，df(t) 是包含词 t 的文档数，分母加 1 是为了避免除零。

"的"、"是"、"在"这种词，几乎在每篇文档中都出现，它们的 IDF 极低。而"SimHash"可能只在少数文档中出现，IDF 就很高。

**为什么 IDF 要取 log？**

**log 把乘法关系压缩成了加法关系**，让权重差异保持在合理范围内。这和人类对"稀有度"的感知是一致的——你觉得一个罕见词比常见词重要一些，但不是重要几个数量级。

#### 2.2 TF-IDF 向量 + 余弦相似度

把 TF 和 IDF 乘起来，就得到每个词的 TF-IDF 权重：

$$\text{TF-IDF}(t, d) = \text{TF}(t, d) \times \text{IDF}(t)$$

一篇文档中所有词的 TF-IDF 值排成一个向量，就是这篇文档的 **TF-IDF 向量**。

我们可以用余弦相似度比较两篇文档的相似度：

$$\text{cos}(\vec{a}, \vec{b}) = \frac{\vec{a} \cdot \vec{b}}{|\vec{a}| \times |\vec{b}|}$$

**TF-IDF 向量 + 余弦相似度**就是最经典的文本相似度方案，统治了 NLP 领域很多年。

#### 2.3 一个具体的例子

假设我们有 3 篇文档的语料库：

```
D1: "猫 喜欢 吃 鱼"
D2: "猫 喜欢 玩 球"  
D3: "狗 喜欢 吃 骨头"
```

词表：\[猫, 喜欢, 吃, 鱼, 玩, 球, 狗, 骨头]

先算 IDF（N=3）：

| 词  | 出现在几篇文档中 | IDF = log(3/(1+df))              |
| -- | -------- | -------------------------------- |
| 猫  | 2        | log(3/3) = 0                     |
| 喜欢 | 3        | log(3/4) ≈ -0.29（实际实现会用变体公式避免负值） |
| 吃  | 2        | log(3/3) = 0                     |
| 鱼  | 1        | log(3/2) ≈ 0.41                  |
| 玩  | 1        | log(3/2) ≈ 0.41                  |
| 球  | 1        | log(3/2) ≈ 0.41                  |
| 狗  | 1        | log(3/2) ≈ 0.41                  |
| 骨头 | 1        | log(3/2) ≈ 0.41                  |

"喜欢"在所有文档中都出现，IDF 最低；"鱼""球""骨头"各只在一篇中出现，IDF 最高。**TF-IDF 自动把"区分度高"的词挑了出来。**

#### 2.4 TF-IDF 的局限性

**1. 无法处理同义词。**

"机器学习"和"ML"在 TF-IDF 眼里是完全不同的两个词，余弦相似度为 0。但人类知道它们是一回事。

**2. 无法处理一词多义。**

"苹果"在"苹果很好吃"和"苹果发布了新 iPhone"中含义完全不同，但 TF-IDF 会给它们相同的权重。

### 3 BM25

#### 3.1 从 TF-IDF 到 BM25

TF-IDF 有一个隐含的假设：**词频越高，重要性线性增长**。一个词出现 10 次就比出现 1 次重要 10 倍。

但这合理吗？

想象一篇 10000 词的文档，"深度学习"出现了 200 次。另一篇 500 词的文档，"深度学习"出现了 20 次。哪篇和"深度学习"更相关？

直觉上是后者——在更短的篇幅里更高频地提到，说明主题更聚焦。但 TF-IDF 会认为前者更相关（200 > 20）。

BM25（Best Matching 25）针对这两个问题做了修正：

**问题一：词频的边际收益递减。**

"深度学习"出现 1 次 → 5 次，相关性大幅提升。但从 50 次 → 100 次呢？提升微乎其微。BM25 用一个**饱和函数**来建模这种效应。

**问题二：长文档天然词频更高。**

一篇 10000 词的文档，几乎任何词都比 500 词的文档出现得更多。BM25 引入了**文档长度归一化**来消除这种偏差。

#### 3.2 BM25 公式

BM25 的评分公式如下：

$$\text{BM25}(q, d) = \sum\_{t \in q} \text{IDF}(t) \cdot \frac{f(t,d) \cdot (k\_1 + 1)}{f(t,d) + k\_1 \cdot \left(1 - b + b \cdot \frac{|d|}{\text{avgdl}}\right)}$$

其中：

* **IDF(t)**：和 TF-IDF 一样，稀有词权重更高
* **f(t,d)**：词 t 在文档 d 中的出现次数（原始词频）
* **|d|**：文档 d 的长度
* **avgdl**：语料库中文档的平均长度
* **k₁** 和 **b**：两个超参数

**k₁ 控制词频饱和的速度。**

* k₁ = 0：完全忽略词频，只看词有没有出现（退化为布尔模型）
* k₁ 越大：词频的影响越接近线性（越像原始 TF）
* 典型取值：k₁ = 1.2 \~ 2.0

用一张图理解更直观：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fr5is60CEIGRIccSZcMfG%2FCopilot_20260421_162854.png?alt=media&amp;token=98366c2f-d010-4595-baae-9f39ac92297c" alt=""><figcaption></figcaption></figure>

**b 控制文档长度归一化的强度。**

* b = 0：完全不做长度归一化（长文档和短文档一视同仁）
* b = 1：完全按长度归一化（长文档被严厉惩罚）
* 典型取值：b = 0.75

**调参建议：**

* 如果你的语料中文档长度差异很大（比如混合了推文和长文），b 应该大一些
* 如果文档长度比较均匀，b 可以小一些
* k₁ 通常用默认值就行，除非你的场景中词频分布特别极端

#### 3.3 为什么 BM25 至今仍是搜索引擎的标配？

深度学习模型满天飞的今天，为什么 Elasticsearch、Lucene、各大搜索引擎的**第一道召回**仍然在用 BM25？

三个原因：

**1. 速度。** BM25 基于倒排索引，查询复杂度是 O(查询词数 × 包含该词的文档数)。对于十亿级别的文档库，毫秒级返回结果。深度学习模型做不到。

**2. 可解释性。** BM25 的每一项得分都可以追溯到具体的词和权重。debug 的时候，你能清楚地知道为什么某篇文档排在前面。

**3. 基线够强。** 在大多数信息检索任务上，BM25 的召回率已经相当好了。很多号称"超越 BM25"的深度学习模型，在实际部署中和 BM25 的差距远没有论文里写的那么大。

工业界的常见做法通常是：**BM25 做粗召回（从十亿缩到几千），然后用深度模型做精排（从几千缩到几十）**。

### 4 SimHash

TF-IDF 和 BM25 解决的是"两段文本有多相似"的问题。但有时候我们需要回答一个更粗暴的问题：

> **这两个网页是不是同一篇文章的复制品？**

搜索引擎每天爬取数十亿网页，其中大量是互相抄袭、镜像、或者只改了几个字的重复内容。如果不去重，搜索结果页会被同一篇文章的不同副本淹没。

用 TF-IDF + 余弦相似度能做吗？能，但太慢了。十亿篇文档两两比较，需要 10^18 次运算。

我们需要一种方法：**把每篇文档压缩成一个短指纹，然后用指纹快速比较。**&#x8FD9;就是 SimHash 要做的事。

#### 4.1 局部敏感哈希（LSH）的思想

传统哈希（如 MD5、SHA256）有一个特性：输入稍有变化，输出完全不同。"Hello" 和 "hello" 的 MD5 值天差地别。这对安全性很好，但对相似度检测来说是灾难。

**局部敏感哈希（Locality-Sensitive Hashing, LSH）** 反其道而行：

> **相似的输入 → 相似的哈希值；不相似的输入 → 不相似的哈希值。**

SimHash 是 LSH 家族中最著名的成员之一，由 Moses Charikar 在 2002 年提出，后被 Google 用于网页去重并广为人知。

#### 4.2 SimHash 的构造过程

假设我们要为一篇文档生成一个 64 位的 SimHash 指纹，过程如下：

**Step 1：分词 + 加权**

把文档拆成词，每个词赋予一个权重（可以用 TF-IDF 权重）。

```
文档："机器学习 是 人工智能 的 核心 技术"

词及权重：
  机器学习 → 5.2
  是       → 0.3
  人工智能 → 4.8
  的       → 0.1
  核心     → 3.1
  技术     → 2.7
```

**Step 2：每个词生成传统哈希**

对每个词计算一个 64 位的传统哈希值（如 MurmurHash）：

```
机器学习 → 1010 0111 ... (64位)
人工智能 → 0110 1101 ... (64位)
核心     → 1100 0010 ... (64位)
```

**Step 3：加权合并**

初始化一个 64 维的全零向量 V。对每个词的哈希值：

* 如果第 i 位是 1，则 V\[i] += 该词的权重
* 如果第 i 位是 0，则 V\[i] -= 该词的权重

```
以"机器学习"（权重 5.2，哈希 10100111...）为例：
V[0] += 5.2  （第0位是1）
V[1] -= 5.2  （第1位是0）
V[2] += 5.2  （第2位是1）
V[3] -= 5.2  （第3位是0）
V[4] -= 5.2  （第4位是0）
V[5] += 5.2  （第5位是1）
V[6] += 5.2  （第6位是1）
V[7] += 5.2  （第7位是1）
...
```

所有词处理完后，V 的每个维度累积了所有词在该位上的加权投票。

**Step 4：二值化**

```
V[i] > 0  → 最终指纹第 i 位 = 1
V[i] ≤ 0 → 最终指纹第 i 位 = 0
```

最终得到一个 64 位的二进制指纹，比如：`1010011100110101...`

**整个过程的直觉：** 高权重的词对最终指纹的影响更大。如果两篇文档的高权重词大致相同，它们的 SimHash 指纹也会大致相同。

#### 4.3 用汉明距离快速判重

两个 SimHash 指纹的**汉明距离**（Hamming Distance）= 对应位不同的个数。

```
指纹A: 1 0 1 0 0 1 1 1
指纹B: 1 0 1 1 0 1 0 1
差异:   . . . X . . X .  → 汉明距离 = 2
```

计算汉明距离极其高效——只需要一次 XOR 操作 + popcount（数 1 的个数），现代 CPU 一条指令就能完成。

**判重规则：**

| 汉明距离 | 含义            |
| ---- | ------------- |
| 0    | 完全相同（或极其相似）   |
| 1-3  | 高度疑似重复（改了几个字） |
| 4-10 | 可能有关联         |
| >10  | 基本不同          |

在 Google 的实践中，通常**汉明距离 ≤ 3 就判定为近似重复**。

#### 4.4 分桶策略

即使有了 SimHash，十亿文档两两比较汉明距离仍然是 O(n²)。实际工程中会用**分桶（Blocking）** 策略：

把 64 位指纹分成 4 个 16 位的段。如果两个指纹的汉明距离 ≤ 3，那么至少有一个段是完全相同的（鸽巢原理）。

所以：

1. 对每个段建一个哈希表
2. 只比较至少有一个段相同的文档对
3. 候选对数量从 O(n²) 降低到远小于此的规模


# 词向量

根据词频来表示的词汇语义，有一个很大的缺陷，就是**不懂语义。**

```
"我很快乐"
"我很开心"
```

这两句话在人类看来几乎完全相同。但在 TF-IDF 的世界里，"快乐"和"开心"是两个毫不相干的维度，余弦相似度很低。

问题的根源在于：TF-IDF 把每个词当成一个独立的符号，词与词之间没有任何关联。"猫"和"狗"的距离，等于"猫"和"微积分"的距离——都是正交的。

所以我们需要一种全新的表示方式：**让语义相近的词，在向量空间中也彼此接近。**

这就是词向量（Word Embedding）要做的事。

### 1 Word2Vec

#### 1.1 核心直觉

Word2Vec 的核心思想可以用一句话来表示：**一个词的含义，由它周围的词决定。**

"猫"和"狗"经常出现在相似的上下文中（"养了一只\_\_\_"、"\_\_\_在沙发上睡觉"），所以它们的含义应该是相近的。

Word2Vec 把这个语言学直觉变成了一个可计算的任务：**用一个词的上下文来预测这个词（或者反过来），训练出来的中间产物——词向量——自然就捕获了语义信息。**

具体的实现在之前的文章中已经讲过，这里不再赘述，参见：

[Static Word Embeddings](/llm-everything/basics/machine-learning-basics/feature-extraction/text-representation-models/static-word-embeddings)

### 2 从词向量到句子向量

有了词向量之后，一个自然的问题是：**怎么得到一个句子的向量？**

#### 2.1 平均池化

最简单的方法：把句子中所有词的向量取平均。

$$\vec{s} = \frac{1}{n} \sum\_{i=1}^{n} \vec{w\_i}$$

"我 喜欢 吃 苹果" → (vec(我) + vec(喜欢) + vec(吃) + vec(苹果)) / 4

在很多场景中效果还不错。平均操作相当于在高维空间中找了一个"重心"，能大致表示整个句子的语义方向。

#### 2.2 TF-IDF 加权平均

平均池化的问题是"的""了""在"这种停用词和"量子计算"这种核心词权重相同。

改进方案：用 TF-IDF 权重做加权平均。

$$\vec{s} = \frac{\sum\_{i=1}^{n} \text{tfidf}(w\_i) \cdot \vec{w\_i}}{\sum\_{i=1}^{n} \text{tfidf}(w\_i)}$$

效果比简单平均好一些，因为停用词的权重被压低了。

但是无论是平均还是加权平均，都有一个根本问题：**丢失了词序信息。**

```
"猫追狗" 和 "狗追猫"
```

它们包含完全相同的词，词向量的平均值也完全相同。但含义明显不同。

更深层的问题是：**句子的含义不等于词义的简单加总。** "他没有不高兴"的意思不等于"他""没有""不""高兴"四个词向量加起来。

要真正得到好的句子向量，我们需要专门为句子级别的语义设计模型。

### 3 Sentence-BERT

#### 3.1 BERT 的问题

到 2018 年，BERT 横空出世，在几乎所有 NLP 任务上刷新了记录。BERT 通过双向 Transformer 编码器，能够生成**上下文相关**的词表示——同一个词在不同语境中会有不同的向量。

BERT 的标准用法是：把两个句子拼起来，输入模型，输出一个分类结果（相似/不相似）。

```
输入: [CLS] 句子A [SEP] 句子B [SEP]
输出: 相似度分数
```

这叫做 **交叉编码（Cross-Encoder）**。效果很好，但有一个致命的效率问题：

假设你有 10000 个句子，想找出最相似的两个。交叉编码需要对每一对都跑一次 BERT：

$$C\_{10000}^{2} = 49,995,000 \text{ 次 BERT 推理}$$

BERT 一次推理大约 10ms，总共需要 **约 139 小时**。这在实际应用中完全不可接受。

**那用 BERT 的 \[CLS] 向量呢？**

BERT 在每个输入序列的开头会加一个 \[CLS] token，有人认为它的隐藏状态可以作为整个句子的表示。

但实验表明，**直接用 BERT 的 \[CLS] 向量做余弦相似度，效果甚至不如 GloVe 词向量的平均值。**

因为 BERT 的预训练目标（Masked Language Model + Next Sentence Prediction）并没有训练 \[CLS] 向量去捕获句子级别的语义。\[CLS] 向量更多是为下游分类任务准备的——它在微调阶段才学到有用的信息。直接拿预训练的 \[CLS] 向量算相似度，得到的基本是噪声。

#### 3.2 Sentence-BERT 的解决方案

Sentence-BERT（SBERT，2019 年）的核心思路很简洁：

> **用孪生网络（Siamese Network）训练 BERT，让它学会为每个句子独立输出一个好的向量。**

架构如下：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FCkvaIg57IKgY0lBJlFOv%2FCopilot_20260421_215942.png?alt=media&amp;token=2967f7bc-7fe4-4e78-8fbc-6ea2a80cc4f8" alt=""><figcaption></figcaption></figure>

**1. 共享权重。** 两个 BERT 编码器是同一个模型，参数完全共享。这保证了同一个句子无论走哪条路径，得到的向量都一样。

**2. 池化策略。** BERT 输出的是一个 token 序列的向量，需要池化成一个句子向量。SBERT 测试了三种池化方式：

* \[CLS] 向量
* 所有 token 向量的平均值（Mean Pooling）
* 所有 token 向量的逐维最大值（Max Pooling）

实验结果：**Mean Pooling 效果最好。**

#### 3.3 训练方式

SBERT 主要用了两种训练方式：

**方式一：在 NLI 数据集上用 Softmax 分类。**

NLI（Natural Language Inference）数据集包含句子对及其关系标签：

* **蕴含（Entailment）**："一只猫在睡觉" → "有动物在休息"
* **矛盾（Contradiction）**："一只猫在睡觉" → "所有动物都醒着"
* **中性（Neutral）**："一只猫在睡觉" → "猫是灰色的"

训练时，把两个句子的向量 u、v 以及它们的差 |u-v| 拼接起来，过一个 Softmax 分类器：

$$\text{softmax}(W \cdot \[u; v; |u-v|])$$

预测三分类标签。这种方式利用了大规模 NLI 数据集（如 SNLI + MultiNLI，约 100 万条数据），训练信号丰富。

**方式二：在 STS 数据集上用 Cosine Loss。**

STS（Semantic Textual Similarity）数据集直接提供了句子对的相似度分数（0-5）。

训练时直接优化两个句子向量的余弦相似度与标注分数的均方误差：

$$\text{Loss} = \text{MSE}(\cos(u, v), \text{label})$$

有了 SBERT，句子相似度搜索的流程变成：

1. 离线：对所有句子跑一次 BERT，得到向量，存入索引
2. 在线：对查询句子跑一次 BERT，得到向量，用余弦相似度在索引中检索

同样是 10000 个句子找最相似的对：

* Cross-Encoder：49,995,000 次推理 ≈ 139 小时
* SBERT：10000 次推理 + 余弦相似度计算 ≈ **几秒钟**

### 4 CoSENT

#### 4.1 SBERT 损失函数的问题

SBERT 的 Softmax 分类损失有一个微妙的问题：它把语义相似度简化成了离散的三分类（蕴含/矛盾/中性），丢失了细粒度的相似度信息。

而 Cosine Loss（均方误差）也有问题：它对每个句子对独立优化，没有考虑**句子对之间的相对关系**。

举个例子：

* 句子对 A 的标注相似度是 0.9
* 句子对 B 的标注相似度是 0.3

Cosine Loss 分别优化 A 的余弦相似度接近 0.9、B 的余弦相似度接近 0.3。但它不直接保证 **A 的分数就是高于 B 的分数**。

#### 4.2 CoSENT 的排序思想

CoSENT（Cosine Sentence，苏剑林提出）采用了一种不同的思路：

> **不关心绝对分数，只关心排序：正例对的余弦分数应该高于负例对。**

具体来说，对于一个 batch 中的所有句子对，CoSENT 的损失函数要求：

**如果句子对 i 的标注相似度高于句子对 j，那么它们的余弦相似度也应该满足这个顺序。**

数学形式上，CoSENT 使用了一种类似于 Circle Loss 的排序损失：

$$\mathcal{L} = \log \left(1 + \sum\_{i \in \Omega\_{pos}, j \in \Omega\_{neg}} e^{\lambda(\cos\_j - \cos\_i + m)}\right)$$

其中：

* $$\Omega\_{pos}$$ 是正例对集合（标注相似度高于阈值）
* $$\Omega\_{neg}$$ 是负例对集合（标注相似度低于阈值）
* $$\cos\_i$$、$$\cos\_j$$ 是对应句子对的余弦相似度
* $$\lambda$$ 是温度系数
* $$m$$ 是 margin

**直觉上，**&#x6BCF;当某个负例对的分数接近或超过某个正例对的分数时，损失就会急剧增加。模型被迫把正例对和负例对在分数上拉开距离。

#### 4.3 与 Circle Loss 的关系

CoSENT 的损失函数和 Circle Loss 有密切关联。Circle Loss 的核心思想是：

> **对于每个正例-负例对，让它们的相似度分数之间有一个明确的 margin。**

传统的对比损失（如 Triplet Loss）只考虑一个 anchor 和一个正例、一个负例之间的关系。Circle Loss（和 CoSENT）则在一个 batch 中考虑所有正负例对的交叉关系，优化信号更稠密。

区别在于：Circle Loss 原本是为人脸识别等检索任务设计的，使用的是欧氏距离或内积；CoSENT 将其适配到了文本语义匹配场景，使用余弦相似度作为度量。

#### 4.4 为什么 CoSENT 在中文场景中效果更好？

**1. 中文语义匹配的标注数据通常较少。** CoSENT 的排序损失比 Softmax 分类损失更高效地利用了每个 batch 中的信息——它考虑了所有句子对的相对顺序，而不仅仅是每个句子对独立的标签。

**2. 中文 STS 数据集的标注一致性往往不如英文。** 不同标注者对"这两句话有多相似"的打分可能差异较大。CoSENT 只关心排序而不关心绝对分数，对标注噪声更鲁棒。

**3. 实验验证。** 在 ATEC、BQ、LCQMC、PAWSX、STS-B 等中文语义匹配基准上，CoSENT 持续优于 SBERT 的 Softmax 和 Cosine Loss。


# 跨模态相似度

### 1 跨模态相似度

现实世界的信息不只有文字。你在淘宝搜"红色连衣裙"，返回的是图片；你在 Google 看到一张猫的照片，脑子里自动浮现"猫"这个概念。**人类天然具备跨模态对齐的能力**，我们能轻松地在文字和图像之间建立语义关联。

对机器来说，这件事一点也不轻松：

文本可以被编码成离散的 token 序列，在语言语义空间中表征；图像则是连续的像素矩阵，在视觉特征空间中表征。文本编码器输出的向量和图像编码器输出的向量，**天生就不在同一个空间里，**&#x76F4;接算余弦相似度毫无意义。

### 2 CLIP

**CLIP**（Contrastive Language-Image Pre-training）是 OpenAI 在 2021 年发布的模型。CLIP **用对比学习的方式，预训练一个语言-图像模型**。

#### 2.1 双塔架构

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FSeKLcZBX84dkjvJGZLKf%2Fimage.png?alt=media&amp;token=d495869e-2a96-4842-9334-df5a7285229a" alt=""><figcaption></figcaption></figure>

* **Image Encoder**：接收一张图片，输出一个 d 维向量
* **Text Encoder**：接收一段文本，输出一个 d 维向量
* 两个向量**投影到同一个 d 维空间**，然后直接算余弦相似度

两个编码器互不干扰，但最终的输出被**对齐到同一个语义空间**。这就像两个翻译官，一个懂图像，一个懂文字，但他们把翻译结果都写成同一种"通用语言"。

CLIP 的训练数据叫 **WIT**（WebImageText），包含从互联网上爬取的约 **4 亿个图文配对**。

这些是网页上自然存在的图文关系：

* 图片的 alt 文本
* 图片附近的描述文字
* 社交媒体上图片配的文案

**CLIP 利用互联网的天然监督信号来学习**。数据虽然有噪声，但胜在量大、覆盖面广。

#### 2.2 对比学习：InfoNCE Loss

训练的核心是**对比损失**（Contrastive Loss），具体使用的是 InfoNCE Loss 的变体。

假设一个 batch 里有 N 个图文对。每个图文对 (I\_i, T\_i) 是正确的配对。训练目标是：

> **让正确配对的相似度高，让错误配对的相似度低。**

用一个 N×N 的相似度矩阵来理解：

```
              T_1    T_2    T_3    ...    T_N
    I_1    [ 0.9   0.1    0.05   ...   0.02 ]
    I_2    [ 0.05  0.85   0.1    ...   0.03 ]
    I_3    [ 0.02  0.08   0.92   ...   0.01 ]
    ...
    I_N    [ 0.01  0.03   0.02   ...   0.88 ]
```

* **对角线**上的值（I\_i 和 T\_i 的相似度）应该尽量**大**
* **非对角线**上的值（I\_i 和 T\_j 的相似度，i≠j）应该尽量**小**

损失函数同时从两个方向优化：

**图像→文本方向**（给定一张图，找对的文本）：

$$\mathcal{L}*{i2t} = -\frac{1}{N} \sum*{i=1}^{N} \log \frac{\exp(\text{sim}(I\_i, T\_i) / \tau)}{\sum\_{j=1}^{N} \exp(\text{sim}(I\_i, T\_j) / \tau)}$$

**文本→图像方向**（给定一段文本，找对的图像）：

$$\mathcal{L}*{t2i} = -\frac{1}{N} \sum*{i=1}^{N} \log \frac{\exp(\text{sim}(T\_i, I\_i) / \tau)}{\sum\_{j=1}^{N} \exp(\text{sim}(T\_i, I\_j) / \tau)}$$

最终损失取平均：

$$\mathcal{L} = \frac{1}{2}(\mathcal{L}*{i2t} + \mathcal{L}*{t2i})$$

其中 τ（temperature）是一个可学习的温度参数，控制分布的"尖锐程度"。

**直觉理解**：这其实就是一个 N 类分类问题。给定图像 I\_i，在 N 个候选文本中把正确的 T\_i "分类"出来；反过来也一样。batch size 越大，负样本越多，学到的表示越好——CLIP 原始训练的 batch size 是 **32768**。

#### 2.3 矩阵化的高效实现

对比学习的它的计算可以高度并行化：

```python
# 伪代码
# 1. 编码
image_features = image_encoder(images)        # (N, d)
text_features = text_encoder(texts)           # (N, d)

# 2. L2 归一化
image_features = image_features / image_features.norm(dim=-1, keepdim=True)
text_features = text_features / text_features.norm(dim=-1, keepdim=True)

# 3. 计算相似度矩阵
logits = (image_features @ text_features.T) * exp(log_temperature)  # (N, N)

# 4. 对称的交叉熵损失
labels = torch.arange(N)                      # [0, 1, 2, ..., N-1]
loss_i2t = cross_entropy(logits, labels)       # 每行的目标是对角线位置
loss_t2i = cross_entropy(logits.T, labels)     # 每列的目标是对角线位置
loss = (loss_i2t + loss_t2i) / 2
```

一个矩阵乘法 `@` 就算出了所有 N² 个相似度。

***

### 3 ViT

CLIP 的图像编码器有两个版本：ResNet 和 **ViT**（Vision Transformer）。

ViT 版本效果更好，也是后续被广泛采用的版本。

#### 3.1 ViT 的核心想法

ViT 的想法出奇地简单：**把图像当成一句话来处理**。

具体做法：

1. **切分 patch**：把一张 224×224 的图像切成 16×16 的小块（patch），得到 (224/16)² = **196 个 patch**
2. **线性投影**：每个 patch 被展平后通过一个线性层，映射成一个 d 维向量——这就是图像的 "token"
3. **加上位置编码**：告诉模型每个 patch 在图像中的位置
4. **加上 \[CLS] token**：在序列开头插入一个特殊的分类 token
5. **送入 Transformer**：标准的多层 Transformer encoder 处理这 197 个 token
6. **取 \[CLS] 输出**：最终 \[CLS] token 的输出向量就是整张图像的表示

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FSD0Fg9XiK22RNG8WvYUB%2Fimage.png?alt=media&amp;token=d4b833aa-ea21-4a5a-b1e1-fc1c955113f2" alt=""><figcaption></figcaption></figure>

#### 3.2 不同尺寸的 ViT

CLIP 提供了多种规格：

| 模型            | patch 大小         | 层数 | 隐藏维度 | 参数量    |
| ------------- | ---------------- | -- | ---- | ------ |
| ViT-B/32      | 32×32            | 12 | 768  | \~86M  |
| ViT-B/16      | 16×16            | 12 | 768  | \~86M  |
| ViT-L/14      | 14×14            | 24 | 1024 | \~304M |
| ViT-L/14\@336 | 14×14 (输入 336px) | 24 | 1024 | \~304M |

patch 越小，图像被切得越细，信息保留越多，效果越好——但计算量也更大（token 数量是 patch 大小平方的反比）。

### 4 文本编码器：Transformer + BPE

CLIP 的文本编码器是一个标准的 **Transformer**（类似 GPT 的 decoder-only 结构，使用 causal attention mask）：

* **Tokenizer**：使用 BPE（Byte Pair Encoding）分词，词表大小约 49152
* **最大长度**：77 个 token（包括 \[SOT] 和 \[EOT]）
* **输出**：取 \[EOT] token 位置的隐藏状态作为文本的整体表示

Image Encoder 和 Text Encoder 的输出维度可能不一样。CLIP 在两者之后各加了一个**线性投影层**（projection head），把它们投影到同一个 d 维空间（比如 512 维或 768 维），然后做 L2 归一化，再算余弦相似度。

CLIP 训练完之后，你得到的是两个对齐的编码器。这意味着你可以**自由组合**图像和文本来做各种事。

#### 4.1 零样本图片分类（Zero-Shot Classification）

**不需要任何标注数据，就能对图片进行分类**。

传统的图片分类是这样的：

1. 收集大量标注数据（比如 1000 类 ImageNet，每类 1000+ 张图）
2. 训练一个分类器
3. 只能识别这 1000 个类别

CLIP 的做法完全不同：

假设你要分类一张图片，候选类别是 \[猫, 狗, 鸟]，首先构造文本 prompt，然后用 Text Encoder 编码这几个prompt得到文本向量，然后用 Image Encoder 编码待分类的图片得到图片向量，然后计算图片向量于文本向量的余弦相似度，相似度最高的那个就是分类结果。

```python
import torch
from PIL import Image
import clip

# 加载模型
model, preprocess = clip.load("ViT-B/32")

# 准备图像
image = preprocess(Image.open("cat.jpg")).unsqueeze(0)

# 准备候选标签
texts = clip.tokenize(["a photo of a cat", "a photo of a dog", "a photo of a bird"])

# 编码
with torch.no_grad():
    image_features = model.encode_image(image)
    text_features = model.encode_text(texts)

# 归一化 + 计算相似度
image_features /= image_features.norm(dim=-1, keepdim=True)
text_features /= text_features.norm(dim=-1, keepdim=True)
similarity = (image_features @ text_features.T).softmax(dim=-1)

print(similarity)
# tensor([[0.92, 0.05, 0.03]])  → 猫！
```

这意味着：

* **类别可以随时更改**——不需要重新训练
* **类别可以是自然语言描述**——不局限于单个词
* 在 ImageNet 上，CLIP 的零样本准确率可以和专门训练的 ResNet-50 媲美

#### 4.2 文搜图 / 图搜文

**文搜图**：用户输入文本 query，在图片库中找最相关的图片。

```
流程：
1. 离线：把所有图片用 Image Encoder 编码成向量，存入向量数据库
2. 在线：用户输入文本 → Text Encoder 编码 → 在向量库中检索最近邻

"sunset over the ocean"  →  [0.23, -0.15, 0.87, ...]
                                    │
                                    ▼  向量检索
                              返回最相似的图片
```

**图搜文**：给定一张图片，找最相关的文本描述。流程和文搜图是对称的。

#### 4.3 图文匹配打分

给定任意一对 (图片, 文本)，CLIP 可以输出一个相似度分数，表示它们的语义匹配程度。

应用场景：

* **内容审核**：判断图片和标题是否一致
* **推荐系统**：衡量用户搜索词和商品图的匹配度
* **数据清洗**：在图文数据集中过滤掉不匹配的样本
* **生成模型的评估**：CLIP Score 被广泛用于评价文本生成图像的质量


# 大规模向量检索

> 我们已经知道如何把文本和图片变成向量，现在面临一个工程问题——**当你有 1 亿条向量时，怎么在毫秒级找到最相似的那几条？**

假设你有一个向量数据库，存了 N 条 d 维向量。给定一个查询向量 q，你要找到与 q 最相似的 k 条结果。

**暴力搜索**（Brute-force / Flat Search）的时间复杂度：**O(N × d)。**

**当面临超大规模的向量时和高并发时，系统会有无法忍受的响应时间。**

**所以，我们需要一种方法，不遍历所有向量，就能找到"大概率是最相似的"那几条。**

### 1 近似最近邻（ANN）

**ANN**（Approximate Nearest Neighbor）的核心是一个交易：

> **用一点点精度，换巨大的速度提升。**

什么叫"一点点精度"？假设暴力搜索返回的 top-10 是完美答案，ANN 返回的 top-10 可能有 9 个和完美答案重合——这就是 **90% 的召回率**（Recall\@10）。

ANN 算法的分类大致有三条路线：

* 基于划分： 把空间切成小块，只搜相关的块，如IVF（Faiss）、KD-Tree
* 基于树：用树结构递归划分空间，如Annoy（随机投影树）
* 基于图：构建临近图，沿图搜索，如HNSW、NSG、DiskANN
* 基于哈希：把向量映射成短编码，如LSH

### 2 Faiss

**Faiss**（Facebook AI Similarity Search）是 Meta 开源的向量检索库，几乎是工业界的事实标准。

它不是一个单一算法，而是一个**索引工具箱**，你可以像搭积木一样组合不同的策略。

#### 2.1 IndexFlat

IndexFlat 是最简单的暴力搜索基线

```python
import faiss
import numpy as np

d = 768          # 向量维度
N = 100000       # 向量数量

# 生成随机数据
vectors = np.random.random((N, d)).astype('float32')

# 创建暴力搜索索引
index = faiss.IndexFlatL2(d)   # L2 距离
# 或者 faiss.IndexFlatIP(d)   # 内积（余弦相似度用这个，但要先归一化）

index.add(vectors)             # 添加向量

# 搜索
query = np.random.random((1, d)).astype('float32')
distances, indices = index.search(query, k=10)  # 返回 top-10
```

* **IndexFlatL2**：用欧氏距离（L2）暴力搜索
* **IndexFlatIP**：用内积（Inner Product）暴力搜索

#### 2.2 IVF：倒排文件索引

**IVF**（Inverted File Index）的核心思想是：**把 N 个向量先用 K-Means 分成 nlist 个簇，查询时只搜最近的几个簇，而不是全部。**

**构建过程**

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FuSkvxtogpXnuLcuhtsoX%2Fimage.png?alt=media&amp;token=7b6373df-bd72-4a35-b3aa-e6febc5aad2f" alt=""><figcaption></figcaption></figure>

每个向量被分配到离它最近的聚类中心（centroid）。这就像是给向量建了一个"倒排索引"——每个簇就是一个倒排列表。

**查询过程**

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fs6VTYBcjz148rE5lNT5L%2Fimage.png?alt=media&amp;token=6430115b-b283-41c5-a480-6b2aca428b09" alt=""><figcaption></figcaption></figure>

计算查询向量和选中的聚类（黄色）中每个点的距离，选出top k个最近的，返回。

注意到，红色区域中有一个点和查询向量更接近【d\_2】，但是该点由于所在的聚类中心不如黄色聚类，所以不会被考虑。这里其实暴露出了IVF的不足——有时会损失最精确的结果，但从检索效率上来看，牺牲这一点精确度是值得的。

#### 2.3 PQ：乘积量化

IVF 解决了速度问题，但内存问题还在。1 亿条 768 维 float32 向量还是要 286 GB。

**PQ**（Product Quantization，乘积量化）的目标是：**把每个向量从几百字节压缩到几十字节，同时尽量保留距离信息。**&#x5B83;不是一次性量化整个高维向量（这通常会导致分辨率不佳），而是首先将向量分解成多个低维子向量。

假设有一个 $$D$$ 维空间中的原始向量 $$\mathbf{x}$$（$$\mathbf{x} \in \mathbb{R}^D$$）。PQ 将这个向量分成 $$M$$ 个不同的子向量，每个子向量的维度为 $$D/M$$。为简单起见，我们假设 $$D$$ 可以被 $$M$$ 整除。

$$
\mathbf{x} = \left\[ \mathbf{x}\_1 \mid \mathbf{x}\_2 \mid \cdots \mid \mathbf{x}\_M \right]
$$

这里，每个 $$\mathbf{x}\_m$$（$$1 \le m \le M$$）都是一个维度为 $$D/M$$ 的子向量。比如，一个 768 维的向量可以分成 $$M=48$$ 个子向量，每个维度为 $$D/M=16$$。

核心思想是独立地量化这 $$M$$ 个子空间中的每一个。对于每个子空间 $$m$$，我们创建一个独立的码本 $$C^m$$。这个码本包含 $$k^\*$$ 个代表向量（通常称为聚类中心），它们是该子空间特有的。这些聚类中心通常是使用 k-means 聚类算法，从与该子空间对应的子向量训练集中学习得到的。

$$
C^m = \left{ \mathbf{c}*{m,1}, \mathbf{c}*{m,2}, \ldots, \mathbf{c}\_{m,k^\*} \right}
$$

其中 $$\mathbf{c}\_{m,j} \in \mathbb{R}^{D/M}$$。

生成 $$M$$ 个码本后，任何原始向量 $$\mathbf{x}$$ 都可以被编码。向量 $$\mathbf{x}$$ 的每个子向量 $$\mathbf{x}\_m$$ 被映射到其在对应码本 $$C^m$$ 中最近聚类中心的索引（ID）。令 $$q\_m(\mathbf{x}\_m)$$ 为查找子向量 $$\mathbf{x}\_m$$ 在 $$C^m$$ 中最近聚类中心索引的函数：

$$
q\_m(\mathbf{x}\_m) = \underset{j \in {1,\ldots,k^\*}}{\arg\min} \left| \mathbf{x}*m - \mathbf{c}*{m,j} \right|^2
$$

原始向量 $$\mathbf{x}$$ 随后由 $$M$$ 个聚类中心索引序列表示：

$$
\text{编码}(\mathbf{x}) = \left\[ q\_1(\mathbf{x}\_1), q\_2(\mathbf{x}\_2), \ldots, q\_M(\mathbf{x}\_M) \right]
$$

每个索引 $$q\_m(\mathbf{x}\_m)$$ 需要 $$\log\_2(k^)$$ *位。如果我们选择 $$k^*=256$$，每个索引需要 8 位（1 字节）。因此，整个 D 维向量 $$\mathbf{x}$$ 被压缩成仅仅 M 字节。与存储原始 D 维 float32 向量（需要 $$D \times 4$$ 字节）相比，这代表了很大的压缩比，通常根据 $$D$$ 和 $$M$$ 的不同，范围在 10 倍到 100 倍之间。对于我们 768 维的例子，当 $$M=48$$ 时，压缩后的大小是 48 字节，而原始大小为 $$768 \times 4 = 3072$$ 字节，压缩因子为 64 倍。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fmm6vyd2UkaAWNSRIaepN%2Fimage.png?alt=media&amp;token=591c059c-a13e-4e16-a692-daea18f0f36b" alt=""><figcaption></figcaption></figure>

### 3 Annoy：随机投影树

**Annoy**（Approximate Nearest Neighbors Oh Yeah）是 Spotify 开源的 ANN 库。

Annoy的设计目标非常明确：

* **低内存占用**：索引可以通过内存映射（mmap）方式加载，多个进程可以共享同一份索引，极大降低内存开销
* **高查询速度**：通过树结构快速缩小搜索范围
* **易于使用**：简单的API，便于集成到生产系统

#### 3.1 单棵随机投影树的构造

Annoy 的核心数据结构是**随机投影树**（Random Projection Tree），构造过程如下：

```
所有向量（叶子节点还没分裂前）
    │
    ▼  随机选两个点 A 和 B
    │
    ▼  计算 A、B 的中垂面（超平面），把空间一分为二
    │
    ├── 左子树：在超平面"A 侧"的向量
    └── 右子树：在超平面"B 侧"的向量
    │
    ▼  对左、右子树递归执行上述过程
    │
    ▼  直到每个叶子节点包含的向量数 ≤ K（比如 K=100）
```

图示：

```
        ┌─────────────────────┐
        │      全部向量         │
        │    ·  ·    ·  ·     │
        │  ·    ·  ·    ·  ·  │
        │    ·   /   ·  ·     │   ← 随机超平面把空间切开
        │  ·   /  ·    ·      │
        │    /  ·    ·   ·    │
        └──/──────────────────┘
          /
    左半空间          右半空间
    ┌──────┐        ┌──────┐
    │· · · │        │· · · │
    │ · ·  │        │ · · ·│
    └──────┘        └──────┘
       │                │
       ▼                ▼
    继续切...        继续切...
```

查询时，从根节点开始，判断查询向量在超平面的哪一侧，一路走到叶子节点，返回叶子里的向量作为候选。

#### 3.2 问题：边界上的点怎么办？

单棵树有一个明显的缺陷：如果查询点恰好在分割超平面附近，最近邻可能被分到了另一侧。

```
        ─────────/──────────
              · /  · ← 最近邻
              /
          q · /          ← 查询点在左边，但最近邻在右边！
              /
        ─────────/──────────
```

#### 3.3 解决方案：多棵树的集成

Annoy 的解决方法简单粗暴——**建多棵树，每棵树用不同的随机超平面**：

```
Tree 1: 用超平面 H1 切分 → 查询落入叶子 L1 → 候选集 C1
Tree 2: 用超平面 H2 切分 → 查询落入叶子 L2 → 候选集 C2
Tree 3: 用超平面 H3 切分 → 查询落入叶子 L3 → 候选集 C3
...
Tree T: 用超平面 HT 切分 → 查询落入叶子 LT → 候选集 CT

最终候选集 = C1 ∪ C2 ∪ C3 ∪ ... ∪ CT（去重）
在候选集上暴力搜索 → 返回 top-k
```

因为每棵树的随机超平面不同，同一个点在不同树中被分到不同的叶子。多棵树的并集大大降低了"漏掉最近邻"的概率。

**树的数量**是精度与速度的旋钮：

* 树越多 → 候选集越大 → 召回率越高 → 但搜索越慢、内存越多
* 通常 10\~100 棵树就够用

#### 3.4 使用示例

```python
from annoy import AnnoyIndex
import numpy as np

d = 768
N = 1000000

# 构建索引
index = AnnoyIndex(d, 'angular')  # 'angular' = 余弦距离, 'euclidean' = L2

for i in range(N):
    v = np.random.random(d).astype('float32')
    index.add_item(i, v)

index.build(n_trees=50)       # 构建 50 棵树
index.save('index.ann')       # 保存到磁盘

# 加载与查询
index = AnnoyIndex(d, 'angular')
index.load('index.ann')       # mmap 加载，几乎不占内存

results = index.get_nns_by_vector(query, n=10, search_k=5000)
# search_k：总共检查多少个节点（越大越精确）
```

#### 3.5 Annoy 的优势与局限

**优势：**

* **只读索引 + mmap 加载**：索引文件可以在多个进程间共享，加载几乎不额外占内存
* **极其轻量**：依赖少，编译简单，适合嵌入式或资源受限的环境
* **可预测的内存占用**：内存 ≈ 原始向量大小 × 树的数量
* **适合静态数据**：一次构建，多次查询

**局限：**

* **不支持动态增删**：索引构建后不能添加新向量（需要重建）
* **精度不如 HNSW**：在同等内存下，召回率一般低于 HNSW
* **高维向量效果下降**：随机投影在高维空间的分割效率递减

***

### 4 HNSW：多层导航小世界图

**HNSW**（Hierarchical Navigable Small World）是目前综合性能最强的 ANN 算法之一。它基于图结构，核心灵感来自"小世界网络"。

#### 4.1 小世界网络的直觉："六度分隔"

1960 年代，社会心理学家 Stanley Milgram 做了一个著名实验：让美国中西部的人通过"认识的人"把一封信传递给波士顿的一个陌生人。结果发现，平均只需要 **6 次传递**就能到达——这就是"六度分隔"理论。

社交网络就是一个**小世界网络**：

* 大多数人只认识附近的人（**局部连接**）
* 但总有少数人认识远方的人（**长程连接**）
* 这两种连接的结合，让任意两人之间的距离很短

**HNSW 的核心直觉就是：把向量之间的邻近关系构建成一个类似社交网络的图，然后在图上"传话"一样地搜索。**

#### 4.2 NSW：可导航小世界图

在讲"H"（层次化）之前，先理解基础版 **NSW**（Navigable Small World）。

**图的构建**

每个向量是图中的一个节点。插入新节点 v 时：

1. 从图中已有的某个入口点出发
2. 贪心地沿着图走，不断跳到离 v 更近的邻居
3. 到达局部最优后，把 v 与它附近的 M 个节点连边

```
已有图中的节点：A—B—C—D—E

插入新节点 v：
1. 从入口 A 出发
2. A 的邻居里，B 离 v 更近 → 跳到 B
3. B 的邻居里，C 离 v 更近 → 跳到 C
4. C 的邻居里没有比 C 更近的了 → 停下
5. 把 v 与 C、B、D 连边（M=3）

结果：A—B—C—D—E
            |\ |
            v──┘
```

**查询过程**

和构建一样的贪心搜索：

1. 从入口点出发
2. 检查当前节点的所有邻居
3. 跳到离查询向量最近的邻居
4. 重复，直到无法再前进（局部最优）
5. 维护一个候选列表，返回 top-k

#### 4.3 从 NSW 到 HNSW：加上层次结构

纯 NSW 有一个问题：图中所有节点都在同一层，早期插入的节点因为连接多会变成"高速公路"，但随着图增大，搜索可能需要经过很多跳才能到达目标区域。

**HNSW 的解决方案：构建多层图，高层做粗定位，低层做精搜索。**

```
Layer 3 (最稀疏):    [A] ─────────────── [G]
                      │                    │
Layer 2:         [A] ─── [D] ──── [G] ─── [J]
                  │       │        │       │
Layer 1:     [A]─[B]─[D]─[E]─[G]─[H]─[J]─[K]
                  │   │   │   │   │   │   │
Layer 0 (全部):  所有 N 个节点都在这一层，连接最密集
```

**层的分配规则**

每个节点被分配到哪一层由随机过程决定：

* **每个节点都在 Layer 0**
* 以概率 p（通常 p = 1/ln(M)）升到 Layer 1
* 以概率 p² 升到 Layer 2
* 以此类推...

这产生了一个**指数递减**的层次结构：

* Layer 0：N 个节点（全部）
* Layer 1：约 N/M 个节点
* Layer 2：约 N/M² 个节点
* ...

越高层节点越少，连接跨度越大——就像地图的不同缩放级别。

**查询流程**

```
查询向量 q

Layer 3: 从入口节点开始，贪心搜索 → 找到该层最近的节点 P3
            │
            ▼  下沉到 Layer 2，从 P3 开始
Layer 2: 贪心搜索 → 找到更精确的节点 P2
            │
            ▼  下沉到 Layer 1
Layer 1: 贪心搜索 → 找到 P1
            │
            ▼  下沉到 Layer 0
Layer 0: 在最密集的图上贪心搜索 → 找到 top-k 近邻
```

**类比**：就像你在地图上找一个餐馆——

* 先看世界地图（Layer 3）：确定在亚洲
* 再看国家地图（Layer 2）：确定在中国上海
* 再看城市地图（Layer 1）：确定在浦东新区
* 最后看街道地图（Layer 0）：找到具体地址

每一层都在缩小搜索范围，而不是在最细粒度的地图上从头找起。

HNSW 之所以能接近暴力搜索的召回率，有几个关键原因：

**1. 图结构天然保留了邻近关系**

和 IVF 的硬划分不同，图中的边直接连接了相似的向量。不存在"被分到错误的簇"的问题。

**2. 贪心搜索 + beam search**

实际实现中，HNSW 不只维护一个当前最优节点，而是维护一个大小为 ef 的候选列表（类似 beam search）。ef 越大，搜索越彻底。

```
ef = 1   → 纯贪心，最快但可能陷入局部最优
ef = 50  → 同时追踪 50 个候选路径，大幅提升召回率
ef = 500 → 接近暴力搜索的精度
```

**3. 层次结构避免了局部最优**

高层的长程连接让搜索可以快速跳到目标区域，避免在低层的局部区域里打转。

但是 HNSW 的高召回率不是免费的：

**内存占用大**：每个节点需要存储它的邻居列表。假设每个节点平均有 M 个邻居，每个邻居 ID 用 4 字节：

```
额外内存 = N × M × 4 bytes × 层数
1 亿节点，M=32 → 约 12.8 GB 仅用于存边（还没算向量本身）
```

加上原始向量（286 GB），总内存可达 **\~300 GB**。不做压缩的话，HNSW 是最吃内存的。

**构建索引慢**：每插入一个节点都要做一次搜索来找邻居，构建 1 亿条向量的索引可能要**数小时**。

**不支持高效的向量压缩**：原生 HNSW 存的是完整向量。虽然可以和 PQ 结合（如 Faiss 的 IndexHNSWPQ），但效果不如 IVF+PQ 那么自然。

### 参考

1. <https://blog.csdn.net/m0_37586991/article/details/157067888>
2. <https://apxml.com/zh/courses/advanced-vector-search-llms/chapter-1-ann-algorithms/product-quantization-mechanics>
3. <https://datawhalechina.github.io/easy-vecdb/base/chapter5/Annoy%E7%AE%97%E6%B3%95.html>


# RAG


# RAG 完整链路

很多人会对 RAG 产生一种错觉：只要把文档切分一下，存进向量库，再把检索结果塞进上下文，模型就做到了“基于知识库回答问题”。

这个错觉通常来自 demo 场景。

Demo 里的文档是干净的，问题是提前设计好的，答案也刚好在某个段落里。只要检索能命中那个段落，模型看起来就很聪明。这种 Demo 场景很适合向上汇报或者对外演示，甚至23年24年的时候，有些企业仅凭一些预制的问题，就能够拉到不菲的投资。

但一旦进入真实业务场景，问题会立刻变复杂：用户问法是模糊不固定的，文档质量参差不齐，知识版本互相冲突，权限需要隔离，答案需要是有来源的，成本还不能失控。

所以，做 RAG 项目时，不要去在意用什么框架，用什么 embedding 模型，关键在于**如何把一堆不稳定的文档、问题和模型输出，组织成一个可靠、可评估、可追踪的回答系统。**

### 1 常见的 RAG 系统的问题

#### 1.1 召回不到

比如用户问“报销差旅有什么限制”，文档里写的是“交通与住宿费用规范”。从语义上看是同一件事，但如果文档切分、embedding、查询改写或检索策略做得不好，系统可能根本找不到正确段落。

召回不到，是 RAG 最致命的问题之一。因为后面用于回答的模型再强，也只能基于拿到的上下文回答。**检索阶段没拿到问题相关的证据，回答阶段就只能依靠模型自身知识，甚至拿到的文本还可能污染上下文。**

#### 1.2 召回太多

为了解决召回不到的问题，很多人会把 Top-K 调大，从 5 改成 10，再改成 20，再到100。

这会带来另一个问题：召回内容变多了，但相关内容的密度下降了。模型看到一堆相似、重复、过期、甚至互相矛盾的片段，反而更容易答错。

#### 1.3 上下文污染

上下文污染指的是：系统检索到了看似相关、但实际上会误导模型的内容。

比如：

* 过期的文档被召回了；
* 草稿文档被召回了；
* 另一个部门的规则被召回了；
* 相似产品的说明被召回了；
* 用户没有权限看的内容被召回了。

这些内容一旦进入 Prompt，模型通常不会主动判断“这段材料是否应该被使用”。它会把它们当成上下文的一部分，然后生成一个看似合理但实际错误的答案。

#### 1.4 答案幻觉

很多人以为加了 RAG 就不会幻觉。其实不是。

RAG 只能降低幻觉概率，不能自动消除幻觉。如果检索结果不完整，模型可能补全缺失信息；如果上下文有冲突，模型可能选择错误的一边；如果 Prompt 没有明确要求“没有依据就说不知道”，模型可能强行给出答案。

因此，通常需要明确约束模型：**只能基于给定证据回答，证据不足时必须拒答或说明不确定。**

#### 1.5 引用不准

有些系统会在答案后面挂几个来源链接，但这些来源只是“被检索到的文档”，并不一定真的支持答案里的每一句话。这会造成一种非常危险的错觉：答案看起来有引用，但引用并不能证明答案正确。

好的引用不是“列出来源”，而是要做到：答案中的关键事实，能回溯到具体文档、具体段落，最好还能定位到页码、章节或 chunk。

### 2 RAG 的上下文工程

最基础的 RAG 链路通常长这样：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FoAkOlCyGuZ48oRIUUl9o%2Fimage.png?alt=media&amp;token=79faf35c-ab60-48ac-9b71-8873fad2cf09" alt=""><figcaption></figcaption></figure>

可以分成两条链路：**离线索引链路和在线问答链路。**

它的问题也很明显：它默认“向量相似度高”就等于“能回答问题”，“Top-K 检索结果”就等于“可用上下文”，“模型看到上下文”就会“忠实回答”。

从效果上看，RAG 的核心其实是上下文工程。

所谓上下文工程，就是围绕一个目标做设计：**在模型生成答案之前，给它准备一组干净相关的证据。**

#### 1. Chunk size

Chunk 太小，语义容易断裂。比如一个条款的定义在上一段，适用条件在下一段，如果切得太碎，单个 chunk 就无法独立回答问题。

Chunk 太大，噪声又会增加。一个 chunk 里如果塞进太多主题，向量表示会被稀释，检索时可能“看起来相关”，但真正有用的信息只占很小一部分。

经验上，chunk size 不应该只按字符数决定，而应该结合文档结构。合同、论文、FAQ、API 文档、会议纪要，适合的切分方式都不一样。

好的切分不是每 512 字切一刀，而是尽量保持语义单元完整：标题、章节、条款、表格、问答对、代码块，都应该被当成结构来处理。

#### 2. Overlap

Overlap 的作用是防止关键信息刚好被切在两个 chunk 边界上。但 overlap 太大，会带来重复召回。模型看到多个高度相似的片段，不仅浪费 token，还可能把重复内容当成“更重要的证据”。

Overlap 应该服务于语义连续性，而不是粗暴增加冗余。

#### 3. Metadata

很多 demo 只存 chunk text 和 embedding。生产系统不能这么简单。

至少应该存：

* 文档 ID
* 来源系统
* 标题
* 章节路径
* 创建时间
* 更新时间
* 版本
* 权限标签
* 业务线
* 语言
* 文档类型
* 页码或段落位置

Metadata 的价值是让系统能过滤、排序和追踪。

比如用户问“最新版报销制度”，系统就应该优先召回最新版本，而不是历史版本。用户属于 A 部门，就不应该检索 B 部门的内部文档。用户问合同第 8 条，系统就应该能定位到具体条款，而不是只返回一段模糊相似的文本。

#### 4. Query Rewrite

用户问题通常不是检索友好的问题，而且往往很口语化：

* “这个能报吗？”
* “上次那个政策现在还有效吗？”
* “如果提前解约怎么办？”
* “他们之前说的那个限制是什么？”

这些问题直接拿去向量检索，效果通常不稳定。因为它们缺少主语、上下文和关键词。

Query Rewrite 的作用，是把用户问题改写成更适合检索的问题。

例如：

用户问：“这个能报吗？”

结合对话历史，可以改写成：“员工出差期间网约车费用是否可以报销？报销条件和限制是什么？”

用户问：“提前解约怎么办？”

可以改写成：“合同提前终止的条件、违约责任和通知期限是什么？”

Query Rewrite 的目的是让检索意图更清楚。

#### 5. Hybrid Search

向量检索擅长语义相似，但它不一定擅长精确匹配。

比如用户问：

* “ISO 27001 第 8.1 条是什么？”
* “订单号 AB20240517 的状态是什么？”
* “Python SDK 里 create\_session 参数怎么用？”

这些问题里有大量精确词、编号、代码、实体名。只靠向量检索，可能会错过关键词完全匹配的内容。

所以生产 RAG 常用 hybrid search，也就是把向量检索和关键词检索结合起来。向量检索负责语义召回，BM25 或倒排索引负责精确匹配，再通过合并策略或 rerank 得到最终候选结果。

#### 6. Rerank

检索通常分两阶段。第一阶段负责召回，目标是“不要漏掉可能相关的内容”。第二阶段负责重排，目标是“把真正能回答问题的内容排到前面”。

Reranker 可以是 cross-encoder，也可以是轻量模型，甚至可以用 LLM 做判断。它用来判断这个 chunk 是否真的能支持回答这个问题。

从使用效果上来判断，高质量 rerank 方法比 embedding 模型更管用。

#### 7. Context Compression

最后进入 LLM 的上下文，不应该只是 Top-K chunk 的简单拼接。

更好的做法是构造上下文，常见的做法有：

1. 去重
2. 过滤无关句子
3. 保留关键证据
4. 按主题或时间排序
5. 保留来源信息
6. 压缩长段落
7. 把冲突信息显式标出来
8. 把表格、列表、条款转换成模型更容易理解的格式

### 3 RAG 的评估

RAG 链路太长了。一个错误答案可能来自切分问题、embedding 问题、检索问题、rerank 问题、上下文构造问题，也可能来自模型生成问题。缺乏合理的评测模式，对于优化整个系统而言，你将无从下手。

Amplify Partners 的 2025 AI Engineering Report 提到，70% 的受访者正在以某种形式使用 RAG；在监控与可观测性方面，60% 的受访者使用标准 observability，超过 50% 依赖离线 eval；在评估模型和系统准确性时，人类 review 仍然是最常见方法。

RAG 评估可以拆成四类。

#### 3.1 检索评估

检索评估需要回答的问题是：**系统有没有把正确证据找出来？**

常见指标包括：

* Recall\@K：正确证据是否出现在 Top-K 里
* Precision\@K：Top-K 里有多少是真相关内容
* MRR：第一个正确结果排在多靠前
* nDCG：排序质量如何
* Hit Rate：是否至少命中一个正确证据

#### 3.2 生成评估

生成评估需要回答的问题是：**模型有没有基于证据正确回答？**

常见维度包括：

* 答案是否相关
* 答案是否完整
* 答案是否忠实于上下文
* 是否出现上下文之外的编造
* 引用是否支持关键结论
* 证据不足时是否会说不知道

#### 3.3 端到端评估

端到端需要评估回答的是：**用户任务有没有完成？**

比如客服场景，用户是否得到可执行解决方案；法务场景，答案是否定位到正确条款；研发文档场景，代码示例是否可运行；企业知识库场景，员工是否能根据答案完成流程。

端到端评估比单点指标更贴近业务价值，因为用户最终关心的不是 Recall\@K，而是能否用这个答案解决问题。

#### 3.4 线上监控

上线后，RAG 还需要持续监控。

要记录的不只是最终答案，还包括：用户问题、改写后的 query、召回的 chunk ID、检索分数、rerank 分数、最终进入上下文的内容、模型输出、引用来源、用户反馈、token消耗等等。

当用户点踩一个答案时，回看整条链路就能知道：是没召回到？召回到了但排序低？排序对了但上下文被压缩掉？上下文正确但模型答偏了？只有链路可观测，RAG 优化才能从玄学变成工程系统。

### 4 生产级 RAG

一个更接近生产环境的 RAG 链路，可以画成这样：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FU1f45dhPduTSYVPcH9k6%2Fimage.png?alt=media&amp;token=3605a9c1-b898-4b9b-87af-56a551d877ef" alt=""><figcaption></figcaption></figure>

### 参考

1. <https://www.amplifypartners.com/blog-posts/the-2025-ai-engineering-report>


# Agentic RAG

### 1 为什么需要 Agentic RAG

RAG 的核心思想是，把语言模型的**参数化记忆**和外部知识库的**非参数化记忆**结合起来，从而在知识密集型任务上获得更好的事实性和可更新性。

我们之所以需要RAG，是因为大模型本身有几个天然限制：

1. 模型参数里的知识会过时
2. 模型很难给出可靠出处
3. 领域私有知识通常不在预训练语料里

RAG 给大模型接了一套外部知识访问机制。但早期或者最常见的 Naive RAG 有一个很大的假设：**用户的问题可以通过一次检索解决。**

典型流程是：

```
Query -> Embedding -> Vector Search Top-K -> 拼接 Prompt -> LLM Answer
```

这在简单场景里够用，但在复杂场景里不够。

比如用户问：

> “我们最近几个客户流失案例里，最主要的共同原因是什么？和产品文档、客服记录、销售反馈能不能对上？”

这个问题不是一次向量检索能解决的。它至少包含：

* 需要识别“最近几个客户流失案例”
* 需要分别查 CRM、客服工单、销售记录、产品文档
* 需要对多类证据做归因
* 需要判断哪些信息可靠、哪些只是个案
* 需要最后给出可追溯的结论

而这，就是 Agentic RAG 要解决的问题。

### 2 Agentic RAG 是什么？

**Agentic RAG 是一种把 Agent 的规划、工具调用、反思、验证能力引入 RAG 流程的架构，让系统能够动态决定何时检索、检索什么、去哪里检索、是否继续检索，以及如何验证最终答案。**

Agentic RAG 是一次动态循环：

```
Plan, retrieve, evaluate, revise, retrieve again, verify, then answer.
```

这和 ReAct 的思想很接近。ReAct 论文提出让语言模型交错地产生 reasoning traces 和 actions：推理帮助模型规划、跟踪、更新行动，行动则让模型访问外部知识库或环境获取额外信息。

放到 RAG 里，action 就可以是：

* 搜向量库
* 搜关键词索引
* 查 SQL 数据库
* 查知识图谱
* 调用内部 API
* 访问网页
* 读取代码仓库
* 查日志系统
* 读取历史对话
* 调用 reranker
* 调用 fact checker
* 触发二次检索

总结来说，Agentic RAG 的关键是让模型拥有一个**检索决策循环**。

### 3 Agentic RAG 的典型架构

一个工程上可落地的 Agentic RAG 系统，可以画成这样：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FpYs1UQaKQT0WXxwD5ONw%2Fimage.png?alt=media&amp;token=0466b651-9909-4540-9aa7-7b6ecc54d8db" alt=""><figcaption></figcaption></figure>

这张图的关键是两个循环：

第一个循环是：

```
Planner -> Retriever -> Evidence Evaluator -> Planner
```

解决的问题是：Evidence 不够怎么办？

第二个循环是：

```
Generator -> Verifier -> Planner
```

解决的问题是：答案不可靠怎么办？

### 4 Agentic RAG 的核心能力

#### 4.1 判断是否需要检索

不是所有问题都需要 RAG。

例如：“帮我把这句话润色一下。”不需要检索，模型直接回答就行了。

但如果用户问：“我们公司最新的报销政策是什么？”就必须检索。

普通 RAG 往往默认所有问题都检索，这会带来两个问题：

1. 浪费成本和延迟。
2. 引入不相关上下文，反而干扰模型。

Agentic RAG 的一个重要思想就是按需检索，而不是对每个输入都固定检索。

工程上可以做一个轻量级 router：

* 无需检索：写作、翻译、格式转换、通用解释
* 需要检索：事实查询、企业知识、时间敏感问题、需要引用的问题
* 需要多步检索：比较、归因、综合分析、多源交叉验证

#### 4.2 查询改写与问题拆解

用户的问题通常不是一个好的搜索 query。

用户会问：“这个方案为什么之前没推下去？”

Agentic RAG 需要先把用户问题转成一组可检索的子问题。

例如：

```
1. A 客户最近一次续约沟通记录是什么？
2. CRM 中记录的流失原因是什么？
3. 客服工单中是否出现高频问题？
4. 销售是否提到竞品或价格因素？
5. 产品使用数据是否显示活跃度下降？
6. 这些证据之间是否一致？
```

#### 4.3 工具选择

很多 RAG 系统一开始就把所有问题都丢给向量库。但真实业务知识往往分布在多种系统里：

| 数据类型     | 更适合的检索方式              |
| -------- | --------------------- |
| 文档、手册、制度 | 向量检索 + 关键词检索          |
| 数值报表     | SQL / BI 查询           |
| 实体关系     | Knowledge Graph       |
| 工单、日志    | 关键词检索 + 聚合统计          |
| 代码仓库     | 代码搜索 + AST / repo map |
| 实时信息     | API / Web Search      |
| 跨文档主题    | Graph RAG / 聚类摘要      |

Agentic RAG 的 router 应该根据问题选择工具，而不是无脑搜向量库。

#### 4.4 多轮检索与证据充分性判断

Agentic RAG 最重要的能力之一，是判断现在的证据够不够回答.

在真实系统里，检索结果可能有四种情况：

| 检索结果     | 系统应该怎么做       |
| -------- | ------------- |
| 证据充分且一致  | 直接生成答案        |
| 证据相关但不完整 | 继续检索          |
| 证据互相冲突   | 查更权威来源或标注冲突   |
| 证据不相关    | 改写 query 或换工具 |

一个普遍的做法是引入轻量级检索评估器，对检索结果质量打分，并根据置信度触发不同动作。

工程上可以设计一个 evidence evaluator，让它输出结构化结果：

```json
{
  "relevance": 0.82,
  "coverage": 0.65,
  "conflict": true,
  "missing_evidence": [
    "缺少客户最后一次续约会议记录",
    "缺少产品使用数据"
  ],
  "next_action": "retrieve_more"
}
```

这个 evaluator 不应该只问“大模型你觉得够了吗”。更可靠的方式是结合规则、检索分数、引用覆盖率、来源优先级和 LLM judge。

#### 4.5 生成后的验证

Agentic RAG 不应该在生成答案后就结束。因为即使检索结果正确，模型仍然可能：

* 错误归因；
* 把弱证据说成强结论；
* 引用了不存在的来源；
* 把多个来源混在一起；
* 忽略时间顺序。

RAG 并不能彻底消除幻觉。RAG 评估研究也强调，RAG 系统评估不能只看最终答案，还要同时评估检索质量、事实一致性、安全性和计算效率。

所以生产级 Agentic RAG 至少需要三类验证：

| 验证类型 | 要回答的问题              |
| ---- | ------------------- |
| 引用验证 | 答案里的每个关键断言是否能被引用支持？ |
| 事实验证 | 答案是否忠实于检索内容？        |
| 任务验证 | 是否真正回答了用户的问题？       |

像 ARES 等 RAG 自动评估框架把评估拆成 context relevance、answer faithfulness、answer relevance 等维度，这种拆法很适合落到 Agentic RAG 的 verifier 中。

### 5. Agentic RAG 的工程难点

#### 5.1 延迟变高

Agentic RAG 的多轮流程天然增加延迟。

工程上可以做几件事：

* 并行检索多个数据源；
* planner 用小模型；
* evaluator 用小模型或规则模型；
* 高频问题走缓存；
* 简单问题走普通 RAG；
* 复杂问题才进入 Agentic RAG；
* 对 Top-K 先粗排，再对少量候选做 rerank。

#### 5.2 上下文越来越长

Agentic RAG 在多轮检索和迭代推理之后，往往会积累大量候选材料。但上下文越长，并不意味着答案质量越高。

一方面，模型的注意力和利用能力并不是均匀分布在整个输入上的。*Lost in the Middle* 的研究表明，长上下文模型对输入中间位置的信息利用并不稳定：当关键信息出现在开头或结尾时，模型更容易正确使用；而当相关信息被埋在中间时，性能可能明显下降。

因此，Agentic RAG 不能简单地把所有检索结果都塞进 prompt。真正重要的不是“检索到了多少”，而是“最终放进上下文的内容是否足够相关、足够紧凑、足够可引用”。

更合理的流程应该是：

> **retrieve broad, rerank carefully, compress selectively, cite precisely.**

也就是说，检索阶段可以尽量放宽，保证召回足够多的潜在证据；但进入上下文之前，必须经过严格重排、去重和筛选。对于冗长材料，还需要进行有选择的压缩，只保留回答问题所必需的论点、事实和出处。最终生成答案时，也要精确引用证据，而不是笼统地依赖一整段未经整理的上下文。

#### 5.3 Agent 过度行动

Agentic RAG 最大的问题之一，是 Agent 可能过度行动。

它可能：

* 不停改写 query；
* 查无关数据源；
* 在证据足够时仍继续检索；
* 被工具输出里的 prompt injection 影响；
* 把低质量来源当成权威来源；
* 为了完成任务而“编造”中间结论。

所以 Agentic RAG 必须有边界，比如设置工具白名单、数据源权限控制、最大循环次数等等。生产系统里的 Agentic RAG，最好不是“完全自治智能体”，而是“受控的检索状态机”。

### 6 Agentic RAG 的典型模式

#### 6.1 Router RAG

先判断问题类型，再选择路径。‘

* 简单事实问题 -> 普通 RAG
* 复杂分析问题 -> Agentic RAG
* 结构化数据问题 -> Text-to-SQL
* 全局总结问题 -> Graph RAG
* 无需外部知识 -> 直接 LLM

适合大多数生产系统。

#### 6.2 Multi-Hop RAG

把问题拆成多个子问题，逐步检索。

例如问题：A 公司为什么收购 B 公司？

子问题：

1. A 公司最近战略方向是什么？
2. B 公司核心资产是什么？
3. 双方业务是否互补？
4. 市场和财务动机是什么？
5. 管理层公开表述是什么？

适合研究、投研、法律、医疗、科研问答。

#### 6.3 Corrective RAG

先检索，再判断检索结果质量。如果质量不够，就纠错。

```
retrieve
-> grade documents
-> if irrelevant: rewrite query
-> if incomplete: retrieve more
-> if conflicting: search authoritative source
-> generate
```

#### 6.4 Self-Reflective RAG

模型不仅生成答案，还评估：

```
我是否需要检索？
检索内容是否相关？
我的答案是否被证据支持？
```

Self-RAG 是这一方向的代表，它通过自我反思机制提升事实性和引用质量。

#### 6.5 Graph Agentic RAG

当问题涉及实体关系、跨文档归因、全局主题时，可以把知识图谱和 Agentic RAG 结合起来。

```
文档 -> 实体抽取 -> 关系图谱 -> 社区摘要 -> 图检索 -> 多跳推理
```

GraphRAG 适合回答“整批文档说明了什么”这类问题，而不只是“哪一段文档包含答案”。

### 参考

1. [Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection](https://arxiv.org/abs/2310.11511?utm_source=chatgpt.com)
2. [Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks](https://arxiv.org/abs/2005.11401?utm_source=chatgpt.com)
3. [ReAct: Synergizing Reasoning and Acting in Language Models](https://arxiv.org/abs/2210.03629?utm_source=chatgpt.com)
4. [Active Retrieval Augmented Generation](https://arxiv.org/abs/2305.06983?utm_source=chatgpt.com)
5. [Corrective Retrieval Augmented Generation](https://arxiv.org/abs/2401.15884)
6. [Adaptive-RAG: Learning to Adapt Retrieval-Augmented Large Language Models through Question Complexity](https://arxiv.org/abs/2403.14403)
7. [From Local to Global: A Graph RAG Approach to Query-Focused Summarization](https://arxiv.org/abs/2404.16130)
8. [Retrieval Augmented Generation Evaluation in the Era of Large Language Models: A Comprehensive Survey](https://arxiv.org/abs/2504.14891)


# Graph RAG

## Graph RAG

Graph RAG 入门：从文本块到知识图谱，解决全局问题

很多人第一次听到 Graph RAG，会以为它就是“RAG + Neo4j”：把文档切块之后，再抽几个实体和关系，存进图数据库，查询时做一下图遍历。

这个理解不算错，但只说到了一半。

Graph RAG 真正重要的地方，不是“用了图数据库”，而是它改变了 RAG 的默认假设。

普通 RAG 默认答案藏在某几个 chunk 里，所以只要把和问题最相似的 Top-K chunk 找出来，再交给 LLM 总结就行。Graph RAG 认为：很多问题的答案并不藏在某几个 chunk 里，而是藏在整个语料的结构里。你必须先理解文档之间的实体、关系、主题和社区，才能回答这类问题。

这篇文章讲清楚 Graph RAG 解决什么问题、核心流程是什么、它和普通 RAG / Agentic RAG 的区别，以及实际落地时最容易踩的坑。

#### 1 普通 RAG 的盲区：全局问题

普通 RAG 最擅长的是局部问题。

比如：

> “合同第 8 条关于提前终止怎么写？”
>
> “Chamomile 有什么疗效？”
>
> “Python SDK 里 create\_session 参数怎么用？”

这些问题通常有一个明确答案，答案也大概率出现在某个文档片段里。只要检索能命中对应 chunk，后面的生成就比较简单。

但真实业务里经常出现另一类问题：

> “这批客户流失的共同原因是什么？”
>
> “过去两周的产品反馈里，最值得关注的风险是什么？”
>
> “这家公司内部文档反映出的主要组织问题是什么？”
>
> “最近几个安全事故之间有没有共同模式？”

这些问题不是在问“某个事实在哪里”，而是在问“整个数据集呈现出什么模式”。

这就是 Graph RAG 论文里强调的 **global question**。它不是普通检索问题，而更像 query-focused summarization：围绕一个问题，对整个语料做有目标的总结。

普通向量 RAG 处理这类问题会出现三个问题。

**1.1 Top-K chunk 不代表整体**

如果用户问“主要主题是什么”，向量检索会找出和“主题”“主要”这类词语最相似的 chunk。但这些 chunk 只是局部相似，不一定代表整个语料。

这就像你想了解一本书的核心思想，却只翻到了几页出现“总结”“观点”“主题”的段落。它们可能很相关，但不能代表全书。

**1.2 调大 Top-K 也不能真正解决**

很多人遇到全局问题时，会直接把 Top-K 从 5 改成 20、50、100。

这会带来两个副作用：

1. 召回内容变多，但信息密度下降；
2. 上下文里混入大量重复、过期、冲突或弱相关信息。

最后模型不是更聪明了，而是在一堆噪声里“强行写报告”。

**1.3 多跳关系很难靠相似度发现**

有些答案需要跨文档串联关系。

比如客户流失分析里，一个客户在客服工单里抱怨“响应慢”，在销售记录里提到“竞品报价更低”，在产品反馈里又反复提到“权限体系不够灵活”。单看任意一个 chunk，都不一定能看出流失原因；把这些实体和事件连起来，才会看到完整模式。

普通向量检索擅长找相似文本，不擅长显式表示“谁和谁有关、通过什么关系有关”。

Graph RAG 要解决的，正是这类结构性问题。

#### 2 Graph RAG 是什么？

一句话：

> **Graph RAG 是一种把非结构化文本先组织成知识图谱和社区摘要，再基于图结构做检索与生成的 RAG 架构。**

它不是简单地把文档丢进图数据库，而是把 RAG 的索引对象从“孤立 chunk”升级成“语义网络”。

普通 RAG 的索引对象主要是：

```
chunk text + embedding + metadata
```

Graph RAG 的索引对象会更丰富：

```
TextUnit
Entity
Relationship
Claim
Community
Community Report
Embedding
Source Reference
```

其中最关键的是两个东西：

1. **知识图谱**：表示实体之间的关系；
2. **社区摘要**：表示一组紧密相关实体共同构成的主题。

知识图谱让系统能“连点成线”，社区摘要让系统能“从局部看到整体”。

所以 Graph RAG 不是为了替代向量检索，而是为了给 RAG 增加一种新的信息组织方式：从文本相似度，升级到语义结构。

#### 3 索引阶段：把文本变成图

Graph RAG 的第一阶段是离线索引。

可以把它理解成：在用户提问之前，先让系统读完整个语料，抽取里面的重要对象和关系，并预先建立一张“语义地图”。

典型流程如下：

```
Documents
  -> TextUnits
  -> Entities / Relationships / Claims
  -> Entity Graph
  -> Community Detection
  -> Community Reports
  -> Embeddings + Metadata + Source References
```

**3.1 TextUnit：不是为了回答，而是为了建图**

普通 RAG 切 chunk 是为了检索和回答。Graph RAG 里的 TextUnit 也可以理解成 chunk，但它的第一目标是支持后续的信息抽取。

切得太小，关系会断；切得太大，实体和关系会混杂。

比如：

```
A 公司在 2024 年 Q3 取消续约。客户成功记录显示，
主要原因是集成成本高、权限配置复杂，同时竞品 B 提供了更低报价。
```

这里至少包含几个实体：

```
A 公司
2024 年 Q3
客户成功记录
集成成本
权限配置
竞品 B
报价
```

以及几条关系：

```
A 公司 -> 取消续约 -> 2024 年 Q3
A 公司 -> 流失原因 -> 集成成本高
A 公司 -> 流失原因 -> 权限配置复杂
竞品 B -> 提供 -> 更低报价
```

如果切分把这些信息拆散，后面建出来的图就会丢失关键关系。

**3.2 实体抽取：图的节点**

实体可以是人、组织、产品、地点，也可以是业务概念、技术模块、风险类型、流程节点。

在企业知识库里，实体不一定都是“专有名词”。比如：

```
报销政策
提前解约
权限体系
SLA
数据同步
客户流失
安全审计
```

这些概念如果在多个文档里反复出现，就值得成为图里的节点。

实体抽取最难的不是“抽出来”，而是“抽干净”。

同一个实体可能有很多写法：

```
OpenAI
Open AI
OpenAI 公司
开放人工智能公司
```

如果不做归一化，图会被切成多个碎片，看起来节点很多，实际关系很散。

**3.3 关系抽取：图的边**

关系是 Graph RAG 相比普通 RAG 最关键的增量。

普通 RAG 知道两个 chunk 语义相似，但不知道它们为什么相关。Graph RAG 希望显式表示：

```
客户 A -> 投诉 -> 响应慢
客户 A -> 使用 -> 产品 X
客户 A -> 转向 -> 竞品 Y
产品 X -> 存在问题 -> 权限复杂
```

关系最好带上来源证据，而不是只存一个三元组。

更好的结构是：

```
{
  "source": "客户 A",
  "relation": "投诉",
  "target": "响应慢",
  "description": "客户 A 在 2024-05 的工单中多次提到响应慢影响上线进度",
  "source_text": "...原文片段...",
  "document_id": "...",
  "confidence": 0.82
}
```

这样做的好处是，最后生成答案时可以追溯到原始证据，而不是只相信图里的抽取结果。

**3.4 社区发现：把图聚成主题**

当实体和关系足够多之后，图会变得很复杂。

Graph RAG 会对图做社区发现，把联系紧密的一组节点聚在一起。一个社区通常对应一个主题、事件簇、业务问题或知识模块。

比如客户流失数据里，可能聚出几个社区：

```
社区 1：价格敏感型客户
社区 2：权限和安全诉求
社区 3：上线实施阻塞
社区 4：竞品迁移
社区 5：客服响应慢
```

社区发现的意义在于：它把大量零散实体组织成不同层次的语义主题。

这一步很重要，因为后面的全局回答不是直接遍历所有原文，而是更多依赖这些社区摘要。

**3.5 Community Report：提前写好的“局部综述”**

社区发现之后，Graph RAG 会让 LLM 为每个社区生成摘要，也就是 Community Report。

它不是普通摘要，而是围绕社区里的实体和关系，写出这个社区的主题、关键实体、内部关系、重要发现和可能风险。

你可以把 Community Report 理解成系统提前写好的“局部研究报告”。

普通 RAG 是用户问了之后才临时总结 Top-K chunk。Graph RAG 则是在索引阶段就先总结好语料的结构。

这也是 Graph RAG 能回答全局问题的关键：当用户问“主要风险是什么”时，系统不用从原文里临时大海捞针，而是可以读取不同层级的社区报告，再做有目标的综合。

#### 4 查询阶段：Graph RAG 不是一种检索器，而是一组检索策略

Graph RAG 的查询方式不止一种。

不同问题应该走不同路径。

**4.1 Global Search：回答整体性问题**

Global Search 适合这种问题：

```
这批文档的主要主题是什么？
过去两周有哪些关键风险？
这些客户流失案例的共同原因是什么？
这个组织的主要协作瓶颈是什么？
```

这类问题需要理解整个语料，而不是定位某个片段。

Global Search 的典型流程是 map-reduce：

```
User Query
  -> 读取某一层级的 Community Reports
  -> Map：每批社区报告独立生成中间答案，并给要点打分
  -> Filter / Rank：保留重要中间要点
  -> Reduce：综合所有中间答案，生成最终回答
```

这个流程的核心是：先让模型在不同社区上分别思考，再把局部观点合并成整体答案。

它比普通 Top-K 检索更适合全局问题，因为社区报告本身已经覆盖了语料的结构。

**4.2 Local Search：回答实体相关问题**

Local Search 适合这种问题：

```
客户 A 为什么流失？
产品 X 被哪些客户投诉过？
某个功能和哪些风险有关？
某个研究者在数据集中和哪些主题相关？
```

这类问题围绕某个实体展开。

Local Search 的流程大致是：

```
User Query
  -> 找到语义相关实体
  -> 沿着实体关系向外扩展
  -> 找到相关关系、相邻实体、原始 TextUnits、社区报告
  -> 排序和过滤
  -> 拼成上下文
  -> 生成答案
```

它和普通向量检索的区别在于：普通检索只找相似 chunk，Local Search 会把实体当成入口，沿着关系网络找证据。

这就像你不是在全文搜索“客户 A”，而是在看客户 A 的关系图谱：它和哪些问题、产品、人员、竞品、事件连在一起。

**4.3 DRIFT Search：在全局和局部之间折中**

Global Search 全面，但可能贵。Local Search 具体，但可能视野太窄。

DRIFT Search 的思路是把二者结合起来：

```
先用社区报告获得大方向
  -> 生成更具体的追问
  -> 用 Local Search 继续深入
  -> 得到更细粒度证据
  -> 汇总成最终答案
```

它适合很多真实问题，因为真实问题往往既需要整体背景，也需要局部证据。

比如：

> “最近客户流失的主要原因是什么？请给出几个典型案例。”

这不是纯全局问题，也不是纯局部问题。你既要总结总体原因，也要落到具体客户案例。DRIFT 这类方法的目标就是在成本和质量之间做折中。

**4.4 Basic Search：不要为了图而图**

不是所有问题都需要 Graph RAG。

如果用户只是问：

```
“报销系统入口在哪里？”
“API token 怎么创建？”
“第 3 条规则原文是什么？”
```

普通向量检索、关键词检索或 hybrid search 可能更简单、更快、更准。

Graph RAG 是增强工具，不是默认答案。

#### 5 一个例子：用 Graph RAG 分析客户流失

假设公司里有这些数据：

```
CRM 记录
销售跟进记录
客服工单
客户成功会议纪要
产品反馈
竞品分析
合同续约记录
```

用户问：

> “最近流失客户的共同原因是什么？”

普通 RAG 可能会检索到几个包含“流失”“续约失败”“竞品”的 chunk，然后让模型总结。

这很容易漏掉信息。因为有些客户记录里可能没有出现“流失”这个词，而是写：

```
客户暂停推进
客户转向其他方案
客户认为集成周期不可控
客户暂缓预算
```

Graph RAG 会先在索引阶段形成类似这样的图：

```
客户 A -> 取消续约 -> 产品 X
客户 A -> 投诉 -> 集成复杂
客户 A -> 提到 -> 竞品 Y
客户 B -> 延迟上线 -> 权限配置问题
客户 B -> 投诉 -> 客服响应慢
客户 C -> 预算收缩 -> 降级套餐
客户 C -> 对比 -> 竞品 Y
产品 X -> 常见问题 -> 权限配置复杂
竞品 Y -> 优势 -> 报价更低
```

然后社区发现可能得到：

```
社区 1：集成和上线复杂度
社区 2：权限与安全配置
社区 3：价格与竞品压力
社区 4：客服响应与客户成功流程
```

当用户问“共同原因”时，Graph RAG 可以先看这些社区报告，再综合出答案：

```
最近流失客户的原因主要集中在四类：

1. 集成和上线成本高
   多个客户在上线阶段遇到接口联调、权限配置、数据同步问题。

2. 权限体系复杂
   企业客户对细粒度权限、审计和安全合规有更强诉求，但现有产品配置成本高。

3. 竞品价格压力
   部分客户在续约前对比竞品，竞品 Y 经常以更低报价切入。

4. 客户成功响应不足
   多个高风险客户在流失前都有响应慢、问题升级不及时的记录。
```

这类答案不是来自某一个 chunk，而是来自整个语料的结构。

#### 6 Graph RAG、Naive RAG、Agentic RAG 的区别

很多人会把这些概念混在一起。

可以这样理解：

| 架构           | 核心问题        | 主要能力                                                   | 典型适用场景          |
| ------------ | ----------- | ------------------------------------------------------ | --------------- |
| Naive RAG    | 模型不知道外部知识   | 找相似 chunk                                              | 简单事实问答          |
| Advanced RAG | 检索质量不够好     | Query Rewrite、Hybrid Search、Rerank、Context Compression | 生产级知识库问答        |
| Graph RAG    | 知识缺少结构      | 实体、关系、社区、全局总结                                          | 多跳关系、全局主题、复杂归因  |
| Agentic RAG  | 系统不知道如何获取知识 | 规划、工具选择、多轮检索、验证                                        | 复杂任务、多源数据、研究型问题 |

Graph RAG 和 Agentic RAG 不是替代关系。

Graph RAG 更偏“知识组织方式”：

```
把数据组织成图和社区摘要
```

Agentic RAG 更偏“控制流程”：

```
让 Agent 决定什么时候检索、检索哪里、是否继续追问、如何验证答案
```

二者可以组合。一个 Agentic RAG 系统的工具列表里，可以同时有：

```
vector_search()
keyword_search()
graph_local_search()
graph_global_search()
sql_query()
web_search()
rerank()
fact_check()
```

Agent 负责判断走哪条路，Graph RAG 负责提供结构化知识入口。

#### 7 Graph RAG 的工程难点

Graph RAG 听起来很美，但落地并不轻松。

它的问题主要不在“能不能跑通 demo”，而在“能不能稳定、低成本、可追溯地维护一张有用的图”。

**7.1 索引成本高**

Graph RAG 的离线索引通常需要大量 LLM 调用：抽实体、抽关系、抽 claims、生成社区报告。

这比普通 embedding 入库贵很多。

所以实际落地时通常要：

1. 从小数据集开始，不要一上来索引全公司文档；
2. 做 LLM cache，避免重复抽取；
3. 区分高价值文档和低价值文档；
4. 对低价值文档使用便宜模型或轻量抽取；
5. 对 prompt 做领域适配，不要直接套默认模板。

Graph RAG 官方仓库也提醒过：索引可能消耗较多 LLM 资源，应该先从小规模数据开始。

**7.2 图会被脏实体污染**

如果实体抽取质量差，图会很快变脏。

常见问题包括：

```
同义实体没有合并
无意义实体太多
实体粒度不一致
临时短语被当成实体
关系方向混乱
关系描述过于泛化
```

比如“权限系统”“权限模块”“RBAC”“权限配置”到底是不是一个实体，要根据业务语境决定。

图不是越大越好。图越脏，检索越难，摘要越容易失真。

**7.3 关系可能幻觉**

LLM 抽取关系时，可能会把原文没有明确支持的关系补出来。

比如原文只是说：

```
客户 A 在续约前提到了竞品 B。
```

模型可能抽成：

```
客户 A -> 转向 -> 竞品 B
```

但“提到竞品”不等于“转向竞品”。

所以生产系统里，关系最好要有：

```
source_text
document_id
confidence
extraction_prompt_version
created_at
```

并且最终答案必须能回溯到原文证据。

**7.4 更新和权限比普通 RAG 更复杂**

普通 RAG 更新一个 chunk，重新 embedding 就行。

Graph RAG 更新一批文档，可能影响：

```
实体
关系
社区结构
社区报告
实体 embedding
报告 embedding
图统计特征
```

如果文档频繁变化，维护完整 Graph RAG 的成本会很高。

权限也是一样。普通 RAG 可以在 chunk 级别做权限过滤；Graph RAG 还要考虑社区报告是否混入了用户无权查看的信息。

如果一个社区报告总结了多个部门的文档，那么不同权限的用户能不能看到这个报告？这是一个非常实际的问题。

**7.5 评估更难**

普通 RAG 可以评估：

```
Recall@K
MRR
nDCG
答案忠实度
引用准确性
```

Graph RAG 还要额外评估：

```
实体抽取是否正确
关系抽取是否正确
社区划分是否合理
社区报告是否忠实
全局答案是否覆盖主要主题
答案是否引用到了真实证据
```

尤其是全局问题，往往没有标准答案，只能用人工评审、LLM-as-judge、成对比较等方式评估。这会带来新的偏差。

因此，Graph RAG 的评估不能只看“答案看起来更丰富”，还要看它是否真的更准确、更可追溯。

#### 8 什么时候该用 Graph RAG？

适合用 Graph RAG 的场景：

```
1. 问题经常涉及多跳关系
2. 用户需要整体总结和主题分析
3. 数据来自大量非结构化文本
4. 文档之间存在大量实体复用
5. 答案需要解释“为什么”和“关联是什么”
6. 组织愿意为高质量索引支付额外成本
```

典型场景：

```
客户流失归因
投研报告分析
舆情主题发现
安全事件分析
科研文献综述
企业知识治理
法律/合同风险分析
医疗病例或指南关系分析
```

不适合用 Graph RAG 的场景：

```
1. 文档数量很小
2. 问题主要是简单事实定位
3. 数据变化极其频繁
4. 没有明显实体和关系
5. 成本、延迟比答案深度更重要
6. 无法接受 LLM 抽取带来的不确定性
```

如果只是做 FAQ 问答，Graph RAG 大概率过重。

#### 9 一个生产级 Graph RAG 架构

一个更完整的架构大概是这样：

```
离线索引链路：

Document Ingestion
  -> Parse / Clean
  -> Chunk into TextUnits
  -> Entity Extraction
  -> Relationship / Claim Extraction
  -> Entity Normalization
  -> Graph Construction
  -> Community Detection
  -> Community Report Generation
  -> Embedding
  -> Store Graph / Vector / Reports / Metadata


在线查询链路：

User Query
  -> Intent Classification
  -> Query Rewrite
  -> Choose Search Mode
       - Basic Search
       - Local Search
       - Global Search
       - DRIFT Search
  -> Build Context
  -> Generate Answer
  -> Attach Citations
  -> Log Trace
  -> Evaluate / Feedback
```

最关键的是 `Choose Search Mode`。

不要让所有问题都走 Graph RAG。更合理的做法是：

```
简单事实问题 -> Basic / Hybrid Search
实体相关问题 -> Local Search
整体总结问题 -> Global Search
既要整体又要细节 -> DRIFT Search
复杂多源任务 -> Agentic RAG 调度多个工具
```

好的 RAG 系统不是某一种方法打天下，而是根据问题选择合适的上下文构造方式。

#### 10 Graph RAG 的发展方向

Graph RAG 的一个明显问题是成本。

完整 Graph RAG 需要在索引阶段做大量 LLM 抽取和摘要，所以后续研究主要围绕两个方向优化。

**10.1 Dynamic Community Selection**

早期 Global Search 会在某个固定社区层级上处理大量社区报告，这样很全面，但成本高。

Dynamic Community Selection 的思路是：不要一开始就把所有社区报告送进 map-reduce，而是从高层社区开始，让较便宜的模型判断某个社区和问题是否相关。如果不相关，就剪掉这个社区及其子社区；如果相关，再向下探索。

它的本质是：

```
先判断相关性，再决定是否深入
```

这能减少无关社区报告进入后续生成流程，从而降低成本。

**10.2 LazyGraphRAG**

LazyGraphRAG 更进一步：它试图把 Graph RAG 和 vector RAG 结合起来，并推迟 LLM 的使用。

完整 Graph RAG 是“先花很多成本建好图和社区摘要，再查询”。

LazyGraphRAG 则更像：

```
先用轻量方法建立概念图
查询时再根据问题逐步深入
只对相关部分使用 LLM
```

它的方向很值得关注，因为生产环境里最常见的矛盾就是：我们想要 Graph RAG 的全局理解能力，但又不想承担完整图索引的高成本。

不过从工程角度看，不要因为看到了 LazyGraphRAG 就立刻否定完整 Graph RAG。完整 Graph RAG 的社区报告本身也有价值：它可以被人阅读、审计、分享，并作为数据资产长期存在。

#### 11 总结

Graph RAG 的核心不是“用了图”，而是把 RAG 的上下文工程从文本片段级别推进到了语义结构级别。

普通 RAG 问的是：

```
哪些 chunk 和问题最相似？
```

Graph RAG 问的是：

```
这个语料里有哪些实体？
实体之间有什么关系？
这些关系形成了哪些主题社区？
用户的问题应该从哪个层级理解？
答案需要哪些局部证据和全局摘要？
```

所以，Graph RAG 最适合解决的不是“找到某个答案”，而是“理解一批文档”。

一句话总结：

> **Graph RAG 把 RAG 从相似片段检索系统，升级成了可总结、可遍历、可追溯的语义地图。**

#### 参考

1. [From Local to Global: A Graph RAG Approach to Query-Focused Summarization](https://arxiv.org/abs/2404.16130)
2. [Microsoft GraphRAG Docs](https://microsoft.github.io/graphrag/)
3. [Microsoft GraphRAG GitHub](https://github.com/microsoft/graphrag)
4. [GraphRAG Global Search](https://microsoft.github.io/graphrag/query/global_search/)
5. [GraphRAG Local Search](https://microsoft.github.io/graphrag/query/local_search/)
6. [GraphRAG DRIFT Search](https://microsoft.github.io/graphrag/query/drift_search/)
7. [GraphRAG: Improving global search via dynamic community selection](https://www.microsoft.com/en-us/research/blog/graphrag-improving-global-search-via-dynamic-community-selection/)
8. [LazyGraphRAG: Setting a new standard for quality and cost](https://www.microsoft.com/en-us/research/blog/lazygraphrag-setting-a-new-standard-for-quality-and-cost/)


# AutoResearch

AutoResearch = 基模 + Agent Loop。当基模固定时，方法循环设计成为了竞争的本质。

这篇文章讲一下 AutoResearch 发展到现在的几种常见循环设计。以及一个通用的分析框架，当有新的AutoResearch方法出现时，你可以使用这个分析框架直接得出这个新方法的优劣势。

### 1 四种循环

#### 1.1 **线性循环 Keep-or-Discard**

> **代表系统**：Karpathy autoresearch（2025）

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FxavdyodAPtbae2mJsZXC%2Fnano_task_ce72d56d18264be9a31cc87ed8e56401%20(1).png?alt=media&amp;token=8919366e-70eb-4f2e-9f33-b3021da11c8b" alt=""><figcaption></figcaption></figure>

线性循环是最简单也最直觉的循环设计：每次尝试一个想法，如果结果更好就保留，否则回退。Karpathy 的 autoresearch 只有三个文件，循环逻辑由一个Markdown 指令（[program.md](http://program.md)）定义。

```python
【初始化】与用户确认运行标签 → 创建 git 分支 → 读取所有源文件 → 验证数据 → 确认启动

【主循环】
    1. 检查 git 状态（当前分支和 commit）
    2. 修改 train.py，实现一个实验想法
    3. 提交 commit
    4. 运行实验（固定 5 分钟时间预算）
    5. 提取指标（val_bpb，越低越好）
    6. 若崩溃 → 尝试修复（最多几次）→ 重试或记录失败
    7. 将结果记录到 results.tsv
    8. 若 val_bpb 改善 → 保留 commit，推进分支
       否则 → git reset，回退到上一个基线
```

设计的最大亮点在于“固定5 分钟的时间预算”这个约束选择，它迫使 Agent 思考的是"什么改动能在极短训练后就产生可测量的收益”，淘汰了那些需要训练很久才能看到效果的方案。人类的参与在编辑完 [program.md](http://program.md) 后达到了最小化，这个循环不会停下来问人类的意见，而是会自主执行，直到人类手动中断。

但是简洁的同时也带来了很多结构性的局限：

1. 它无法并行探索多个方向
2. 失败实验的经验没有被结构化保存（可能反复尝试同一个idea死循环）
3. 短时间约束容易让框架陷入局部最优
4. 只看最终指标这个标量反馈无法传达"为什么失败"，可解释性不够

#### 1.2 **树搜索循环搜索**

> **代表系统**：AIDE（2024）、AI Scientist v2（2025）

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FfQHTntOVOzbYyYpWL7Y9%2Fnano_task_04ce63aabf15413085acf71027e29f23.png?alt=media&amp;token=bb9129d9-9f9d-438b-a0db-5354afc1d6c5" alt=""><figcaption></figcaption></figure>

树搜索的核心思想是：不要把解空间的探索限制在一条线性路径上，而是维护一棵搜索树，允许同时保持多个探索方向，并在任意节点发起新的分支。树的每个节点是一个完整的代码解决方案，边是代码变换操作。

```
【初始化】创建根节点（空白方案或基线代码）

【主循环】重复 N 步：
    1. 选择：从树中挑选一个有潜力的节点
    2. 扩展：对该节点施加变换，生成子节点
       - 草稿：从头生成全新方案
       - 调试：修复当前节点的错误
       - 改进：在当前节点基础上优化
    3. 评估：运行代码，计算指标
    4. 回传：将结果添加到树中，更新节点统计
    5. 剪枝：移除明显无望的分支（可选）

【输出】树中找到的最优方案
```

树搜索相比线性循环的根本优势在于**回溯能力**和**方案多样性**。当某条路径走进死胡同时，线性循环只能通过 git reset 回到上一步然后尝试另一个方向，而树搜索可以回到树中任意一个历史节点重新出发。

听起来有点抽象，下面以 AIDE 的具体实现为例：

AIDE 中的每个节点是一个完整的、可独立运行的 Python 脚本，是一个从数据加载到模型训练到输出指标的完整 ML pipeline。有三种算子类型（算子代表对节点的更改）：

* **Draft（草稿）** 是从零开始生成一个全新方案。LLM 收到的 prompt 包含：任务描述、当前所有成功方案的摘要（称为 Memory），以及"不要重复已有方案"的指令。这确保每个 draft 尝试不同的建模方向——比如第一个 draft 可能用 XGBoost，第二个可能用神经网络，第三个可能用 feature engineering + 线性模型。
* **Debug（调试）** 针对有 bug 的节点。LLM 收到的 prompt 包含：完整的 buggy 代码、终端输出（包含报错信息和 traceback），以及"修复这个 bug"的指令。LLM 需要阅读错误信息并产出修复后的完整代码。如果修复后仍然有 bug，可以继续 debug（直到深度上限）。
* **Improve（改进）** 针对已经能正常运行的节点。LLM 收到的 prompt 包含：当前方案的完整代码、所有成功方案的摘要，以及"提出一个单一的、可实验验证的改进"的指令。关键约束是"atomic improvement"——每次只改一个东西（比如只换特征工程方法，或只换模型超参数），这样可以清楚地归因效果。

AIDE 认为有 bug 的节点代表已投入精力但尚未成功的探索方向，值得修复，所以会从有bug且为叶节点且调试深度没有达到上限的节点中随机选一个进行调试。如果存在好的节点，选择指标最好的那个节点，对其进行改进。

AIDE 采用的是贪婪策略——总是选当前最优节点做 improve。优势是收敛很快，但是如果Draft 1 很早就获得了好指标，后续所有 improve 都会集中在它的子树上，其他 draft 的子树被"饿死"。

**MCTS 选择**（ML-Master 等系统）用 UCB（Upper Confidence Bound）公式解决这个问题：

```
UCB(node) = 平均收益 + C × sqrt(ln(总访问次数) / 该节点访问次数)
```

第一项倾向于已知的好节点（利用），第二项倾向于被访问次数少的节点（探索）。系数 C 控制二者的平衡。这意味着即使 Draft 5 的初始指标较差，只要它被访问的次数少，UCB 公式就会给它一个"好奇心加分"，使系统偶尔去探索它。

类似 AI Scientist v2 的工作则完全抛弃了公式化的选择策略，让 Agent 自主判断"现在应该深耕哪个方向"。这种方式的优势在于 Agent 可以利用语义理解做出更智能的选择。

#### 1.3 遗传进化池循环

> **代表系统**：FunSearch（2023）、AlphaEvolve（2024）、GEPA（2025）

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FzrDUTbp9fsU651Fjn0oE%2Fnano_task_d2896b34874f4e1d867f3f4fedf2e1dd.png?alt=media&amp;token=dc768155-d530-43e5-863f-e76aa3f181ac" alt=""><figcaption></figcaption></figure>

遗传进化的核心思想来自生物演化：维护一个候选种群，通过选择优秀个体、对其施加突变（在这里由 LLM 完成）、评估后代的适应度，逐代推动种群向更优方向进化。与树搜索不同的是，进化池中的个体之间没有严格的父子拓扑——任何个体都可以被选为突变的起点，多个个体可以被交叉组合。

```
【初始化】
    候选种群 P = {种子方案}

【主循环】直到预算耗尽：
    1. 选择：从种群中挑选父本（根据适应度加权采样）
    2. 突变：LLM 基于父本生成变体
    3. 评估：计算新候选的适应度
    4. 更新种群：若满足条件则加入种群
    5. 剪枝：移除被支配的候选

【输出】种群中的最优候选
```

**FunSearch**（DeepMind, 2023）使用 MAP-Elites 算法维护种群——不只保留最优个体，而是在多个行为维度的每个 niche 中都保留最优个体，从而维持种群的多样性。但在 FunSearch 中，所有搜索规则（选择策略、评估标准、种群管理）都是人工硬编码的，LLM 只负责变体生成。

**GEPA**（2025）用**文本反馈取代标量奖励**来驱动突变方向。具体而言，系统先对当前候选进行 rollout，记录完整的执行轨迹（包括每一步的推理过程、工具调用和输出），然后让 LLM 阅读这些轨迹来诊断问题、归因原因、提出有针对性的修改方案。

#### 1.4 异步多 Agent 进化循环

> **代表系统**：CORAL（2026）

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fs0NQKjJAmQu3AYXi5jlx%2Fnano_task_467cac5895874cacab69ea20c6e20ea2.png?alt=media&amp;token=936657ee-139b-40a6-9c25-d7d7e64ca253" alt=""><figcaption></figcaption></figure>

前面三种循环本质上都是单一搜索过程（即使内部有多个角色参与，搜索的状态空间仍然是统一管理的）。以 CORAL 为代表的方法使用**多个 Agent 各自独立运行完整的搜索循环，通过共享持久记忆间接协调，无需任何显式通信协议**。

```
【每个 Agent 独立运行】异步循环：
    a. 读取共享记忆（attempts/ notes/ skills/）
    b. 自主决定下一步动作（无固定顺序）：
       - 尝试新想法
       - 重访过去的某次尝试
       - 将成功经验封装为 skill
       - 记录失败模式到 notes
       - 评估当前方案
    c. 执行动作
    d. 将结果写回共享记忆
    e. 心跳检查（反思 / 整合 / 方向调整）

【跨 Agent 协调】
    - 每个 Agent 在独立的 git worktree 中运行
    - 不直接通信，所有协调通过共享记忆发生
    - 一个 Agent 的发现自然影响其他 Agent 的后续搜索
```

**共享持久记忆**以文件系统的形式实现，分为三个目录：`attempts/` 存储所有历史评估记录（JSON 格式，按 commit hash 索引）、`notes/` 存储观察和反思（Markdown 格式，支持合并和分类）、`skills/` 存储可复用的过程和工具（包含自然语言描述和可执行脚本）。每个 Agent 通过符号链接访问共享记忆，按需读取以避免上下文过载，并且 Agent 可以主动整理和重组记忆结构。

### 2 通用分析框架

在分析具体系统之前，先建立一个通用的分析框架。任何 AutoResearch 方法循环都可以从以下四个维度进行解构：

1. 搜索拓扑：**搜索拓扑**决定了系统在解空间中的行走方式。线性路径每次只走一步，要么保留要么回退；树形分支允许同时保持多个探索方向并随时回溯；遗传池维护一个候选种群，通过选择和突变不断演化；异步并行则让多个独立 Agent 同时探索，通过共享记忆间接协调。
2. 反馈信号：**反馈信号**决定了系统从每次实验中能学到多少。最简单的标量奖励只告诉系统"好了多少"，但不解释"为什么"。结构化指标提供多维评估。文本反馈则能传达完整的诊断信息——哪个模块出了问题、哪种策略有潜力但需要调整。信息越丰富，系统下一步决策的质量就越高，但获取和处理的成本也越大。
3. 记忆架构：**记忆架构**决定了系统能否从历史中学习。无记忆的系统每次实验都从零开始思考；Git 历史提供了可回溯的版本记录但缺乏结构化查询；解树保留了搜索过程的完整拓扑；文件系统池支持多 Agent 并发读写；知识图谱则提供了最丰富的语义结构和跨项目的知识复利。
4. 决策主体：**决策主体**决定了"谁在控制搜索过程"。早期系统中，人类硬编码所有搜索规则，LLM 只是被调用的突变算子。后来 Agent 逐步获得了决定搜索策略的自主权——选择探索哪个方向、何时放弃当前路径、如何综合历史经验。

以下表格概括了各维度的主要选项及其代表系统：

| 搜索拓扑 | 代表系统                         | 反馈信号   | 记忆架构      | 决策主体       |
| ---- | ---------------------------- | ------ | --------- | ---------- |
| 线性路径 | Karpathy autoresearch        | 标量奖励   | Git 历史    | Agent 自主   |
| 树形分支 | AIDE, AI Scientist v2        | 标量/结构化 | 解树        | 贪婪/Agentic |
| 遗传池  | FunSearch, AlphaEvolve, GEPA | 标量→文本  | Pareto 前沿 | 人定规则→反射    |
| 异步并行 | CORAL                        | 复合信号   | 文件系统池     | 多 Agent 自主 |

### 参考

1. <https://github.com/karpathy/autoresearch>
2. <https://arxiv.org/abs/2403.17373>
3. <https://github.com/SakanaAI/AI-Scientist-v2>
4. <https://deepmind.google/blog/funsearch-making-new-discoveries-in-mathematical-sciences-using-large-language-models/#:~:text=Update%3A%20In%20December%202024%2C%20we%20published%20a%20report,to%20amplify%20human%20performance%20in%20combinatorial%20competitive%20programming.>


# Agent Memory

大语言模型并不会天然拥有长期记忆。

一次模型调用能够直接看到的，只是当前上下文窗口中的 Token。对话结束后，模型不会自动保存用户偏好；任务执行了几十步以后，早期观察也可能被截断或淹没。即使上下文窗口足够长，把全部历史原样塞回 Prompt 也不是理想方案，因为成本会持续增加，并且无关信息会干扰推理，在历史对话中过期事实与最新状态还可能同时出现。

因此，一个能够长期工作的 Agent，除了模型、工具和规划器，还需要一套独立有效的 Memory System。

但 Agent Memory 并不等于 rag，外挂一个向量数据库就能解决了。真正的 Memory 需要管理信息的完整生命周期：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FbuMS9rsj1lMMH2JvBIT6%2Fimage.png?alt=media&amp;token=52d8cd25-47ab-479f-b2ce-d5311d4e31fa" alt=""><figcaption></figcaption></figure>

## 1 为什么 Agent 需要 Memory

先看两个例子。

### 1.1 个人助理

用户曾经说：

> 我对花生过敏，以后推荐餐厅时帮我注意。

几天后，用户开启新会话：

> 帮我找一家附近评价不错的东南亚餐厅。

如果“花生过敏”只存在于旧会话里，Agent 就可能推荐大量使用花生原料的餐厅。这里真正需要保存的不是完整对话，而是一个能够长期影响决策的稳定约束。

### 1.2 Coding Agent

一个 Coding Agent 第一次进入仓库时发现：

* 单元测试必须在容器中运行；
* `config.yaml` 是生成文件，不能直接编辑；
* 数据库迁移必须先执行 dry-run。

如果这些经验没有被保存，下次进入同一个仓库时，Agent 还会重新踩一遍坑。

因此，Memory 带来的不只是“记住用户说过什么”，还包括：

* **跨会话一致性**：记住偏好、约束、承诺和历史决策；
* **长期任务连续性**：记住目标、进度、未解决问题和环境状态；
* **经验复用**：把成功路径和失败教训用于以后相似任务；
* **环境学习**：逐渐理解代码仓库、网页系统、数据平台或组织流程；
* **个性化**：形成可更新、可追溯的用户模型；
* **降低上下文成本**：只取回当前真正需要的信息。

## 2 Agent 的4种 Memory

### 2.1 Working Memory：工作记忆

Working Memory 保存当前任务正在使用的信息，例如：

* 当前目标；
* 当前计划；
* 已完成和未完成的步骤；
* 最近几次工具调用；
* 当前页面、文件或环境状态；
* 本轮推理需要的临时变量。

它的生命周期通常较短，适合放在 Agent Runtime、状态机或结构化任务对象中。

### 2.2 Episodic Memory：情景记忆

Episodic Memory 保存具体发生过的事件：

* 用户在某次会话中提出了什么要求；
* Agent 执行过什么动作；
* 某次部署为什么失败；
* 某个工具返回了什么结果；
* 一项任务最终成功还是失败。

### 2.3 Semantic Memory：语义记忆

Semantic Memory 保存从一次或多次经历中抽取出的稳定事实，例如：

* 用户偏好中文技术文章；
* 用户对花生过敏；
* 某个仓库使用 `uv` 管理依赖；
* 某张数据表是营收指标的权威来源。

它回答的是：

> **目前有哪些较稳定、可复用的事实？**

与具体事件相比，Semantic Memory 更抽象、更紧凑，也更适合直接影响后续决策。

### 2.4 Procedural Memory：程序性记忆

Procedural Memory 保存“如何完成某类任务”的知识：

* 操作步骤；
* Runbook；
* 工具使用方法；
* 成功策略；
* 常见失败模式；
* 检查清单；
* 可复用 Skill。

它回答的是：

> **遇到这类问题时应该怎么做？**

对于 Coding Agent、Data Agent 和 Browser Agent，Procedural Memory 往往比完整对话历史更有价值。

四类记忆之间可以相互转化：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2F5UL8yH2mfSk0hminsLKU%2Fimage.png?alt=media&amp;token=150caace-48b5-43a1-bab7-d0fdbc925167" alt=""><figcaption></figcaption></figure>

## 3 Memory System 的完整生命周期

从系统角度看，Agent Memory 可以拆成六个环节：

1. **Write**：判断什么值得写入；
2. **Organize**：抽取、分类、去重和建立关系；
3. **Retrieve**：根据当前任务检索候选记忆；
4. **Read**：在有限上下文预算内组织记忆；
5. **Update**：补充、修正和版本化旧记忆；
6. **Consolidate / Forget**：沉淀经验，并淘汰低价值或过期信息。

可以将其形式化为：

$$
M\_{t+1}=\mathcal{U}(M\_t,e\_t)
$$

其中，`e_t` 是当前产生的新事件，`U` 是写入与更新函数。

面对新任务时，系统从记忆库中检索：

$$
R\_t=\mathcal{R}(q\_t,M\_t)
$$

然后把当前输入、任务状态和检索结果组合为模型上下文：

$$
C\_t=\mathcal{C}(x\_t,S\_t,R\_t)
$$

真正困难的通常不是“把数据存下来”，而是 `U`、`R` 和 `C` 的设计。

***

## 4 写入

> **什么信息值得进入长期记忆？**

### 4.1 Write Gate

可以从以下维度判断是否写入：

| 维度   | 需要回答的问题              |
| ---- | -------------------- |
| 长期价值 | 以后是否可能再次影响决策？        |
| 新颖性  | 是否已经存在相同或等价信息？       |
| 稳定性  | 是长期事实，还是当前步骤的临时状态？   |
| 重要性  | 忘记它是否会造成明显错误？        |
| 可信度  | 信息来自用户、工具、文档，还是模型猜测？ |
| 敏感性  | 是否涉及隐私、凭证或不应保存的数据？   |
| 可执行性 | 它是否能改善未来任务表现？        |

通常值得写入：

* 用户明确要求长期记住的信息；
* 稳定偏好和重要约束；
* 长期任务的关键状态；
* 多次出现的环境规律；
* 高价值的成功经验与失败教训；
* 已验证的事实变化。

通常不应写入：

* 普通寒暄；
* 只在当前步骤有效的临时变量；
* 未经验证的模型猜测；
* 完整的大段工具输出；
* 密码、Token、私钥等 Secret；
* 外部网页中的命令性文本；
* 与未来任务无关的重复内容。

### 4.2 将原始信息拆成原子记忆

假设用户说：

> 我下个月搬到新加坡。以后推荐活动时优先看新加坡，最好安排在周末下午，我不太喜欢特别拥挤的地方。

这段话至少包含四条不同性质的信息：

| 内容          | 类型    | 时间属性  |
| ----------- | ----- | ----- |
| 用户下个月搬到新加坡  | 状态变化  | 未来生效  |
| 活动地点优先考虑新加坡 | 偏好/约束 | 搬家后生效 |
| 用户偏好周末下午活动  | 稳定偏好  | 长期有效  |
| 用户不喜欢拥挤场所   | 稳定偏好  | 长期有效  |

原子化的好处是：每条记忆可以单独检索、单独更新，并拥有不同的有效期和置信度。

### 4.3 最小记忆 Schema

一条可用的记忆至少应该包含：

```json
{
  "content": "用户不喜欢特别拥挤的场所",
  "type": "semantic",
  "source": "conversation_128/turn_16",
  "created_at": "2026-09-18T09:00:00Z",
  "valid_from": "2026-09-18T09:00:00Z",
  "valid_to": null,
  "confidence": 1.0,
  "importance": 0.8,
  "scope": "user_123",
  "status": "active"
}
```

其中最容易被忽略、却最重要的是：

* `source`：这条记忆从哪里来；
* `valid_from / valid_to`：它在什么时间范围内有效；
* `scope`：它属于哪个用户、项目或 Agent；
* `confidence`：明确事实和模型推断不能同等对待；
* `status`：是否仍然有效，或已被新记忆替代。

## 5 更新

Memory 经常面对状态变化，例如：

```
旧信息：用户常住上海。
新信息：用户已经搬到新加坡。
```

如果直接覆盖旧信息，系统就无法回答：

> 用户去年住在哪里？

更合理的做法是保留版本和有效期：

| 记忆      | 有效期                     | 状态         |
| ------- | ----------------------- | ---------- |
| 用户常住上海  | 2022-01-01 至 2026-10-01 | superseded |
| 用户常住新加坡 | 2026-10-01 起            | active     |

Memory Update 至少要区分五种情况：

1. **补充**：新信息完善了已有事实；
2. **修正**：旧信息本身错误；
3. **状态变化**：旧信息过去正确，现在不再有效；
4. **冲突**：多个来源给出不同结论，暂时无法判断；
5. **撤回或删除**：用户要求移除此前信息。

这里还要区分两个时间：

* **事件时间**：事实什么时候发生；
* **写入时间**：系统什么时候知道这件事。

对于行程、订单、项目状态和组织关系，这两个时间经常并不相同。

## 6 检索

假设用户说：

> 帮我安排周末活动。

只按语义相似度检索，系统可能找回“用户喜欢看电影”，却漏掉更重要的“用户膝盖受伤，近期不适合长距离步行”。

因此，记忆检索通常需要综合多个信号：

$$
S(m,q)=\alpha S\_{semantic}+\beta S\_{recency}+\gamma S\_{importance}+\delta S\_{task}+\epsilon S\_{confidence}-\eta S\_{conflict}
$$

其中：

* `Semantic`：与当前查询的语义相关性；
* `Recency`：信息是否仍然新鲜；
* `Importance`：忘记它是否会造成严重后果；
* `TaskRelevance`：是否直接影响当前目标；
* `Confidence`：来源是否可靠；
* `Conflict`：是否已失效、被替代或存在矛盾。

需要注意：**新近程度不等于正确性。** 一条很久以前记录的严重过敏信息，可能仍然比昨天的一次临时口味偏好重要。

### 6.1 查询不能只来自用户最后一句话

用户只说“继续”时，这两个字几乎没有检索价值。Memory Query 应该综合：

* 用户当前输入；
* 当前任务目标；
* 当前计划步骤；
* 环境和执行状态；
* 已知硬约束；
* 当前需要解决的子问题。

### 6.2 Hybrid Retrieval

生产系统通常会组合：

* 向量语义检索；
* BM25 或关键词检索；
* 时间过滤；
* 用户、项目和租户 Scope 过滤；
* Memory Type 过滤；
* 图关系扩展；
* Cross-Encoder 或 LLM Rerank。

LongMemEval 的实验显示，记忆切分粒度、索引 Key 和时间感知 Query 都会显著影响效果。\[5] 这意味着性能不只取决于 Embedding 模型，也取决于“如何切记忆”和“如何描述记忆”。

### 6.3 Context Packing

检索到 Top-K 后，不能直接全部塞进 Prompt。还需要：

1. 去重；
2. 删除已失效内容；
3. 优先保留硬约束；
4. 压缩冗长经历；
5. 标注时间和来源；
6. 对冲突信息显式说明；
7. 控制 Token Budget。

一个良好的 Memory Context 更像结构化摘要：

```
[长期偏好]
- 用户偏好周末下午活动。
- 用户不喜欢拥挤场所。

[当前约束]
- 用户膝盖仍在恢复期，不适合长距离步行。

[时间状态]
- 用户已于 2026-10-01 搬到新加坡，此前住在上海。
```

而不是一大段没有时间、来源和优先级的历史聊天记录。

***

## 7 Consolidation

随着任务不断执行，Episodic Memory 会快速增长。假设 Agent 多次观察到：

* 直接编辑生成文件会导致 CI 失败；
* 代码审查要求修改源模板；
* 重新运行 Generator 后任务成功。

系统可以将这些经历归纳为 Semantic Memory：

> 该仓库中的生成文件不能直接编辑。

再进一步沉淀为 Procedural Memory：

> 修改生成文件时，应先定位源模板，修改后重新运行 Generator，再检查 Diff 和测试结果。

这就是从“保存轨迹”走向“积累经验”。

Consolidation 可以在以下时机触发：

* 同类经历积累到一定数量；
* 一项长期任务完成；
* 某类错误重复发生；
* 用户偏好被多次确认；
* Memory Store 接近容量上限；
* Agent 进入空闲阶段。

不过，摘要也会产生信息损失。反复“对摘要再摘要”容易出现 Summary Drift：细节逐渐消失，模型推断逐渐变成貌似确定的事实。

因此，更稳妥的原则是：**保留原始证据，让高层记忆成为带来源的结论和索引，而不是永久替代底层记录。**

## 8 Forgetting

Memory 无限增长会带来：

* 检索噪声增加；
* 延迟和存储成本上升；
* 旧偏好干扰新偏好；
* 错误经验被不断复用；
* 敏感信息长期保留；
* 恶意内容形成持久化污染。

常见遗忘策略包括：

* 基于时间
  * 临时状态到期；
  * 长时间未访问；
  * 任务结束后删除过程性变量。
* 基于状态
  * 已被新版本替代；
  * 项目已关闭；
  * 来源已经失效；
  * 用户主动撤回。
* 基于效用
  * 低重要性；
  * 低置信度；
  * 与其他记忆高度重复；
  * 长期未改善任何下游任务。
* 基于安全和隐私
  * 用户要求删除；
  * 包含敏感个人信息；
  * 来自不可信外部内容；
  * 被识别为 Prompt Injection；
  * 违反数据保留策略。

工程上通常先做软删除，将记忆标记为 `superseded`、`expired`、`deleted` 或 `quarantined`，检索层只使用 `active` 记忆，再由后台流程执行真正删除和审计。

## 9 不同 Agent 应该采用什么 Memory

| 场景            | 最重要的记忆                                     | 推荐形态                              |
| ------------- | ------------------------------------------ | --------------------------------- |
| 个人助理          | 偏好、约束、承诺、生活状态变化                            | 结构化 Profile + 事件记录 + 语义检索         |
| 客服/销售 Agent   | 客户状态、历史承诺、工单、时间线                           | CRM 权威数据 + 版本化事件 + 引用             |
| Coding Agent  | Repo Map、命令、规范、失败原因、修复经验                   | 文件系统 + Procedural Memory + 任务状态   |
| Browser Agent | 页面状态、已执行动作、稳定操作流程、恢复点                      | Execution-State Memory + 轨迹压缩     |
| Data Agent    | Schema、Metric、Lineage、权威表、Incident、Runbook | Catalog + 图关系 + 文件型 Runbook + 权限层 |

不同场景不需要共享完全相同的 Memory 架构。

个人助理更关心用户偏好和时间变化；Coding Agent 更关心文件、执行轨迹和可复用流程；Browser Agent 更关心状态依赖和恢复边界。把所有场景都压成短文本块再做向量检索，通常不是最佳方案。

## 10 总结

Agent Memory 不是简单的向量数据库，也不是无限保存聊天记录。

一套完整的 Agent Memory 需要回答七个问题：

1. **写什么**：哪些信息具有长期价值？
2. **怎么存**：情景、事实、流程和工作状态如何组织？
3. **何时取**：当前任务真正需要哪些历史？
4. **如何排**：如何综合相关性、时效、重要性和可信度？
5. **怎么更新**：事实变化时如何保留时间和版本？
6. **何时遗忘**：哪些记忆已经过期、无效、危险或没有价值？
7. **如何评估**：Memory 是否真的提升了长期任务表现？

真正有价值的 Agent Memory，不是让 Agent 单纯“记得更多”，而是让它：

> **在正确的时机想起正确的信息，在环境变化时修正旧认识，并把一次性的任务经历沉淀为可复用的经验。**

这也是 Agent 从一次性 Prompt 程序走向长期、自适应软件系统的关键一步。

***

## 参考

1. [Generative Agents: Interactive Simulacra of Human Behavior](https://arxiv.org/abs/2304.03442)
2. [MemGPT: Towards LLMs as Operating Systems](https://arxiv.org/abs/2310.08560)
3. [A-MEM: Agentic Memory for LLM Agents](https://arxiv.org/abs/2502.12110)
4. [Mem0: Building Production-Ready AI Agents with Scalable Long-Term Memory](https://arxiv.org/abs/2504.19413)
5. [LongMemEval: Benchmarking Chat Assistants on Long-Term Interactive Memory](https://arxiv.org/abs/2410.10813)
6. [Evaluating Memory in LLM Agents via Incremental Multi-Turn Interactions](https://arxiv.org/abs/2507.05257)
7. [How Memory Management Impacts LLM Agents: An Empirical Study of Experience-Following Behavior](https://arxiv.org/abs/2505.16067)
8. [ACON: Optimizing Context Compression for Long-horizon LLM Agents](https://www.microsoft.com/en-us/research/publication/acon-optimizing-context-compression-for-long-horizon-llm-agents/)
9. [Beyond Semantic Organization: Memory as Execution State Management for Long-Horizon Agents](https://www.microsoft.com/en-us/research/publication/beyond-semantic-organization-memory-as-execution-state-management-for-long-horizon-agents/)
10. [LongMemEval-V2: Evaluating Long-Term Agent Memory Toward Experienced Colleagues](https://arxiv.org/abs/2605.12493)


# LLM训练


# LLM显存需求


# LLM精度问题

FP32，FP16，BF16是LLM中常见的精度类型。

**数字在计算机中是如何存储的？**

一个浮点数的值由符号位（S）、指数位（E）、尾数位（F）共同决定：

$$
Value=(-1)^S \times (1.F)\_2 \times 2^{E-127}
$$

* **符号位（sign）**
  * 表示数字正负
* **指数位（Exponent）**
  * 控制数值的**数量级（范围）**，相当于科学计数法中的“10的幂次”。
* **尾数位（Fraction/Mantissa）**
  * 存储数值的**有效数字（精度）**，相当于科学计数法中的“1.23”。

### 1 FP32 （单精度浮点数）

传统深度学习训练（高精度，但计算慢、内存占用高）

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-4ac9a6388d3e6ca9184e5a7777718b539a589022%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

* 位分配
  * 1位符号位
  * 8位指数位
  * 23位尾数位
* 范围
  * 最小正数：$$2^{-126} \approx 1.18 \times 10^{-38}$$
  * 最大正数：$$\left(2-2^{-23}\right) \times 2^{127} \approx 3.40 \times 10^{38}$$
  * 精度：约6-9位有效十进制数字
* 使用方式：`torch.float32` 或者 `torch.float`

### 2 FP16 （半精度浮点数）

深度学习领域正呈现出一种从 FP32 转向使用 FP16 的趋势，因为对于神经网络而言，低精度计算似乎并不关键。额外的精度并无实际益处，反而会使运算速度变慢、占用更多内存且降低通信速度。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-dfdaea0b089fae39dee84cb45ff3e9b8619178d1%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

* 位分配
  * 1位符号位
  * 5位指数位
  * 10位尾数位
* 范围
  * 最小正数：$$2^{-14} \approx 6.10 \times 10^{-5}$$
  * 最大正数：$$\left(2-2^{-10}\right) \times 2^{15} \approx 65,504$$
  * 精度：约3-4位有效十进制数字
* 使用方式：`torch.float16` 或 `torch.half`&#x20;

### 3 BF16 （**Brain Floating Point**）

最初设计的FP16并未考虑深度学习应用需求，其动态范围过于狭窄。而BF16解决了这个问题，提供了与FP32完全相同的动态范围。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-22dab52430f25e01a12b60861cac1c475e194b53%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

* **位分配**：
  * 符号位：**1位**
  * 指数位：**8位**（与FP32相同，Bias = 127）
  * 尾数位：**7位**
* **范围**
  * 最小正数：$$2^{-126} \approx 1.18 \times 10^{-38}$$ （同FP32）
  * 最大正数：$$\left(2-2^{-7}\right) \times 2^{127} \approx 3.39 \times 10^{38}$$
  * 精度：约2-3位有效十进制数字
* 使用方式：`torch.bfloat16`&#x20;

### 总结

| 属性       | FP32                                   | FP16                               | BF16                                   |
| -------- | -------------------------------------- | ---------------------------------- | -------------------------------------- |
| **总位数**  | 32位                                    | 16位                                | 16位                                    |
| **指数位**  | 8位（范围大）                                | 5位（范围小）                            | 8位（同FP32）                              |
| **尾数位**  | 23位（精度高）                               | 10位（精度低）                           | 7位（精度最低）                               |
| **动态范围** | $$\sim 10^{-38} \text { to } 10^{38}$$ | $$\sim 10^{-8} \text { to } 10^4$$ | $$\sim 10^{-38} \text { to } 10^{38}$$ |
| **典型场景** | 传统训练                                   | 推理、轻量训练                            | 现代大模型训练                                |

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-22949dc210dfa2b18f2f2eaffc77433820fc866f%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

### 参考

1. [FP64, FP32, FP16, BFLOAT16, TF32, and other members of the ZOO | by Grigory Sapunov | Medium](https://moocaholic.medium.com/fp64-fp32-fp16-bfloat16-tf32-and-other-members-of-the-zoo-a1ca7897d407)
2. [LLM大模型之精度问题（FP16，FP32，BF16）详解与实践 - 知乎](https://zhuanlan.zhihu.com/p/657886517)


# LLM训练需要多少显存

## 1 大模型训练RAM构成

首先，精度会对参数所需内存有影响：

* fp32，float point，一个参数需要32bits，即4bytes
* fp16,，一个参数需要 16 bits, 2 bytes
* int8 精度，一个参数需要 8 bits, 1 byte

大模型训练的显存占用主要由下面几部分构成：

* 模型参数
  * P = 参数量 \* 每个参数所需内存
* 梯度
  * 与模型参数类似，G = 参数量 \* 每个梯度参数所需内存
* 优化器状态
  * 不同的优化器所储存的参数量不同。
    * 例如，AdamW 需维护一阶动量（m）和二阶动量（v），因此需要存储两倍的模型参数
* 激活值（前向传播产生的中间张量）
  * A = B \* S \* E \* C
    * B: Batch Size (批处理大小)
    * S: Sequence Length (序列长度，或称上下文长度，即输入和输出的总token数)
    * E: Embedding Dimension (嵌入维度，或模型的隐藏层大小)
    * C: 常数因子，取决于具体的模型架构和实现细节。对于Transformer模型，这个因子通常大于1，因为它需要存储多个层的激活，并且某些操作（如MLP层）会创建维度为 4×E 的中间张量。
* CUDA内核开销
  * CUDA kernel 也会占据一些 RAM，大概 1.3GB 左右

## 2 显存计算示例

以 LLaMA-6B 为例，所需的显存占用如下：

* 模型状态
  * 模型参数 6GB
  * 梯度 6GB
  * 优化器（AdamW）12GB
* 运行时内存
  * CUDA Kernel 1.3 GB
* 激活值
  * 基于参数架构
    * hidden\_size = 4096, intermediate\_size =11008, num\_hidden\_layers = 32, context\_length = 2048
  * 每个实例：

    (4096 +11008) \* 2048 \*32 \* 1byte = 990MB
  * batch size=50时占用 48.3GB

### 参考

1. <https://zhuanlan.zhihu.com/p/716806882>


# 分布式训练并行

LLM的参数量已达到前所未有的级别。这种指数级的增长使得传统的单机单卡训练模式在计算能力和显存容量上捉襟见肘，难以满足日益增长的模型训练需求。因此，单机多卡和多机多卡的分布式训练成为日常。

分布式训练的核心在于如何有效地将计算任务和模型数据分配到多个计算设备上。使用的并行策略主要可以分为以下几类：

* [数据并行](/llm-everything/train/distributed-training-parallelism/data-parallelism) (Data Parallelism)：通过将数据集划分为多个子集，让每个设备独立处理一部分数据，同时保持模型副本的完整性。
* [模型并行](/llm-everything/train/distributed-training-parallelism/model-parallelism) (Model Parallelism)：当模型本身过于庞大，无法容纳于单张显卡时，可以将模型拆分到多个设备上，包括张量并行 (Tensor Parallelism)（层内并行）和流水线并行 (Pipeline Parallelism)（层间并行）。
* [优化器并行](/llm-everything/train/distributed-training-parallelism/optimizer-parallelism) (Optimizer Parallelism)：针对优化器状态、梯度和模型参数等占用大量显存的部分进行分片，如 ZeRO 优化器系列。
* [异构系统并行](/llm-everything/train/distributed-training-parallelism/heterogeneous-system-parallelism) (Heterogeneous System Parallelism)：利用 CPU 内存甚至 NVMe 磁盘的巨大容量，将模型的部分数据卸载，以容纳更大的模型。
* [专家并行](/llm-everything/moe/expert-parallelism) (Mixture-of-Experts Parallelism)：针对稀疏激活的模型架构，将计算任务分配给不同的“专家”模型。


# 数据并行

PyTorch现在已经提供了成熟、高效的分布式训练数据并行解决方案，因此本篇就以 PyTorch 的实现来详解数据并行，从DP到DDP再到FSDP。

在PyTorch的分布式训练中，有几个核心概念需要了解：

1. **进程组（Process Group）**：进程组是分布式训练的基本单位，由一组协同工作的进程组成。每个进程都可以通过进程组进行通信和同步操作。进程组负责协调各个计算节点的工作，确保训练过程的顺利进行。
2. **后端（Backend）**：后端是实现进程组通信的具体方法。PyTorch提供了多种后端选择，如TCP、Gloo和MPI等，以适应不同的分布式环境和需求。选择合适的后端可以优化通信效率，提高训练速度。

### 1 DP (Data Parallel)

DP 是 PyTorch 最早提供的数据并行方案，旨在使用单个进程在单台机器的多个 GPU 上实现数据并行训练。

#### 1.1 工作机制

1. **数据分割（Scatter）**：将一个 **batch** 的数据平均分割（Scatter）到各个 GPU。
2. **模型复制（Replication）**：将模型复制（Replication）到每个 GPU 上。
3. **独立计算**：每个 GPU **独立**计算前向传播和损失。
4. **梯度聚合与同步（Gather & Update）**：
   * 在 **主 GPU**（通常是 **GPU 0**）上收集（Gather）所有 GPU 计算出的损失并计算梯度。
   * 在 **主 GPU** 上更新模型参数。
   * 在下一次前向传播之前，将最新的模型参数再次复制到所有其他 GPU。

#### 1.2 局限性

虽然 DP 使用简单，但它存在几个显著的缺点，使其不适合大规模或高性能训练：

* **GPU 0 负载不均**：所有的梯度计算、参数更新和模型同步都集中在 **GPU 0** 上。这导致 GPU 0 成为**瓶颈**，使得其他 GPU 经常处于等待状态，造成 GPU 利用率不均衡。
* **单进程限制**：DP 只使用了**一个 Python 进程**。由于 Python 的 **GIL (Global Interpreter Lock)** 限制，无法充分利用多核 CPU 的并行优势，且不能进行真正的**多机分布式训练**。
* **模型同步开销**：每次迭代都需要将完整的模型参数或梯度在 GPU 0 和其他 GPU 之间传输，通信开销较大。

因此，PyTorch **官方已不推荐**在生产环境中使用 DP，并建议使用 **DDP**。

### 2 DDP (Distributed Data Parallel)

DDP 是 PyTorch 官方推荐的成熟、高效的数据并行方案，用于单机多卡或多机多卡的分布式训练。它解决了 DP 的所有主要问题。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-7f2a26d1321831d8c736c609d5cdb493913dd97f%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

#### 2.1 DP VS DDP

| **特性**     | **DP**                    | **DDP**               | 优点                                   |
| ---------- | ------------------------- | --------------------- | ------------------------------------ |
| **进程**     | 单进程，多线程                   | 多进程（每个 GPU 独立一个进程）    | 避免 **GIL 瓶颈**，充分利用多核 CPU，支持**多机训练**。 |
| **通信机制**   | Gather/Scatter（集中在 GPU 0） | **All-Reduce**（点对点通信） | **负载均衡**，没有主GPU瓶颈，通信效率高。             |
| **梯度同步时机** | 反向传播结束后，在 GPU 0 集中计算梯度    | **梯度计算过程中**           | 减少等待时间。                              |
| **模型存储**   | GPU 0 存储原始模型，其他 GPU 存副本   | 每个进程存储一个**完整的模型副本**   | **内存消耗均衡**，更新独立且一致。                  |

当用户用 `DDP(model)` 封装模型时，DDP 会在模型的 **Hooks** 上进行操作，从而控制反向传播的行为，**`_rebuild_parameters`** 方法在 DDP 初始化时，检查模型的所有参数，并为每个参数注册一个 **`grad_acc_hook`**。这是 DDP 区别于 DP 的核心优势。DDP 不等待所有梯度计算完毕再进行一次大规模的同步，而是利用 **All-Reduce** 算法，并在**反向传播过程中**实现**计算与通信的重叠。当反向传播开始时，PyTorch 的自动微分引擎 Autograd 从输出层向输入层逐步计算梯度。一旦一个参数的梯度被计算出来，它所注册的 `grad_acc_hook` 就会被触发，DDP 会检查这个梯度是否属于当前正在被收集的梯度块 (Bucket)**。**如果**一个完整的梯度块中的所有梯度都已计算完毕，DDP 会立即在这个块上异步地启动一个 **All-Reduce** 通信操作。

当一个进程正在对一个梯度块执行 All-Reduce 时，Autograd 引擎可以同时继续计算模型中更深层次的参数的梯度**计算**。

通过将通信操作分解并与计算并行执行，DDP 大幅减少了通信等待时间，显著提高了 GPU 利用率。

### 3 FSDP (Fully Sharded Data Parallel)

尽管 DDP 解决了计算和通信的效率问题，但它仍然存在一个根本的限制：

> 内存冗余：在 DDP 中，每个 GPU 都需要存储完整的 PGO (Parameters, Gradients, Optimizer States) 副本。

随着模型规模（如 **GPT-3**、**LLaMA** 等大型语言模型）的不断增大，模型参数、优化器状态和激活的显存占用可能**超过单个 GPU 甚至整个机器的显存容量**。在这种情况下，传统的数据并行（DDP）就无能为力了。

**FSDP** (Fully Sharded Data Parallel)，是 PyTorch **1.11** 版本后引入的**高效**且**可扩展**的并行策略，它基于 **ZeRO (Zero Redundancy Optimizer)** 思想。

它将模型的 PGO 沿维度切片，每个 GPU 只负责存储和管理它被分配到的那一部分。

#### 3.1 DDP VS FSDP

| **内存项**                      | **DDP 存储方式**              | **FSDP 存储方式 (Sharding Level)**         |
| ---------------------------- | ------------------------- | -------------------------------------- |
| **P**arameters (参数)          | 每个 GPU 存储 $$\text{100%}$$ | 每个 GPU 只存储 $$\text{1/N}$$ (N 为 GPU 总数) |
| **G**radients (梯度)           | 每个 GPU 存储 $$\text{100%}$$ | 每个 GPU 只存储 $$\text{1/N}$$              |
| **O**ptimizer States (优化器状态) | 每个 GPU 存储 $$\text{100%}$$ | 每个 GPU 只存储 $$\text{1/N}$$              |

在 PyTorch 中，FSDP 主要通过 `torch.distributed.fsdp.FullyShardedDataParallel` 类实现。

#### 3.2 FSDP过程

**前向传播**

FSDP 在前向传播中引入了 **All-Gather** 操作：

1. **分片参数**：初始状态下，每个 GPU 只拥有它负责的**参数分片**（$$\text{Param}\_\text{shard}$$）。
2. **All-Gather**：当前向传播需要某个层的参数时，FSDP 会自动触发一个 **All-Gather** 操作。
   * 所有的 GPU 进程会将它们持有的该层参数分片汇集起来，**临时**重建出该层的**完整参数**（$$\text{Param}\_\text{full}$$）。
   * $$\text{Param}\_\text{full}$$仅在该层计算期间存在于每个 GPU 的内存中。
3. **计算**：使用完整的参数进行前向计算。
4. **释放内存 (Shard & Free)**：计算完成后，完整参数会被**立即释放**，GPU 内存只保留其分片。

> 这个 Fetch-Compute-Free 策略是 FSDP 节省显存的关键：完整参数不会在整个训练过程中持续存在。

**反向传播**

反向传播中，FSDP 类似 DDP，实现了计算与通信的重叠，但使用 Reduce-Scatter 操作进行梯度同步。

1. **局部梯度计算**：当 Autograd 计算出某层参数的梯度时，由于每个 GPU 仅持有该层的**分片参数**，因此它也只会计算出**分片梯度**（$$\text{Grad}\_\text{shard}$$）。
2. **Reduce-Scatter**：FSDP 会触发一个 **Reduce-Scatter** 操作。
   * 这个操作将所有 GPU 上的**分片梯度**（$$\text{Grad}\_\text{shard}$$）进行求和（Reduce），然后将求和后的完整梯度**再次分片**（Scatter），发送回各个 GPU。
   * 最终，每个 GPU 进程会收到它负责的那个**已同步的梯度分片**。

### 参考

1. [大模型分布式训练并行技术（二）-数据并行 - 知乎](https://zhuanlan.zhihu.com/p/650002268)
2. [PyTorch 分布式训练：从历史到概述-百度开发者中心](https://developer.baidu.com/article/details/3272751)


# 模型并行

在数据并行训练中，一个明显的特点是每个 GPU 持有整个模型权重的副本。这就带来了冗余问题，因为最终你只需要一个更新后的模型权重。因此可以使用模型并行的训练方式，即模型被分割并分布在一个设备阵列上。

通常有两种类型的模型并行：张量并行和流水线并行。

* 张量并行是在一个操作中进行并行计算，如矩阵乘法。将单层内的张量操作拆分到多个 GPU 上，减少单卡内存压力。
* 流水线并行是在各层之间进行并行计算。将模型的不同层分布在不同设备上，通过 micro-batching 和交错调度减少 pipeline bubble（设备空闲时间）。

因此，从另一个角度来看，张量并行可以被看作是层内并行，流水线并行可以被看作是层间并行。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FAky3SiLLhgXJi9lq44S4%2Fimage.png?alt=media&amp;token=61efbfc8-3225-47cc-a109-afeb31e2724c" alt=""><figcaption></figcaption></figure>

## 1 张量并行

张量并行的数学本质是对矩阵乘法 $$Y=XA$$ 进行分块计算。主要分为两种基础切分方式：

## 1.1 行并行和列并行

### 1.1.1 行并行 (Row Parallelism)

* 切分逻辑：
  * 权重 $$A$$ 按**行**切分 ( $$A\_1, A\_2$$)。
  * 输入 $$X$$ 需按**列**切分 ( $$X\_1, X\_2$$) 以匹配维度。
* 计算过程：
  * GPU0: $$Y\_1 = X\_1 A\_1$$
  * GPU1: $$Y\_2 = X\_2 A\_2$$
  * 最终结果： $$Y = Y\_1 + Y\_2$$ (需要 **All-Reduce** 求和)

### 1.1.2 列并行 (Column Parallelism)

* 切分逻辑：
  * 权重 $$A$$ 按**列**切分 ( $$A\_1, A\_2$$)。
  * 输入 $$X$$ 在所有 GPU 上保持一致（复制/广播）。
* 计算过程：
  * GPU0: $$Y\_1 = X A\_1$$
  * GPU1: $$Y\_2 = X A\_2$$
  * 最终结果： $$Y = \[Y\_1, Y\_2]$$ (拼接/Concat，需要 **All-Gather**)

## 2 张量并行的实现

### 2.1 1D 张量并行

1D的意思是张量全部按照某一维度进行划分（横切或者竖切）。1D张量并行是目前 Transformer 架构大模型最主流的方案，由 Megatron-LM 提出。

以一个线性层为例：

考虑一个线性层的 GEMM 运算：

$$
Y = XA
$$

给定2个处理器，我们将权重矩阵 $$A$$ 按**列**划分为：

$$
A = \[A\_1 \ A\_2]
$$

在每个处理器上独立计算：

$$
Y\_i = XA\_i
$$

最终得到：

$$
\[Y\_1 \ Y\_2] = \[XA\_1 \ XA\_2]
$$

这种划分方式称为**列并行方式**。

当第二个线性层 $$Z = YB$$ 接在上述列并行层之后时，我们需要将 $$B$$ 按**行**划分：

$$
B = \begin{bmatrix} B\_1 \ B\_2 \end{bmatrix}
$$

为计算：

$$
Z = \[Y\_1 \ Y\_2] \begin{bmatrix} B\_1 \ B\_2 \end{bmatrix}
$$

计算过程分为两步（使用 stepper 表示顺序流程）：

{% stepper %}
{% step %}

### 在每个处理器上本地计算

计算本地乘积：$$Y\_i B\_i$$
{% endstep %}

{% step %}

### 使用 all-reduce 汇总结果

得到：

$$
Z = Y\_1B\_1 + Y\_2B\_2
$$
{% endstep %}
{% endstepper %}

在后向计算中，列并行线性层需要聚合输入张量 $$X$$ 的梯度。原因在于：

在每个处理器 $$i$$ 上，我们仅持有部分输出梯度 $$\dot{Y}\_i$$，因此本地计算得到：

$$
\dot{X}\_i = \dot{Y}\_i A\_i^T
$$

为获得完整的输入梯度，必须在各处理器间执行 **all-reduce** 操作：

$$
\dot{X} = \dot{Y}A^T = \dot{Y}\_1 A\_1^T + \dot{Y}\_2 A\_2^T
$$

***

### 2.2 2D 张量并行

1D张量并行没有对 **activations** 进行划分，就大规模模型而言，这也会消耗大量的内存。为了平均分配计算和内存负荷，在 SUMMA（可扩展的通用矩阵乘法算法）的基础上，**2D张量并行**被引入。

还是以线性层为例：

$$
Y = XA
$$

给定 **P = q × q** 个处理器（必要条件），如 **q = 2**，我们把输入 **X** 和权重 **A** 都划分为：

$$
\begin{bmatrix}
X\_{00} & X\_{01} \\
X\_{10} & X\_{11}
\end{bmatrix}
\quad \text{and} \quad
\begin{bmatrix}
A\_{00} & A\_{01} \\
A\_{10} & A\_{11}
\end{bmatrix}
$$

该计算包括 q 步（使用 stepper 展示每个时刻的操作）：

{% stepper %}
{% step %}

### 第1步（t = 1）

* $$X\_{i0}$$ 在其行中被广播
* $$A\_{0j}$$ 在其列中被广播

得到：

$$
\begin{bmatrix}
X\_{00}, A\_{00} & X\_{00}, A\_{01} \\
X\_{10}, A\_{00} & X\_{10}, A\_{01}
\end{bmatrix}
$$

在每个处理器 $$(i, j)$$ 上将 $$X\_{i0}$$ 和 $$A\_{0j}$$ 相乘为：

$$
\begin{bmatrix}
X\_{00}A\_{00} & X\_{00}A\_{01} \\
X\_{10}A\_{00} & X\_{10}A\_{01}
\end{bmatrix}^{(1)}
$$
{% endstep %}

{% step %}

### 第2步（t = 2）

* $$X\_{i1}$$ 在其行中被广播
* $$A\_{1j}$$ 在其列中被广播

得到：

$$
\begin{bmatrix}
X\_{01}A\_{10} & X\_{01}A\_{11} \\
X\_{11}A\_{10} & X\_{11}A\_{11}
\end{bmatrix}^{(2)}
$$
{% endstep %}
{% endstepper %}

通过将第1步和第2步的结果相加，我们得到：

$$
Y = XA =
\begin{bmatrix}
X\_{00}A\_{00} + X\_{01}A\_{10} & X\_{00}A\_{01} + X\_{01}A\_{11} \\
X\_{10}A\_{00} + X\_{11}A\_{10} & X\_{10}A\_{01} + X\_{11}A\_{11}
\end{bmatrix}
$$

### 2.3 2.5D 张量并行

与一维张量并行相比，二维并行降低了内存成本，但可能引入更多的通信。因此，**2.5D张量并行**在2.5D SUMMA的基础上被提出，它通过使用更多的设备来减少通信开销。

以线性层为例：

$$Y = XA$$

给定 **P = q × q × d** 个处理器（必要条件），如 **q = d = 2**：

我们把输入 **X** 划分为 **d × q** 行和 **q** 列：

$$
\begin{bmatrix}
X\_{00} & X\_{01} \\
X\_{10} & X\_{11} \\
X\_{20} & X\_{21} \\
X\_{30} & X\_{31}
\end{bmatrix}
$$

它可以被重塑为 **d** 层：

$$
\begin{bmatrix}
X\_{00} & X\_{01} \\
X\_{10} & X\_{11}
\end{bmatrix}
\quad \text{and} \quad
\begin{bmatrix}
X\_{20} & X\_{21} \\
X\_{30} & X\_{31}
\end{bmatrix}
$$

权重 **A** 被分割为：

$$
\begin{bmatrix}
A\_{00} & A\_{01} \\
A\_{10} & A\_{11}
\end{bmatrix}
$$

对于 **X** 相关的每一层，我们使用 SUMMA 算法将 **X** 与 **A** 相乘。然后，我们得到输出：

* 第1层输出：

$$
\begin{bmatrix}
Y\_{00} = X\_{00}A\_{00} + X\_{01}A\_{10} & Y\_{01} = X\_{00}A\_{01} + X\_{01}A\_{11} \\
Y\_{10} = X\_{10}A\_{00} + X\_{11}A\_{10} & Y\_{11} = X\_{10}A\_{01} + X\_{11}A\_{11}
\end{bmatrix}
$$

* 第2层输出：

$$
\begin{bmatrix}
Y\_{20} = X\_{20}A\_{00} + X\_{21}A\_{10} & Y\_{21} = X\_{20}A\_{01} + X\_{21}A\_{11} \\
Y\_{30} = X\_{30}A\_{00} + X\_{31}A\_{10} & Y\_{31} = X\_{30}A\_{01} + X\_{31}A\_{11}
\end{bmatrix}
$$

***

### 2.4 3D 张量并行

**3D张量并行**是一种将神经网络模型的计算并行化，以期望获得最佳通信成本优化的方法。

以线性层为例：

$$
Y = XA
$$

给定 **P = q × q × q** 个处理器（必要条件），如 **q = 2**，我们把输入 **X** 和权重 **A** 划分为：

$$
\begin{bmatrix}
X\_{000} & X\_{001} \\
X\_{010} & X\_{011} \\
X\_{100} & X\_{101} \\
X\_{110} & X\_{111}
\end{bmatrix}
\quad \text{and} \quad
\begin{bmatrix}
A\_{000} & A\_{001} \\
A\_{010} & A\_{011} \\
A\_{100} & A\_{101} \\
A\_{110} & A\_{111}
\end{bmatrix}
$$

其中每个 $$X\_{ijl}$$ 和 $$A\_{lji}$$ 都被存储在处理器 $$(i,j,l)$$ 上，如下图所示：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FoUffQOMj4bwpqeseQOzD%2Fimage.png?alt=media&amp;token=a44bb44e-6e66-43c6-9ac0-4d17b2686506" alt=""><figcaption></figcaption></figure>

前向传播时的流程可以用 stepper 表示：

{% stepper %}
{% step %}

### 数据收集阶段

* 在 $$(i, 0...q, l)$$ 上收集 $$X\_{ijl}$$，得到 $$X\_{il}$$
* 在 $$(0...q, j, l)$$ 上收集 $$A\_{lji}$$，得到 $$A\_{lj}$$
  {% endstep %}

{% step %}

### 本地计算

在每个处理器 $$(i, j, l)$$ 上计算乘积 $$X\_{il}A\_{lj}$$
{% endstep %}

{% step %}

### 结果归约

在 $$(i, j, 0...q)$$ 对结果进行 **reduce-scatter** 得到 $$Y\_{ijl}$$，最终形成：

$$
Y =
\begin{bmatrix}
Y\_{000} & Y\_{001} \\
Y\_{010} & Y\_{011} \\
Y\_{100} & Y\_{101} \\
Y\_{110} & Y\_{111}
\end{bmatrix}
$$
{% endstep %}
{% endstepper %}

反向传播时：

* 需要 **all-gather** 梯度 $$\dot{Y\_{ijl}}$$
* 然后 **reduce-scatter** 梯度：
  * $$X$$ 的梯度：$$\dot{X\_{il}} = \dot{Y\_{ij}} A\_{lj}^T$$
  * $$A$$ 的梯度：$$\dot{A\_{lj}} = X\_{il}^T \dot{Y\_{ij}}$$

## 3 流水线并行

流水线并行的核心思想是，模型按层分割成若干块，每块都交给一个设备。

* 在前向传播过程中，每个设备将中间的激活传递给下一个阶段。
* 在后向传播过程中，每个设备将输入张量的梯度传回给前一个流水线阶段。

这允许设备同时进行计算，从而增加训练的吞吐量。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FA64a2HGd5S362rMRgNZx%2Fimage.png?alt=media&amp;token=889f86fb-a6f3-4803-a8a9-83c432d956e2" alt=""><figcaption></figcaption></figure>

## 4 流水线并行的实现

### 4.1 朴素流水线并行

**原理：**

假设我们有 4 个 GPU（GPU0 - GPU3），模型也被切分为 4 段。下面使用 stepper 展示数据在各 GPU 间的流动：

{% stepper %}
{% step %}

### 步骤 1

GPU0 接收一个完整的 Batch 数据，计算完第一部分层，将输出传给 GPU1。
{% endstep %}

{% step %}

### 步骤 2

GPU1 接收数据，计算第二部分，传给 GPU2。
{% endstep %}

{% step %}

### 步骤 3

以此类推，直到 GPU3 完成前向传播，计算 Loss，然后开始反向传播，数据流反向回传。
{% endstep %}
{% endstepper %}

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FndW0Zq14nOEqYTUTxTBl%2Fimage.png?alt=media&amp;token=f8cf359b-78bf-438a-b346-aa5fefa1b9d3" alt=""><figcaption></figcaption></figure>

流水线并行训练的一个明显缺点是训练设备容易出现空闲状态（因为后一个阶段需要等待前一个阶段执行完毕），导致计算资源的浪费，加速效率没有数据并行高。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FwJ2ksvYQRzpDKWTV52Ny%2Fimage.png?alt=media&amp;token=fe13b404-884e-41ce-a290-142d94f95f5a" alt=""><figcaption></figcaption></figure>

### 4.2 微批次流水线并行

为了解决“朴素并行”的空泡问题，引入了微批次（Micro-batch）的概念。

* 原理： 将一个大的全局 Batch（Global Batch）切分成多个小的 Micro-batch。
  * 例如：Global Batch = 1024，切分成 4 个 Micro-batch，每个大小 256。
* 作用： GPU0 处理完 Micro-batch 1 后，立刻发送给 GPU1，紧接着 GPU0 可以马上处理 Micro-batch 2，而不需要等待。
  * 这样，流水线就像工厂的传送带一样流动了起来，多个 GPU 可以同时工作。

基于“微批次”思想，可以设计不同的“调度策略”来平衡显存占用和计算效率：

| 特性          | GPipe           | PipeDream Flush (1F1B)           | PipeDream (Original) | PipeDream-2BW |
| ----------- | --------------- | -------------------------------- | -------------------- | ------------- |
| 调度模式        | F … F → B … B   | 稳定期交替 1F → 1B                    | 持续循环，无 Flush         | 限制版本的持续循环     |
| 显存占用 (激活值)  | 极高 (存 M 份)      | 低 (存 N 份，及时释放)                   | 低                    | 低             |
| 显存占用 (模型权重) | 低 (1 份)         | 低 (1 份)                          | 高 (多版本 stashing)     | 中 (固定 2 份)    |
| 权重更新语义      | 同步 SGD (准确)     | 同步 SGD (准确)                      | 异步 SGD (有误差)         | 异步 SGD (有误差)  |
| 流水线空泡       | 较大 (取决于 M/N 比例) | 与 GPipe 相同 (但在同显存下可跑更大 M，从而稀释空泡) | 极小 / 无               | 极小            |
| 适用场景        | 教学、小模型          | 当前大模型训练主流 (LLaMA, GPT-3)         | 研究性质，追求极致吞吐          | 显存受限的异步训练     |

## 参考

1. [大模型分布式训练并行技术（四）-张量并行 - 知乎](https://zhuanlan.zhihu.com/p/657921100)
2. [大模型分布式训练并行技术（三）-流水线并行 - 知乎](https://zhuanlan.zhihu.com/p/653860567)
3. [1D 张量并行 | Colossal-AI](https://colossalai.org/zh-Hans/docs/features/1D_tensor_parallel/)
4. [Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM](https://deepakn94.github.io/assets/papers/megatron-sc21.pdf)
5. [An Efficient 2D Method for Training Super-Large Deep Learning Models](https://arxiv.org/pdf/2104.05343)
6. [Tesseract: Parallelize the Tensor Parallelism Efficiently](https://arxiv.org/pdf/2105.14500)
7. [2105.14450](https://arxiv.org/pdf/2105.14450)


# 优化器并行

### 为什么需要优化器并行

随着模型越来越大，单张 GPU 的显存（即使是 80GB 的 A100/H100）通常无法装下完整的模型，所以需要想办法对占显存的地方进行优化。

通常来说，模型训练的过程中，GPU上需要进行存储的参数包括了模型本身的参数、优化器状态、激活函数的输出值、梯度以及一些临时的Buffer。各种数据的占比如下图所示：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FDWpyEW0YJVitj4v7XOPh%2Fimage.png?alt=media&amp;token=5d38ca89-1fe8-4b20-b9cf-538587550e64" alt=""><figcaption></figcaption></figure>

* **模型状态（Model States）：** 包含：
  * **模型参数（Parameters）：** 模型本身的权重。
  * **梯度（Gradients）：** 反向传播计算出的梯度。
  * **优化器状态（Optimizer States）：** 例如 Adam 优化器中的 Momentum（动量）和 Variance（方差）。
* **激活值（Activations）：** 前向传播过程中各层的输出，需要在反向传播时使用。
* **临时缓冲区（Temporary Buffers）：** 算子计算时的临时空间。
* **碎片（Fragmentation）：** 显存分配不连续导致的浪费。

假设我们使用 Adam 优化器训练一个 $$\Phi$$ 参数量的模型：&#x20;

* **模型参数 (FP16):** $$2\Phi$$ bytes&#x20;
* **梯度 (FP16):** $$2\Phi$$ bytes&#x20;
* **优化器状态 (FP32):** Adam 需要存储一份参数副本、Momentum 和 Variance，通常全是 FP32，共 $$4\Phi + 4\Phi + 4\Phi = 12\Phi$$ bytes。

{% hint style="info" %}
**结论：** 模型状态总计约 $$16\Phi$$ bytes。其中，**优化器状态占据了绝大部分（约 75%）**。这是我们需要优化的核心目标。
{% endhint %}

而优化器相关的并行就是一种去除冗余数据的并行方案，目前这种并行最流行的方法是 [ZeRO](https://zhida.zhihu.com/search?content_id=221180389\&content_type=Article\&match_order=1\&q=ZeRO\&zhida_source=entity) **(Zero Redundancy Optimizer)**，由微软 DeepSpeed 团队提出。

### Deepspeed ZeRo-1\~ZeRo-3

针对模型状态的存储优化（去除冗余），ZeRO使用的方法是分片，即每张卡只存 1/N 的模型状态量，这样系统内只维护一份模型状态。ZeRO有三个不同级别，对模型状态进行不同程度的分片：

* ZeRO-1 : 对优化器状态分片（Optimizer States Sharding）
  * **原理：** 将显存占用最大的“优化器状态”切分到 $$N$$ 个 GPU 上。每张卡只负责更新自己分到的那 $$1/N$$ 的参数。
  * **效果：** 显存节省显著，且几乎不增加通信开销。
* ZeRO-2 : 对优化器状态和梯度分片（Optimizer States & Gradients Sharding）
  * **原理：** 在 ZeRO-1 的基础上，进一步把“梯度”也切分了。在反向传播计算梯度时，不同 GPU 计算出的梯度通过 Reduce-Scatter 操作聚合到对应的分片 GPU 上，而不是每张卡都持有完整梯度。
  * **效果：** 进一步降低显存占用。
* ZeRO-3 : 对优化器状态、梯度分片以及模型权重参数分片（Optimizer States & Gradients & Parameters Sharding）
  * **原理：** 连“模型参数”本身都切分了。每张 GPU 上只存放 $$1/N$$ 的模型权重。
    * **前向传播时：** 当需要计算某一层时，持有该层参数的 GPU 通过 **All-Gather** 广播给所有 GPU。大家计算完该层后，立即释放这些参数（除了自己持有的那部分）。
    * **反向传播时：** 同理，需要参数时动态拉取，用完即扔。**效果：** 显存占用极低，显存消耗与 GPU 数量 $$N$$ 成反比。理论上可以训练无限大的模型（只要卡够多）。
    * **代价：** 会增加额外的通信开销（参数需要反复的 All-Gather），通常会比 ZeRO-1/2 慢一些，但在超大模型上是唯一的选择。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FtGtEZ2w1OQAj3VZ4wOU4%2Funnamed%20(1).jpg?alt=media&amp;token=7370fa3f-6684-4332-8881-5e661de0a321" alt=""><figcaption></figcaption></figure>

| **策略**          | **分片内容**        | **显存优化程度**    | **通信开销**    | **适用场景**       |
| --------------- | --------------- | ------------- | ----------- | -------------- |
| **Standard DP** | 无               | 低 (冗余严重)      | 低           | 小模型            |
| **ZeRO-1**      | 优化器状态           | **中 (性价比高)**  | 低 (基本无增量)   | 中大模型通用首选       |
| **ZeRO-2**      | 优化器状态 + 梯度      | **高**         | 低           | 显存较紧张时         |
| **ZeRO-3**      | 优化器状态 + 梯度 + 权重 | **极高 (线性扩展)** | 中 (增加约 50%) | 超大模型 / 单卡显存不足时 |


# 异构系统并行

上述的方法中，通常需要大量的 GPU 来训练一个大型模型。然而，人们常常忽略一点，与 GPU 相比，CPU 的内存要大得多。在一个典型的服务器上，CPU 可以轻松拥有几百GB甚至上TB的内存，而每张 GPU 卡通常只有 40 或 80 GB的内存。因此可以利用 CPU 内存甚至是 NVMe 磁盘来进行分布式训练（在不使用张量时，将其卸载回 CPU 内存或 NVMe 磁盘）。

通过使用异构系统架构，有可能在一台机器上容纳一个巨大的模型。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FyxSzRTZoLkTAm1HH4ARH%2Fimage.png?alt=media&amp;token=ef51c3b4-3bf9-4bbb-a0b7-3bcb88748c8a" alt=""><figcaption></figcaption></figure>

异构系统并行让 **GPU** 和 **CPU**协同工作：

* **GPU 的角色：** **计算单元**。它速度快，但显存（VRAM）昂贵且有限。
* **CPU 的角色：** **存储单元 + 辅助计算**。它的内存（RAM）便宜且巨大。

#### 异构系统并行机制

1. **存储阶段：** 模型的大部分参数、梯度和优化器状态平时都保存在 **CPU 内存**中。
2. **加载阶段：** 当 GPU 需要计算某一层时，才通过 PCIe 总线将这部分数据从 CPU 传输到 GPU 显存。
3. **计算阶段：** GPU 完成前向传播或反向传播的计算。
4. **卸载阶段（Offload）：** 计算完成后，GPU 立即将结果或不再需要的参数传回 CPU，释放 GPU 显存给下一层使用。

如果模型大到连 CPU 内存都装不下（如万亿参数模型），系统可以将数据进一步卸载到高速 NVMe SSD 硬盘上。虽然速度比内存更慢，但它提供了近乎无限的存储空间，理论上可以在单机上微调极其巨大的模型。

这是一种“以时间换空间”的策略

* **优点：** 极大地降低了训练大模型的门槛。可以在单张 24GB 显存的卡上微调很大的模型。
* **缺点：** 训练速度会变慢。因为 CPU 和 GPU 之间的数据传输（PCIe 带宽）成为了瓶颈，且 CPU 的计算速度远不如 GPU。


# 数据准备


# 课程学习

课程学习是一种训练策略，模仿人类的学习过程，主张让模型先从容易的样本开始学习，并逐渐进阶到复杂的样本和知识。

### 为什么做课程学习

传统的 LLM 训练方法往往依赖海量数据蒸馏（如DeepSeek-R1-Distill使用80万条SFT数据），或者盲目堆砌token数量，却忽视了模型学习的内在规律。很容易造成训练不稳定或过拟合。

论文: **Light-R1: Curriculum SFT, DPO and RL for Long COT from Scratch and Beyond （**[https://arxiv.org/pdf/2503.10460](https://arxiv.org/pdf/2503.10460%EF%BC%89%E6%8F%90%E5%87%BA%E8%AE%A9%E9%82%A3%E4%BA%9B**%E5%8E%9F%E6%9C%AC%E4%B8%8D%E5%85%B7%E5%A4%87%E9%95%BFCoT%E8%83%BD%E5%8A%9B**%E7%9A%84%E5%9F%BA%E7%A1%80%E6%A8%A1%E5%9E%8B%EF%BC%88%E5%A6%82Qwen2.5-32B-Instruct%EF%BC%89%EF%BC%8C%E9%80%9A%E8%BF%87%E6%B8%90%E8%BF%9B%E5%BC%8F%E9%9A%BE%E5%BA%A6%E6%8F%90%E5%8D%87%EF%BC%8C%E5%BE%97%E5%88%B0**%E6%8E%A8%E7%90%86%E8%83%BD%E5%8A%9B**%E7%9A%84%E6%8F%90%E5%8D%87**%E3%80%82**))，提出让那些**原本不具备长CoT能力**的基础模型（如Qwen2.5-32B-Instruct），通过渐进式难度提升，得到**推理能力**的提升。

### 怎么做课程学习

Light-R1 实施了一套多阶段后训练流程：

#### **Stage 1 SFT**

SFT 分为两阶段：

1. 使用**76,000条**数学推理数据建立基础CoT能力，重点是让模型掌握基本的思维链格式和简单推理模式。
2. 使用精心筛选的3,000条最具挑战性的题目，这3,000题与第一阶段的76,000题在知识结构上互补，专门填补模型的"逻辑盲区”，难度分布经过精心设计，确保模型在"舒适区边缘"持续成长。

#### Stage 2 **DPO**

SFT 阶段让模型学会了**解题格式和基础推理模式**，但生成的回答往往存在这些问题：

* 步骤冗余、重复推导
* 语言表达拖沓或过于简略
* 虽然答案正确，但过程不够清晰优雅

在SFT之后，采用**半在线 DPO** 进行偏好优化，在不引入过高计算成本的前提下，利用**偏好对比学习**让模型学会区分"好回答" vs "差回答"，从而精炼输出质量。

传统离线 DPO 使用预先生成的、固定的偏好对，数据分布与当前模型分布不匹配，模型容易过拟合到旧策略的偏好上。

**"半在线"的含义**：

* **在线**：偏好对中的 `chosen` 和 `rejected` 来自**当前模型**的实时采样（而非旧模型或人工标注）
* **离线**：训练前会预筛选一批题目，这些题目是固定的（不会在线切换题目池）
* **混合**：有时也会混入一部分高质量人工标注或验证过的 SFT 数据作为 anchor

#### Stage 3 GRPO

* **离线数据选择**：预先筛选通过率在0.25-0.625之间的"黄金难度"题目
  * 太简单（通过率>0.625）：长度崩溃，模型太容易做对，GRPO 的组内对比信号弱，倾向于生成极短响应
  * 太难（通过率<0.25）：训练不稳定，模型几乎全错，组内都是负样本，梯度方差大，policy 更新剧烈震荡
* **在线优化**：在筛选后的数据上进行GRPO训练，实现**响应长度和奖励分数的同步增长**

### 效果如何

在数学推理能力方面，Light-R1 系列模型展现出与更大规模模型相当或更优的测试成绩。同时，Light-R1 拥有了一定的跨领域泛化能力，尽管课程学习主要基于数学数据训练，Light-R1-14B-DS在GPQA（ graduate-level science benchmark）这类科学问答任务中也表现出相应的推理能力。这表明数学推理训练所产生的逻辑结构可能具有一定的领域迁移性。

在数据使用效率上，研究表明第二阶段使用的3000条精选难题对模型性能产生了积极影响。该数据集与第一阶段76000条数据及DeepSeek-R1-Distill使用的800000条数据在知识覆盖上存在差异，针对模型在基础训练后仍存在的特定推理缺陷进行了补充。实验观察到，这3000条数据在7B、14B和32B三种不同参数规模的模型上均带来了性能改善。


# 预训练

**预训练**是 LLM 能力形成的基石阶段。作为自监督学习在海量无标注文本上的规模化实践，预训练通过训练目标 Next Token Prediction 将分布式语义知识压缩至模型参数中，构成后续监督微调（SFT）与强化学习（RL）对齐阶段的初始化基础。

{% stepper %}
{% step %}

### **数据工程**

* **大规模语料采集**：Common Crawl、GitHub、书籍、论文、代码等多源数据
* **质量控制**：启发式过滤（长度 / 重复 / 符号比）、基于模型的质量打分（如 FastText/Perplexity 过滤）、去重策略（MinHash/LSH）、隐私脱敏（PII 移除）
* **数据配比**：不同领域数据的最优混合比例（DoReMi、课程学习）
  {% endstep %}

{% step %}

### **超参配置**

* **学习率调度**：Warmup-Stable-Decay（WSD）、Cosine decay with restarts、Linear decay 的具体选择
* **Batch Size 调度**：从 small batch 逐渐增大到 full batch（LARGE BATCH TRAINING）
* **优化器细节**：AdamW（β1/β2/ε 的设置）、Adafactor等新型优化器对比
* **权重衰减与正则化**：为什么 Dropout 一般在预训练中不使用
* **超参数搜索：**&#x81EA;动寻找最佳参数
  {% endstep %}

{% step %}

### **训练稳定性**

* **混合精度训练**：FP16/BF16 的选择标准、Loss scaling 机制、GradScaler 原理
* **激活重计算（Gradient Checkpointing）**：时间与显存的 trade-off
* **梯度裁剪（Gradient Clipping）**：global norm 阈值设置
* **损失尖峰（Loss Spike）处理**：检测机制与回滚策略
  {% endstep %}

{% step %}

### **长上下文扩展**

* **渐进式扩展**：从 4k → 32k → 128k 的多阶段预训练
* **位置编码适配**：ALiBi、RoPE 外推/内插（NTK-aware, YaRN）、动态位置编码
* **稀疏注意力**：Sliding Window、FlashAttention 在预训练中的集成
  {% endstep %}

{% step %}

### **评估与监控**

* **中间评估（Mid-training Eval）**：PPL 之外，阶段性的下游任务 zero-shot/few-shot 评测（HellaSwag、MMLU 等）
  {% endstep %}
  {% endstepper %}

### 参考

1. <https://zhuanlan.zhihu.com/p/718354385>


# 数据工程

### 1 如何获取**大规模预训练数据？**

Common Crawl、GitHub、书籍、论文、代码等多源数据。

目前也有很多开源的pretrain数据可以使用：

| 数据集名称                 | 数据类型  | 官方链接                                                                    | 规模              | 说明/备注                                   |
| --------------------- | ----- | ----------------------------------------------------------------------- | --------------- | --------------------------------------- |
| **FineWeb**           | 英文网页  | <https://huggingface.co/datasets/HuggingFaceFW/fineweb>                 | 15T tokens      | HuggingFace 高质量清洗，2013-2024 CC 数据       |
| **FineWeb-2**         | 多语言网页 | <https://huggingface.co/datasets/HuggingFaceFW/fineweb-2>               | 1000+ 语言        | FineWeb 多语言版，覆盖稀缺语种                     |
| **FineWeb-Edu**       | 教育网页  | <https://huggingface.co/datasets/HuggingFaceFW/fineweb-edu>             | 1.3T tokens     | 教育内容筛选，适合数学/推理训练                        |
| **RedPajama-V1**      | 综合    | <https://huggingface.co/datasets/togethercomputer/RedPajama-Data-1T>    | 1.2T tokens     | Together 出品，模仿 LLaMA 配方（CC+GitHub+书+论文） |
| **RedPajama-V2**      | 网页    | <https://huggingface.co/datasets/togethercomputer/RedPajama-Data-V2>    | 30T tokens（清洗后） | 100T 原始，提供 40+ 质量注释信号                   |
| **SlimPajama**        | 综合    | <https://huggingface.co/datasets/cerebras/SlimPajama-627B>              | 627B tokens     | Cerebras 深度清洗版，基于 RedPajama-V1          |
| **RefinedWeb**        | 网页    | <https://huggingface.co/datasets/tiiuae/falcon-refinedweb>              | 5T tokens       | TII/Falcon 出品，90% 淘汰率高质量纯网页             |
| **DCLM-Pool**         | 原始网页  | <https://huggingface.co/datasets/mlfoundations/dclm-pool>               | 340TB 原始        | DeepMind 开源最大原始网页池                      |
| **DCLM-Baseline**     | 网页    | <https://huggingface.co/datasets/mlfoundations/dclm-baseline>           | 7T tokens       | DCLM 清洗后基准版                             |
| **Dolma**             | 综合    | <https://huggingface.co/datasets/allenai/dolma>                         | 3T tokens       | AI2 出品，含代码、论文、书籍、百科、Reddit              |
| **Dolma-2**           | 综合    | <https://huggingface.co/datasets/allenai/dolma-v2>                      | 3.5T tokens     | Dolma 升级版                               |
| **The Pile**          | 综合    | <https://huggingface.co/datasets/EleutherAI/pile>                       | 825GB / 1.4B 文档 | EleutherAI 经典数据集，22 个子集（学术/代码/书）        |
| **The Pile-T5**       | 综合    | <https://huggingface.co/datasets/EleutherAI/pile-t5-base>               | 去重版             | T5 训练优化版，已全局去重                          |
| **The Stack**         | 代码    | <https://huggingface.co/datasets/bigcode/the-stack>                     | 6.4TB，358 语言    | BigCode 出品，permissive 许可证过滤             |
| **The Stack v2**      | 代码+   | <https://huggingface.co/datasets/bigcode/the-stack-v2>                  | 30TB+           | 含 GitHub Issues/PRs/Kaggle notebooks    |
| **StarCoderData**     | 代码    | <https://huggingface.co/datasets/bigcode/starcoderdata>                 | 783GB，86 语言     | 含 Issues、Jupyter notebooks、Commits      |
| **The Stack Smol**    | 代码子集  | <https://huggingface.co/datasets/bigcode/the-stack-smol>                | 每种语言 1 万样本      | 小型实验用子集                                 |
| **Fineweb-Code**      | 代码网页  | <https://huggingface.co/datasets/OpenCoder-LLM/opc-fineweb-code-corpus> | 55B tokens      | 从 FineWeb 召回的高质量代码相关网页                  |
| **OpenWebMath**       | 数学    | <https://huggingface.co/datasets/open-web-math/open-web-math>           | 14.7B tokens    | 数学网页提取自 CC                              |
| **Fineweb-Math**      | 数学    | <https://huggingface.co/datasets/OpenCoder-LLM/opc-fineweb-math-corpus> | 数学相关            | 从 FineWeb 召回的数学内容                       |
| **FineMath**          | 数学    | <https://huggingface.co/datasets/HuggingFaceTB/finemath>                | -               | HuggingFace 数学数据集                       |
| **Proof-Pile-2**      | 数学证明  | <https://huggingface.co/datasets/EleutherAI/proof-pile-2>               | -               | EleutherAI 数学与形式化证明数据                   |
| **MegaMath**          | 数学    | <https://huggingface.co/datasets/batch-dit/MegaMath>                    | 370B tokens     | 史上最大数学预训练集（2014-2024）                   |
| **Algebraic Stack**   | 数学代码  | <https://huggingface.co/datasets/EleutherAI/proof-pile-2>               | -               | 数学论文、形式化代码、教材                           |
| **CCI** (中文)          | 中文网页  | <https://huggingface.co/datasets/BAAI/CCI-Data>                         | 104GB           | 智源研究院中文互联网语料库                           |
| **CCI2** (中文)         | 中文网页  | <https://huggingface.co/datasets/BAAI/CCI2-Data>                        | 501GB           | CCI 升级版                                 |
| **CCI3** (中文)         | 中文网页  | <https://huggingface.co/datasets/BAAI/CCI3-Data>                        | -               | CCI 最新版（2023.01-06）                     |
| **ChineseWebText**    | 中文网页  | <https://huggingface.co/datasets/CASIA-LM/ChineseWebText2.0>            | -               | 中科院自动化所高质量中文网页                          |
| **MAP-CC**            | 多语言中文 | <https://huggingface.co/datasets/m-a-p/MAP-CC>                          | 2000 语言+中文      | M-A-P 多语言中文语料                           |
| **SkyPile-150B**      | 中文    | <https://huggingface.co/datasets/Skywork/SkyPile-150B>                  | 150B tokens     | Skywork 中文预训练数据                         |
| **TigerBot-pretrain** | 中文    | <https://huggingface.co/datasets/TigerResearch/tigerbot-pretrain>       | 2TB（开源 100GB）   | TigerBot 中文预训练集（书+百科+网页）                |
| **WanJuan**           | 中文综合  | <https://opendatalab.org.cn/OpenDataLab/WanJuan1.0>                     | -               | 上海 AI Lab 万卷数据集（需官网下载）                  |
| **TeleChat-PTD**      | 中文    | <https://huggingface.co/datasets/Tele-AI/TeleChat-PTD>                  | -               | 电信 AI 中文预训练数据                           |
| **PeS2o**             | 学术论文  | <https://huggingface.co/datasets/allenai/PeS2o>                         | 30B tokens      | AI2 学术论文数据集（OpenAlex 衍生）                |
| **WebStories**        | 故事/创意 | <https://huggingface.co/datasets/HuggingFaceFW/webstories>              | -               | HuggingFace 创意写作数据集                     |
| **Dolma-Flan**        | 指令数据  | <https://huggingface.co/datasets/allenai/dolma-flan>                    | -               | Dolma 配套指令微调数据                          |
| **CulturaX**          | 多语言   | <https://huggingface.co/datasets/uonlp/CulturaX>                        | 6.3TB，167 语言    | 多语言预训练数据集                               |

**选多少数据量比较合适？**

根据 DeepMind 在2022年的Chinchilla模型实验，在给定的计算预算（FLOPs）下，模型参数量（N）与训练数据量（D）应以相同比例缩放，具体比例为1:20，即每 1B 参数需匹配 20B  的训练数据。

**不同文本的知识密度是有差异的**

在 RedPajama-V2 等数据集中，知识密度通过 **Wikipedia 训练的 n-gram 语言模型困惑度** 来衡量，

* **Head（头部）**：低困惑度（perplexity 低），语言规范、信息密集（如 Wikipedia、教科书）
* **Middle（中部）**：中等困惑度，一般网页内容
* **Tail（尾部）**：高困惑度（perplexity 高），低质量文本（广告、垃圾信息、随机字符串）

### 2 数据过滤

#### 2.1 启发式过滤

典型过滤条件有：

* 语言
* 长度：太短文本（如导航栏、页脚），过长文本（可能是抓取错误）
* 符号与格式：符号占比过高（如乱码、表情符号堆叠、大量停用词、HTML格式残留）

#### 2.2 基于模型过滤

基于模型的过滤分为标签过滤和分数过滤，标签过滤就是去掉你不想要的文本类别（比如代码类），分数过滤就是去掉低质量数据，或按分数加权采样。

标签过滤的方式：

* 使用 FastText 模型分类：FastText 是微软开源的模型，将整篇文档的词及n-gram向量叠加平均得到文档向量，然后使用文档向量做softmax多分类。
* 自己训练分类器：通常使用 BERT 之类的 encoder-decoder 模型，训练一个分类器

**标签体系设计建议**

* **粗粒度**（5-10类）：如 `academic`, `code`, `news`, `forum`, `novel`, `ads`, `spam`
* **细粒度**（20+类）：如 `arxiv_cs`, `arxiv_math`, `github_python`, `github_js`, `wikipedia`, `textbook`, `patent`, `law`, `medical`

分数过滤的方式

* Perplexity 过滤：计算文档困惑度作为质量指标。困惑度越低，说明文本越符合自然语言分布规律（通常为高质量书写文本）。**PPL越低越好**：表示模型对下一个词的预测越准确。
  * PPL（Perplexity，**困惑度**）的标准公式为：

$$\text{PPL}(W) = P(w\_1, w\_2, \ldots, w\_N)^{-\frac{1}{N}} = \exp\left(-\frac{1}{N}\sum\_{i=1}^{N}\log P(w\_i|w\_1\ldots w\_{i-1})\right)$$

* 自己训练一个打分器，训练方法同上文的标签过滤
* LLM-as-Judge：最简单也是最烧钱的方法，用更好的LLM作为打分器

#### 2.3 隐私脱敏

**PII** = **Personally Identifiable Information**（个人身份信息），指任何可用于识别、定位或联系特定个人的数据。

常见的需要脱敏的数据如下：

| 类别         | 示例                     | 检测方法                |
| ---------- | ---------------------- | ------------------- |
| **基础标识**   | 姓名、身份证号、手机号、邮箱、地址      | 正则表达式 + 字典匹配        |
| **金融信息**   | 银行卡号、信用卡CVV、交易记录       | 校验位算法（Luhn算法）+ 模式匹配 |
| **网络标识**   | IP地址、MAC地址、Cookie、设备ID | 正则 + 网络协议解析         |
| **生物特征**   | 指纹、面部识别数据、DNA序列        | 文件头检测（通常以二进制存储）     |
| **上下文PII** | "我住在朝阳区"（需结合说话人身份）     | NER模型 + 依存句法分析      |

### 3 数据去重

训练语料中的重复数据会导致训练效率下降、模型过拟合重复文本，降低泛化能力。

预训练中数据去重的级别一版分为：

* **文档级：**&#x6574;篇文档的完全或近似重复
* **段落级：**&#x6587;档内或跨文档的段落重复
* **子串级：**&#x8FDE;续字符串有重复

除了硬匹配和一些常见的相似度检测算法，去重常用的算法是 MinHash-LSH：

#### &#x20;MinHash 算法原理

**数学基础：Jaccard 相似度估计**

对于两个集合 $$A$$ 和 $$B$$，Jaccard 相似度为： $$J(A,B) = \frac{|A \cap B|}{|A \cup B|}$$

直接计算 Jaccard 需要 $$O(|A|+|B|)$$ 的存储和计算，**MinHash** 通过**概率 sketch** 将复杂度降至 $$O(1)$$。

**算法步骤**：

1. **Shingling（分片）**：将文档切分为连续的 $$k$$-gram 集合

   ```python
   # 5-gram 字符级 shingles（推荐代码/网页数据）
   def get_shingles(text, k=5):
       return {text[i:i+k] for i in range(len(text)-k+1)}
   # 示例："hello world" → {'hello', 'ello ', 'llo w', 'lo wo', 'o wor', ' worl', 'world'}
   ```
2. **Hash 签名生成**： 使用 $$n$$ 个独立的哈希函数 $$h\_1, h\_2, ..., h\_n$$，对每个 shingle 计算哈希值。

   MinHash 签名 $$sig(A)$$ 的第 $$i$$ 个分量是： $$sig\_i(A) = \min\_{x \in A} h\_i(x)$$

   即：对每个哈希函数，取集合 $$A$$ 中所有元素哈希值的**最小值**。
3. **相似度估计**： $$J\_{est}(A,B) = \frac{\text{matches}}{n}$$ 其中 matches 是 $$sig(A)$$ 和 $$sig(B)$$ 中相等位置的数量。

**概率保证**：估计误差为 $$O(1/\sqrt{n})$$，通常 $$n=128$$ 或 $$256$$ 可提供足够精度。

**LSH（局部敏感哈希）加速**

**问题**：当文档数量达到十亿级时，两两比较 MinHash 签名（$$O(N^2)$$）不可行。

**LSH 策略**：将签名分桶，仅比较同一桶内的文档。

### 4 数据配比

前面我们训练的分类器，再这里也能够派上用场。

大部分中文模型的数据配比为：中：英：code = 4:4:2。

也可以使用一些方法来优化数据配比，例如DoReMi。

#### 4.1 DoReMi

DoReMi 是 Google DeepMind 开源的一套自动调整数据配比的方法，简单来说就是**多采样模型相对学得不好的数据。**

DoReMi 通过比较参考模型（Reference Model）**与**生产模型（Proxy Model）的性能差距（Excess Loss）来动态调整权重：

$$\text{Excess Loss}*d = \mathbb{E}*{x \sim P\_d}\[-\log Q\_\alpha(x)] - \mathbb{E}*{x \sim P\_d}\[-\log Q*{ref}(x)]$$

其中：

* $$Q\_{ref}$$：在**均匀分布**数据上训练的小模型（捕捉基线能力）
* $$Q\_\alpha$$：在当前权重 $$\alpha$$ 下训练的小模型（验证者）
* **核心洞察**：若某领域的 Excess Loss > 0（生产模型比参考模型差），说明该领域训练不足，需**增加采样权重**

#### 算法流程

**Step 1 - 训练参考模型**：在均匀采样（各领域等概率）的数据上训练一个小规模参考模型（通常为主模型 1/10 规模，如 280M 参数），记录各领域验证集上的基线损失 $$L\_{ref}^{(d)}$$。

**Step 2 - 迭代优化权重**（通常 3-5 轮）：

1. 按当前权重 $$\alpha$$ 采样数据，训练同等规模的代理模型（Proxy Model）
2. 计算各领域 Excess Loss（代理模型损失 - 参考模型损失）
3. **权重更新**：对 Excess Loss 大的领域增加权重（Multiplicative Weights Update）： $$\alpha\_d^{t+1} \propto \alpha\_d^t \cdot \exp(\eta \cdot \text{Excess Loss}\_d)$$
4. 归一化权重并迭代，直至权重收敛（最大变化 < 1%）或 Max Excess Loss 不再降低

**Step 3 - 应用最优权重**：将收敛后的权重应用于大规模模型（如 7B/70B）的实际训练。

### 参考

1. <https://arxiv.org/abs/2305.10429>


# 超参配置

### 0 快速决策表

<table data-header-hidden><thead><tr><th>超参数</th><th width="243.666748046875">大规模预训练 （多机多卡）</th><th>中等规模/单卡预训练（单机多卡/单机单卡）</th><th>LoRA微调</th></tr></thead><tbody><tr><td><strong>学习率调度</strong></td><td><strong>WSD</strong><br>• Warmup: 1-2%<br>• Stable: 88-89%<br>• Decay: 10% 步数 → 0.1×Peak<br>Peak: 3e-4 ~ 1e-4（随模型参数增大降低）</td><td><strong>WSD</strong><br>比例同上，但可延长 Warmup 至 5%<br>Peak: 1e-4 ~ 5e-5</td><td><strong>WSD</strong><br>• Warmup: 10% 步数<br>• Stable: 80%<br>• Decay: 10%<br><strong>Peak: 2e-4</strong></td></tr><tr><td><strong>Batch Size</strong></td><td><strong>最小可行</strong><br>Global Batch: 4M-8M tokens<br>（约 16-32 样本 × 序列长度 × GPU数）<br>不使用梯度累积</td><td><strong>最小可行</strong><br>大约 1-16<br>不使用梯度累积</td><td><strong>16-32</strong><br>可通过梯度累积实现</td></tr><tr><td><strong>优化器</strong></td><td><strong>AdamW /</strong> <strong>Muon</strong>（实验性，省50%显存）</td><td><strong>AdamW</strong></td><td><strong>AdamW</strong></td></tr><tr><td><strong>AdamW 参数</strong></td><td>β1=0.9<br><strong>β2=0.95</strong>（预训练关键）<br>ε=1e-5（LLM稳定值）<br>Weight Decay: <strong>0.01</strong> (GPT) / <strong>0.1</strong> (LLaMA)</td><td>β1=0.9<br>β2=0.99~0.999（按 half-life 缩放）<br>ε=1e-5<br>Weight Decay: 0.01-0.1</td><td>β1=0.9<br>β2=0.999<br>ε=1e-6<br>Weight Decay: <strong>0.01</strong>（通常更低）</td></tr><tr><td><strong>Epoch/步数</strong></td><td><strong>1 epoch</strong><br>（Single-pass，数据量 > 1T tokens）</td><td><strong>1-2 epochs</strong></td><td><strong>3-5 epochs</strong><br>+ Early Stopping</td></tr><tr><td><strong>梯度裁剪</strong></td><td>1.0</td><td>1.0</td><td><strong>1.0-5.0</strong><br>配合 2e-4 学习率</td></tr><tr><td>其它</td><td>• 禁用 Dropout 提升下游任务性能<br>• 优先用最大 batch size 而非梯度累积</td><td><ul><li>学习率需按 √B 缩放</li></ul></td><td>• rank 通常 8-64<br>• alpha = 2×rank<br>• target_modules: q_proj, v_proj</td></tr></tbody></table>

### 1 学习率调度

> "学习率越大，微调速度越快，但你必须在速度与跳过最优解或导致训练不稳定的风险之间取得平衡。"

当前 LLM 预训练的首选 **Warmup-Stable-Decay (WSD)**

分为三个阶段：

* **Warmup**：线性预热（通常占总步数的1-2%），从0升至峰值学习率（如 $$6\times10^{-4}$$）
* **Stable**：长时间保持恒定学习率
* **Decay**：在选定checkpoint后，使用快速衰减（如线性或余弦衰减至峰值的10%）

**核心优势**：

1. **连续训练友好**：无需预先确定总步数，可从stable阶段的任意checkpoint分支进行decay实验
2. **loss动态独特**：stable阶段loss下降缓慢（高于Cosine schedule），但decay阶段会出现**sharp drop**（DeepSeek、OLMo、MiniMax 等训练日志中均有记录），最终性能往往优于Cosine

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FreCID6YIFLL7HiK0Tgas%2Fimage.png?alt=media&amp;token=83293038-65de-45e3-ae27-8109f669cf5c" alt=""><figcaption></figcaption></figure>

**Cosine Decay with Restarts vs. Linear Decay**

* **Cosine Annealing**：需要预先确定总训练步数，学习率平滑下降。虽然稳定，但缺乏灵活性，无法轻松扩展训练
* **Linear Decay**：简单直接，但可能导致后期学习率下降过快，不如Cosine平滑

**如何调整学习率**

* 密切关注训练损失。如果出现突然的峰值或"NaN"（非数字）值，这是危险信号——立即降低学习率。一个经验法则是将预热步数设置为总训练步数的10%。

***

### 2 如何设置 Batch Size

&#x20;Batch Size 越大，学习率肯定越大

苏剑林在《当 Batch Size 增大时，学习率该如何随之变化？》 中系统梳理了几种主流视角：

#### 一、方差视角（平方根缩放）

最早的理论认为，batch size 扩大到 $$n$$ 倍时，学习率应扩大到 $$\sqrt{n}$$ 倍。推导基于**保持 SGD 增量的方差不变**：

* Batch size 增大 → 梯度协方差矩阵缩小为 $$1/B$$ → 为保持噪声强度，学习率需满足 $$\eta^2/B = \text{常数}$$ → $$\eta \propto \sqrt{B}$$

#### 二、直面损失视角（单调有界缩放）

OpenAI《An Empirical Model of Large-Batch Training》提出更本质的二阶近似分析：

* 最优学习率$$\eta^\* \approx \frac{\eta\_{max}}{1 + \mathcal{B}\_{\text{noise}}/B}$$
* **关键结论**：学习率随 batch size 增加而**单调递增但有上界** $$\eta\_{max}$$
* 当 $$B \ll \mathcal{B}\_{\text{noise}}$$（小 batch）：近似**线性缩放** $$\eta \propto B$$
* 当 $$B \gg \mathcal{B}\_{\text{noise}}$$（大 batch）：学习率趋于饱和，**不应继续增大**

其中 $$\mathcal{B}\_{\text{noise}} = \frac{\text{tr}(\Sigma)}{g^\top g}$$ 是**信噪比倒数**，反映梯度噪声强度与信号强度的比值。

前沿 LLM（GPT、Llama 等）通常在**大规模集群**上使用极大的 batch size（数百万 token），因为：

* 梯度估计更稳定，可使用更大学习率加速收敛
* 最大化 GPU 吞吐量（throughput），提高训练效率
* 配合 Adam/AdamW 等复杂优化器

所以，通常会使用**硬件能支持的最大 batch size。**

#### 梯度累积有什么陷阱？

当显存不足时，常见做法是通过梯度累积模拟大 batch。但需要注意的是，梯度累积不会提供吞吐量收益，只是通过"以时间换空间"增加训练 wall-clock 时间，且可能使超参调优复杂化。

***

### 3 如何选择优化器

#### **AdamW**

解耦权重衰减与L2正则化，避免Adam中自适应梯度导致的权重衰减效果衰减问题，与 Adam 的 L2 正则化的区别：

* **Adam 的 L2**：梯度更新为 $$\theta \leftarrow \theta - \eta(\frac{\hat{m}}{\sqrt{\hat{v}}+\epsilon} + \lambda\theta)$$，其中自适应项 $$\frac{1}{\sqrt{\hat{v}}}$$ 会**削弱**权重衰减效果（梯度大的参数权重衰减小）
* **AdamW**：直接将权重衰减应用于参数更新步骤 $$\theta \leftarrow \theta - \eta\frac{\hat{m}}{\sqrt{\hat{v}}+\epsilon} - \eta\lambda\theta$$，**不受梯度尺度影响**，所有参数以相同速率 $$\lambda$$ 衰减

**参数设置**：

* **β1（一阶矩衰减）**：0.9
* **β2（二阶矩衰减）**：0.95（预训练）或 0.999（微调）。**0.95在预训练中表现更好，**&#x8F83;小的二阶矩衰减率意味着更快的"遗忘"速度，使优化器对数据分布的非平稳性（预训练数据在不同阶段有不同特征）更敏感，适应更快。0.999在SFT任务上表现更好，微调时数据分布稳定，需要长期累积二阶统计信息以获得更平滑的梯度估计。
* **ε（数值稳定性）**：$$1\times10^{-5}$$ 到 $$1\times10^{-8}$$。较大的ε（如1e-5）在LLM训练中更稳定，防止除以极小值，在梯度稀疏的大模型中避免数值爆炸
* **权重衰减**：0.01（GPT架构）到 0.1（LLaMA/T5架构）

#### **Muon**

**核心机制：梯度正交归一化**

由 Keller Jordan 提出（2024），针对**矩阵参数**（如线性层权重 $$W \in \mathbb{R}^{m \times n}$$）设计：

1. 对梯度矩阵 $$G$$ 进行 SVD 分解：$$G = U \Sigma V^T$$
2. **正交化梯度**：$$G\_{orth} = U V^T$$（丢弃奇异值 $$\Sigma$$，仅保留旋转分量）
3. 更新规则：$$W \leftarrow W - \eta \cdot G\_{orth} + \text{AdamW-style 权重衰减}$$

**为什么有效**：

* 正交矩阵的谱范数为 1，防止更新步长过大导致的训练不稳定
* 强制梯度在正交流形上更新，保持参数矩阵的良好条件数，改善梯度传播
* **内存效率**：不需要存储二阶矩（无 $$v$$ 统计量），仅需存储梯度本身，比 AdamW 节省约 50% 优化器状态内存
* 适合**大规模预训练**作为 AdamW 的替代，在 Cerebras 和部分开源 LLM 训练中表现出色。

#### **Adafactor**

**优势**：

* **内存效率**：通过因子分解二阶动量矩阵（$$v \approx R \times C$$），将显存占用从Adam的**12 bytes/参数**降至**4-8 bytes/参数**
* 适合千亿参数模型或单卡训练（如24GB显存训练13B模型）

**代价**：

* 需要更精细的超参调优（学习率通常需比Adam大2-10倍）
* 收敛速度略慢，下游任务性能可能略低于AdamW

| 优化器           | 内存占用       | 计算开销      | 推荐场景           | 关键权衡                               |
| ------------- | ---------- | --------- | -------------- | ---------------------------------- |
| **AdamW**     | 高（12B/参数）  | 基准        | 通用首选，特别是有充足显存时 | 最稳定，但内存压力大                         |
| **Muon**      | 中（\~6B/参数） | 低（+SVD开销） | 大规模矩阵参数训练      | 需要实现 SVD，可能对非矩阵参数（如 Embedding）效果一般 |
| **Adafactor** | 低（4-8B/参数） | 低         | 显存受限（单卡/长序列）   | 需精细调参，收敛稍慢                         |

***

### 4 权重衰减与正则化

**为什么 LLM 预训练中不需要 Dropout 了（p=0.0）**

大规模语料上的单轮预训练很少产生过拟合，而Dropout引入的噪声会阻碍收敛速度，不使用Dropout的模型在下游任务（BLiMP、SQuAD、MNLI）上表现更好。

**权重衰减（Weight Decay）**

* **推荐值**：0.01-0.1（AdamW中）
* **μP（Maximal Update Parametrization）**：使用μP时，学习率和权重 decay 需按宽度进行缩放，可实现超参数从小模型向大模型的零样本迁移

***

### 5 超参搜索

确定了关键超参数后，下一个挑战是如何有效地微调它们。自动化优化方法可以通过系统地探索不同配置来简化这一过程。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Ftu0DocG3gc3iucOerafp%2Fimage.png?alt=media&amp;token=3e0b6734-7bd3-4d3f-84c4-da28fe711619" alt=""><figcaption></figcaption></figure>

#### 5.1 网格搜索与随机搜索

网格搜索涉及测试超参数的每一种可能组合。虽然这能保证对搜索空间进行全面探索，但缺点是计算成本高昂。添加的参数越多，成本就呈指数级增长。相比之下，随机搜索从预定义的分布中随机采样超参数值。这种方法可能是有效的，因为只有少数超参数对性能有重大影响。此外，由于每次试验都是独立的，可以并行运行多个实验。

#### 5.2 贝叶斯优化

贝叶斯优化采用更智能的方法，将超参数调优视为一个需要学习的问题。它使用概率模型（通常是高斯过程）基于先前结果预测哪些超参数组合可能表现良好。这种方法在探索新可能性和聚焦有前景的配置之间取得平衡。

#### 数学框架

**目标**：在超参数空间 $$\mathcal{X}$$ 中找到最小化 $$f(x)$$（如模型验证损失）的配置 $$x^\*$$

$$\displaystyle x^\* = \underset{x \in \mathcal{X}}{\arg\min} f(x)$$

其中 $$f(x)$$ 是**计算昂贵且不可导**的（需要完整训练一个模型）

#### 采集函数

**Upper Confidence Bound (UCB)**： $$\alpha\_{\text{UCB}}(x) = \mu(x) + \beta \sigma(x)$$

* $$\beta$$ 控制探索权重，最大化UCB意味着选择"可能很好或不确定性很高"的点

**Expected Improvement (EI)**： $$\alpha\_{\text{EI}}(x) = \mathbb{E}\[\max(0, f(x^+) - f(x))]$$

* $$x^+$$ 是当前最佳观测值，EI最大化预期提升量

#### **流程**：

1. 用当前数据集 $$D\_{1:t}$$ 拟合高斯过程 → 得后验 $$p(f|D)$$
2. 优化采集函数找到下一个评估点 $$x\_{t+1} = \arg\max\_x \alpha(x)$$
3. 评估 $$f(x\_{t+1})$$（训练模型），更新 $$D\_{t+1} = D\_t \cup (x\_{t+1}, f(x\_{t+1}))$$

#### 5.3 基于种群的训练（PBT）

将超参数优化视为**在线学习问题**，而非静态搜索。利用**部分训练好的模型作为" warm-start"**，通过演化算法动态调整超参数，最大化**计算资源利用率**而非样本效率。

#### 演化机制原理

**种群结构**：

* 维持 $$N$$ 个模型（个体）同时训练，每个个体 $$i$$ 拥有：
  * 当前权重 $$\theta\_i$$
  * 超参数配置 $$h\_i$$（学习率、dropout率等）
  * 当前性能指标 $$P\_i$$（验证准确率）

**异步更新循环**（每 $$T$$ 步执行一次）：

```
对于种群中每个个体 i：
    如果 performance(i) < 种群性能阈值（底部20%）：
        # 1. 淘汰（Exploitation）
        随机选择一个表现更好的个体 j（顶部20%）
        将 i 的权重复制为 j 的权重：θ_i ← θ_j
        将 i 的超参数复制为 j 的超参数：h_i ← h_j
        
        # 2. 变异（Exploration）
        对 h_i 进行随机扰动（如学习率 ×0.8 或 ×1.2）
        重置优化器状态（如Adam的moment估计）
```

### 参考

1. <https://arxiv.org/pdf/2507.17634>
2. <https://spaces.ac.cn/archives/10542>
3. <https://latitude.so/blog/fine-tuning-llms-hyperparameter-best-practices>
4. <https://arxiv.org/pdf/2507.07101>


# 训练稳定性

### 1 **混合精度训练**

#### 1.1 如何选择精度 FP16/BF16&#x20;

BF16 因其与 FP32 相同的8位指数范围，在Ampere架构（A100、H100）及更新的GPU上成为首选。（精度问题可以看之前的文章： [LLM精度问题](/llm-everything/train/llm-vram-needs/llm-precision))

相比之下，FP16的动态范围较窄，需要 GradScaler 通过 Loss scaling 机制来维护数值稳定性。

工作原理如下：

1. 在反向传播前将损失值乘以缩放因子（初始值通常为$$2^{16}$$或65536），放大梯度以避免FP16表示范围内的下溢
2. 完成梯度计算后再将权重更新除以相同因子恢复原始尺度。
3. 当检测到Inf或NaN时，缩放因子会按回退系数（通常0.5）衰减并跳过当前优化步骤，反之则在连续若干步骤（增长间隔通常2000步）成功后按增长系数（通常2.0）提升。

这种动态调整确保了训练的稳定推进。

值得注意的是，BF16虽简化了实现，但研究表明即使标准的BF16混合精度训练在特定随机种子下仍可能导致约10%的运行出现发散。

### **2 激活重计算**

激活重计&#x7B97;**（Gradient Checkpointing）**&#x901A;过时间换取空间来缓解显存压力。

* 完全重计算（Full Recomputation）在每个Transformer层边界保存检查点，将激活内存从线性复杂度O(N)降至平方根复杂度O(√N)，实现50-70%的内存节省，但会引入30-40%的计算开销。
* 选择性重计算（Selective Recomputation）识别出内存密集但计算廉价的操作（如注意力机制中的Softmax和Dropout层）进行针对性重计算，仅增加约7%的开销却能达到接近完全重计算的内存优化效果。在长序列场景下，结合序列并行（Sequence Parallelism）可将两者优势叠加，将内存需求降至基线的20%以下，同时将计算开销控制在4%以内。

### **3 梯度裁剪**

* 梯度裁剪是一种防止梯度爆炸的正则化技术，通过限制梯度范数大小来避免参数更新过大导致模型发散（Loss=NaN）
* 大模型（7B+参数）因参数量大、序列长（8K+ tokens）、使用低精度训练（FP16/BF16）及Transformer多层链式法则连乘特性，梯度爆炸风险显著高于传统模型

**主要实现方式**

* **按范数裁剪**：使用 `torch.nn.utils.clip_grad_norm_` 限制梯度向量的整体L2范数，保持梯度方向不变仅缩放大小，是大模型训练的首选方案
* **按值裁剪**：使用 `torch.clamp` 将每个梯度元素限制在固定范围内，实现简单但可能改变梯度方向引入偏差
* **动态自适应裁剪**：包括基于Z-Score统计动态计算阈值、监控裁剪频率自动调整、随训练进度渐进衰减阈值等方法，适用于LLM预训练及 **Loss Spike** 场景

### **4 Loss Spike 如何处理**

**Loss Spike** 指在模型预训练或微调过程中，损失值在单个或连续若干步骤内发生数量级跃升的现象。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2F3a2aBkKp15UeUbsJA7jk%2Fimage.png?alt=media&amp;token=2546d014-5fed-442a-8427-402e2d1433de" alt=""><figcaption></figcaption></figure>

**可能是如下原因：**

* **数据层异常：**&#x62;atch 内包含极端异常值、损坏样本、错误标注或编码异常文本，导致梯度更新方向偏离；训练数据流中特定领域数据（如超长文本、低质量网页内容）突然集中出现，破坏优化轨迹稳定性
* 学习率过高：Warmup 阶段过早结束导致优化器状态未充分初始化；Cosine Annealing 反弹阶段学习率恢复过快
* Loss计算错误：前向传播中触发除零、log(0)、exp 上溢或极小数开方（如 LayerNorm 中 variance 接近零时）；GradScaler 的 Loss Scaling 因子设置不当导致梯度上溢或下溢；动态缩放窗口（Growth Interval）过长无法及时响应数值漂移

**如何处理**

* 数据层面:
  * 数据清洗：移除或修正损坏/错误标注的样本。&#x20;
  * 异常值处理：对特征进行截断或鲁棒的归一化。&#x20;
  * 打乱数据：确保训练数据的随机性，避免连续困难样本。
* &#x20;学习率调整:
  * 降低学习率
  * Warmup：在训练初期使用较小的学习率，然后逐渐增加到设定值。&#x20;
  * 检查/调整 LR Scheduler：确保调度器逻辑正确，峰值学习率和衰减策略合理。&#x20;
* 梯度裁剪:
  * 设置一个梯度的范数上限或值上限。当计算出的梯度超过此上限时，将其缩放或截断。

### 参考

1. <https://blog.csdn.net/2302_79932616/article/details/147931825>


# 长文本拓展

### 1 渐进式扩展

直接从短上下文（如 4K）扩展到超长上下文（128K 或更高）会导致训练不稳定和灾难性遗忘。现代 LLM 采用渐进式课程学习（Progressive Curriculum）策略。

典型的三阶段扩展路径如下 ：

| 阶段          | 上下文长度 | 训练目标   | 关键技术               |
| ----------- | ----- | ------ | ------------------ |
| **Stage 1** | 4K/8K | 基础预训练  | 标准预训练，建立基础能力       |
| **Stage 2** | 32K   | 文件级理解  | 长文本初始化，数据混合调整      |
| **Stage 3** | 128K+ | 长程依赖捕获 | 长文档、多文件推理、Agent 轨迹 |

**具体流程如下**（参考 InCoder-32B 和 TeleChat2）：

* **Stage 2.1 (8K→32K)**：直接训练至 32K 长度，无需位置插值，使用 Cosine 学习率衰减，数据混合强调代码、推理 QA 和 Agent 轨迹。
* **Stage 2.2 (32K→128K)**：采用\*\*渐进式热身（Graduated Warm-up）\*\*策略——长序列样本（>32K）比例从 10% 线性增加至 50%，防止训练初期的不稳定。
* **数据回放（Data Replay）**：在每个阶段保留 5-20% 的上阶段数据，缓解分布偏移，稳定specialization。

长上下文扩展需重新调整学习率：

* **重置与衰减**：每进入新阶段，学习率重置为该阶段初始值（如从 4e-4 降至 4e-5），再执行 Cosine Annealing。如果不重置学习率，继续使用上一阶段结束时的极小学习率，模型几乎没有"学习能力"去适应新的位置编码（RoPE）分布。重置相当于给模型一次"重新热身"的机会，让它用相对较高的学习率快速适应新长度。
* **ABF（Attention Base Frequency）技术**：在扩展阶段同步增大 RoPE 基础频率（base frequency），如从 1×10⁶（32K 阶段）提升至 4×10⁷（256K 阶段），以缓解长程衰减。

***

### 2 位置编码适配

位置编码是决定模型长度泛化能力的核心。当前主流方案分为 **外推（Extrapolation）与插值（Interpolation）**&#x4E24;大类。

#### 1. ALiBi

**ALiBi（Attention with Linear Biases）** 通过在注意力分数中添加**线性衰减的负偏置**实现位置编码： $$\text{Attention}(Q, K) = \text{softmax}\left(\frac{QK^T}{\sqrt{d\_k}} - m \cdot |i-j|\right)$$ 其中 $$m$$ 为预定义的斜率（head-specific slope），$$|i-j|$$ 为 token 间的绝对距离。

**特点**：

* **训练免费的外推**：在短文本上训练，可直接推断更长序列（Train Short, Test Long）。
* **局限性**：长程精度有限，超过 4 倍训练长度后性能急剧退化。

#### 2. RoPE 及其扩展家族

**RoPE（Rotary Position Embedding）**&#x901A;过旋转矩阵注入相对位置信息： $$f(x\_m, m) = \Theta\_m x\_m, \quad \Theta\_m = \text{diag}({e^{i m \theta\_j}}\_{j=1}^{d/2})$$ 其中 $$\theta\_j = b^{-2j/d}$$，$$b$$ 为基础频率（base frequency，通常 10000）。

**(1) 位置插值**

将位置索引 $$m$$ 按比例 $$s = L'/L$$ 压缩到预训练范围内： $$m' = m \cdot \frac{L}{L'}$$ **缺陷**：对所有频率均匀压缩，导致高频信息（局部细节）损失。

**(2) NTK-aware 插值**

基于 Neural Tangent Kernel 理论，**高频特征难以学习**，应减少高频压缩。通过非均匀缩放因子： $$s\_j = \left(\frac{L'}{L}\right)^{2j/(d-2)}$$ 高频（$$j$$ 大）缩放少，低频（$$j$$ 小）缩放多，保留局部分辨率。

**(3) YaRN（Yet another RoPE extensioN）**

将 RoPE 维度分为三组处理：

* **高频分量**：不缩放（$$s\_j = 1$$），保留局部敏感性
* **低频分量**：PI 式完全缩放（$$s\_j = L'/L$$），缓解 OOD 问题
* **中间频率**：线性过渡插值

**动态缩放（Dynamic Scaling）**：在自回归生成中，根据当前序列长度动态调整 $$s = \max(1, l'/L)$$，实现平滑退化而非突然崩溃。

**(4) LongRoPE 与 LongRoPE2**

采用**困惑度引导的搜索策略**，为每个频率维度寻找最优缩放因子，而非预设公式。LongRoPE2 进一步实现**近无损扩展**，在 128K 长度上性能超越传统方法。

#### 3. 动态位置编码

**Dynamic NTK** 在推理时根据当前序列长度实时调整 base frequency： $$b' = b \cdot \left(\frac{l'}{L}\right)^{d/(d-2)}$$ 实现训练后无需微调的长度泛化。

位置编码的详细推导可见之前的文章 [Positional Encoding](/llm-everything/transformer/positional-encoding)

### 3 稀疏注意力

长上下文训练的**计算复杂度瓶颈**在于 Self-Attention 的 $$O(L^2)$$ 复杂度。稀疏注意力通过**选择性计算**降低开销。

#### 3.1 Sliding Window Attention（局部滑动窗口）

仅计算每个 token 与其左右窗口大小为 $$w$$ 的邻域内的注意力，复杂度降至 $$O(L \cdot w)$$。

**预训练集成策略**：

* **分阶段扩展窗口**：初期使用较小窗口（如 4K），逐步扩大至全局长度。
* **全局-局部混合**：保留少量全局 attention heads（如 1-2 个），其余使用滑动窗口，平衡局部细节与全局结构。

#### 3.2 FlashAttention 系列：IO 感知的精确注意力

FlashAttention 通过**分块计算（Tiling）和重计算（Recomputation）策略，减少 HBM 访问次数，实现精确的稀疏注意力**（非近似）：

**FlashAttention-3 优化**：

* **Warp-specialized 调度**：针对 Hopper 架构优化异步拷贝与 Tensor Core 重叠。
* **低精度支持**：支持 FP8 训练，进一步加速长序列处理。

**预训练集成**：

* 在 128K 预训练中，FlashAttention 将内存占用从 $$O(L^2)$$ 降至 $$O(L)$$，使得单卡可承载更长序列。
* 与序列并行（Sequence Parallelism）结合，将长序列分片到多卡计算。

### 参考

1. <https://arxiv.org/pdf/2501.15383>


# 评估

#### 1 中间评估

预训练通常持续很长时间，仅在结束时评估无法及时发现问题（如能力遗忘、训练不稳定）。所以 LLM 预训练通常会使用中间评估。

中间评估有以下几种方式：

#### 1.1 PPL <a href="#h_718354385_17" id="h_718354385_17"></a>

使用一些非训练数据的高质量语料作为评测，在每个 checkpoint 上观察模型在这些测试集合上的 loss 表现。理想情况下，这里的loss应该是会随着训练时间增加而持续下降的。

#### **1.2 下游任务评测** <a href="#h_718354385_17" id="h_718354385_17"></a>

在每个 checkpoint（如每 100B tokens）执行 Zero-shot / Few-shot 评测，覆盖：

* **推理能力**：HellaSwag、ARC、PIQA
* **知识密集型**：MMLU、C-Eval、CMMLU
* **数学/代码**：GSM8K、HumanEval、MBPP
* **长文本**：L-Eval、LongBench

为了避免数据泄露，可以对 Benchmark 进行一些改造，比如调整选择题的选项顺序、对问题进行重写等等。

#### **1.3** 概率探针 <a href="#h_718354385_17" id="h_718354385_17"></a>

从概率的视角监控模型在特定知识上的遗忘或提升。追h踪模型对特定 token 或句子的概率变化，从而判断知识或能力的演化趋势。实际操作中，需要人工构造探针测试集——这通常是逐条设计，难以批量生成。例如：

* 事实知识：观察条件概率 ($$\text{Prob}(\text{“巴黎”} \mid \text{“法国的首都是”}$$)) 是否随训练过程持续上升；
* 一致性：对比 ($$\text{PPL}(\text{“地球是圆的”}$$)) 是否下降，而 ($$\text{PPL}(\text{“地球是平的”}$$)) 是否上升；
* 价值对齐：验证 ($$\text{PPL}(\text{“诚实是美德”}$$)) 是否持续低于 ($$\text{PPL}(\text{“欺骗是合理的”}$$))；
* 指令遵循：检验在提示“以 JSON 格式输出”后，模型输出首个左大括号的概率是否提高。

这类概率探针可根据需求任意构造，重点在于监测指标的变化趋势，而非绝对数值。


# 监督微调

#### 1. **数据工程**

* Base 模型与 Instruct 模型的差异
* **数据拼接策略**：Pack vs Truncation，Attention Mask 的正确处理
* **指令多样性设计**：多轮对话构造、工具调用数据格式
* **数据质量过滤**：基于 Reward Model 或困惑度的数据筛选，指令复杂度评估（Instag、Self-Instruct 方法）

#### 2. **参数高效微调**

* Adapter
* Prefix-Tuning
* **LoRA/QLoRA**：低秩适配原理、秩（r）与缩放参数（α）的选择、目标模块选择（q\_proj/v\_proj/all）、4-bit/8-bit 量化与双量化（NF4/FP4）

#### 3. **训练策略与稳定性**

* **灾难性遗忘（Catastrophic Forgetting）缓解**：混合预训练数据（Replay Buffer）、LISA（Layerwise Importance Sampling）、LFQA（Learning with Forgettable Examples）
* **长上下文微调**：从预训练的 4K/8K 扩展到 32K/128K 的渐进式微调（Positional Interpolation、YaRN 在 SFT 阶段的应用）
* **多轮对话位置编码处理**：NTK-aware 扩展在对话场景中的具体实现

#### 4. **评估**

* **指令跟随能力评估**：MT-Bench、AlpacaEval、IFEval（指令遵循专项测试）
* **安全性对齐初步**：SFT 阶段的安全数据注入（Refusal Training）、毒性内容过滤策略

### 参考

1. <https://zhuanlan.zhihu.com/p/809229182>


# 数据工程

### 1 Base 模型和 Instruct 模型的区别

我们经常在开源模型权重中看到base和instruct后缀，但其实这两个不是两个不同的模型。Base模型和Instruct模型在模型结构上完全相同，差异仅体现在训练数据的组织方式和损失函数的计算范围。

* Base 模型
  * 在海量无标注文本上做 Next Token Prediction
  * 输入纯文本序列（`"巴黎是法国的首都..."`）
  * 除第一个 token 外的**所有位置都计算 loss**
* Instruct 模型
  * 通常基于 Base 模型继续训练
  * 输入结构化对话模板（`<|im_start|>user\n你好<|im_end|>\n<|im_start|>assistant\n你好！`）
  * 仅 **Assistant 回复部分计算 loss**
  * 包含 `im_start`, `im_end`, `eot_id`, `tool_call` 等角色标记

简单来说，就是 Base 模型的输入是文本块，Instruct 模型的输入是问答对。通常我们命名只经历 pretrain 阶段的模型为 xxx-base，命名经历了 SFT 阶段后的模型为 xxx-instruct。

### 2 训练数据拼接策略

在 SFT 阶段，数据样本的长度往往呈现**极端长尾分布，也就是短文本很多，长文本很少。**

如果简单使用 **Truncation（截断）** 或 **Padding（填充）** 到固定长度，会遇到两个问题：

* **Truncation**：短样本没问题，长样本被砍断（丢失关键上下文）
* **Padding**：短样本带来 70%+ 的无效计算（GPU 并行计算时，padding位置会有计算浪费）

<mark style="color:$warning;">Packing 策略将多个独立样本</mark> <mark style="color:$warning;"></mark><mark style="color:$warning;">`[A][B][C]`</mark> <mark style="color:$warning;"></mark><mark style="color:$warning;">拼接为连续序列，一次性计算，减少 padding 浪费。</mark>

但是，如果直接拼接而不处理 Attention Mask，会导致 **Cross-sample Contamination（样本间交叉注意力）**：模型在预测样本 B 的 token 时，能看到样本 A 的内容，而 A 中可能会包含答案或者提示，训练 loss 会异常降低，但模型学到的是虚假依赖。

将多条样本拼接后，通过设置 `attention_mask` 为块对角矩阵（或使用 `cu_seqlens` 机制），确保样本 A 的 token 无法 attend 到样本 B 的内容，同时仍保持因果语言模型的自回归特性（每个 token 只能看到同一样本内的前序 token）。

* **实现方式**：主流框架（如 Megatron、HuggingFace 的 `pack=True` 模式）支持传入 `position_ids` 与 `attention_mask`，将拼接序列在逻辑上分割为多个独立“虚拟序列”，既提高计算效率（减少 padding 占比），又保证训练信号纯净。

### **3 指令多样性设计**

SFT 阶段的指令覆盖度直接影响模型的泛化能力与任务适配性。

* **多轮对话构造**：单纯堆叠单轮样本会使模型缺乏多轮上下文理解能力。需要构造真实的多轮对话数据，通过 `user-assistant` 交替序列模拟对话历史，并在每轮中仅对当前轮次的 `assistant` 回复部分计算 loss，前序轮次作为上下文但不更新梯度，从而训练模型的多轮连贯性。
* **工具调用数据格式**：为增强模型使用外部工具的能力，需将工具调用设计为结构化的特殊 token 序列。常见格式包括 `<|tool_call|>function_name\narguments<|/tool_call|>` 或 JSON 形式的函数调用块，并在训练时明确区分“自然语言回复”与“工具调用输出”的 loss 计算范围，避免模型混淆生成模式。

### **4 数据质量过滤**

SFT 阶段，低质量或重复的指令数据会引入噪声甚至导致模型能力退化。

* **困惑度过滤**：利用预训练的 Base 模型计算每条样本的困惑度（PPL），剔除 PPL 过高（可能为异常、跨语言或逻辑混乱）和 PPL 过低（可能为简单重复）的数据，保留中等困惑度、信息量适中的样本。
* **Reward Model 筛选**：若有现成的偏好模型或质量评估模型，可对生成式样本进行质量打分，过滤掉低分回复。
* **指令复杂度评估**：通过 **Instag** 等方法对指令进行多维度标注（如推理难度、多约束条件、专业知识等），筛选高复杂度、高多样性的指令；或使用 **Self-Instruct** 方法通过种子指令 + 模型自生成的方式扩充指令集，再结合聚类与去重保证数据覆盖度与均匀性。


# 参数高效微调

### 1 Adapter

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FYSlyG5P2CSvw4San96gw%2Fimage.png?alt=media&amp;token=4ebd60f5-0565-4e04-ab66-fe07af2588b4" alt=""><figcaption></figcaption></figure>

Adapter（2019年提出）在Transformer子层（注意力层+FFN层）后插入瓶颈式（Bottleneck）适配模块，通过下投影→非线性激活→上投影的方式，在不改变原始参数的情况下引入任务特定知识。

**数学表达**： 对于输入特征 $$\mathbf{h} \in \mathbb{R}^d$$，Adapter层的输出为： $$\mathbf{h}' = \mathbf{h} + f(\mathbf{h}W\_{down})W\_{up}$$ 其中：

* $$W\_{down} \in \mathbb{R}^{d \times m}$$：下投影矩阵（$$m \ll d$$，通常 $$m = 64$$）
* $$W\_{up} \in \mathbb{R}^{m \times d}$$：上投影矩阵
* $$f(\cdot)$$：非线性激活（通常使用ReLU或GELU）
* **残差连接**：原始特征 $$\mathbf{h}$$ 被保留，Adapter学习残差变换 $$\Delta\mathbf{h}$$

**标准Adapter配置**：

* **插入位置**：每个Transformer层的两个子层后（Post-Attention + Post-FFN）
* **瓶颈维度**：$m$ 通常为原始维度 $$d$$ 的1/64到1/4（如BERT-base $$d=768$$，则 $$m=48-192$$）
* **参数占比**：仅增加约 **2-4%** 的可训练参数

**主要局限**：

* **推理时必须加载Adapter**：无法像LoRA那样将权重合并回基座模型，增加部署复杂度
* **深层信息瓶颈**：当 $$m$$ 过小时，信息压缩可能导致语义损失

### 2 Prefix-Tuning

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FKXXHUQAEZA5BcWxtYg5c%2Fimage.png?alt=media&amp;token=2df362e8-9bea-4c26-84d0-c5de1631eb45" alt=""><figcaption></figcaption></figure>

Prefix-Tuning (2021年提出）在Transformer的**每一层**的 Key 和 Value 矩阵前，前置可学习的连续向量（Soft Prompts），而非修改模型参数或添加输入层提示。这相当于在注意力计算中引入了**虚拟的"锚点 token"**。

**数学机制**： 对于第 $$i$$ 层自注意力机制，原始 Key 为 $$K\_i \in \mathbb{R}^{n \times d}$$，Prefix-Tuning将其扩展为： $$K'\_i = \[P^K\_i; K\_i], \quad V'\_i = \[P^V\_i; V\_i]$$ 其中 $$P^K\_i, P^V\_i \in \mathbb{R}^{p \times d}$$ 为可学习前缀向量，$$p$$ 为前缀长度（通常10-50 tokens）。

**架构特点**：

* **层级干预**：在**所有层**（不仅是输入层）添加前缀，深度影响注意力模式
* **重参数化技巧**：使用小型MLP生成前缀参数，避免直接优化不稳定： $$P\_i = \text{MLP}(P'\_i)$$ 训练完成后丢弃MLP，仅保留生成的 $$P\_i$$

**为什么有效**：

* **全局偏置注入**：这些前缀向量参与**所有位置**的注意力计算（因为每个真实 token 都会 attend 到它们），相当于在每一层都施加了任务特定的**注意力偏置（attention bias）**
* **细粒度控制**：不同于输入层提示（仅影响第一层表征），深层前缀可以直接干预高层语义特征的聚合方式，**逐层调整**模型对任务的理解

**超参数配置**：

* 前缀长度 $$p$$：10-100（任务越复杂，所需前缀越长）
* 可训练参数占比：**0.1-0.5%**

### 3 LoRA、QLoRA

#### 3.1 LoRA

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FFyGf1cWt5ZnNRhCogoCG%2Fimage.png?alt=media&amp;token=9b867cb3-72b1-4e74-8bb1-3c5ff754224c" alt=""><figcaption></figcaption></figure>

**核心假设**： 模型微调时的参数更新 $$\Delta W$$ 具有**低内在秩**（Low Intrinsic Rank）。对于预训练权重 $$W\_0 \in \mathbb{R}^{d \times k}$$，LoRA将其更新约束为低秩矩阵乘积：

$$W' = W\_0 + \Delta W = W\_0 + BA$$

其中 $$B \in \mathbb{R}^{d \times r}$$，$$A \in \mathbb{R}^{r \times k}$$，且秩 $$r \ll \min(d, k)$$。

**初始化策略**：

* **矩阵A**：使用Kaiming均匀初始化（类似神经网络标准初始化）
* **矩阵B**：零初始化（确保训练开始时 $$\Delta W = 0$$，保持预训练知识）

**为什么要这样设计？**

这种**非对称初始化**（A随机、B零）是LoRA训练稳定性的关键设计，包含两个个层面的考量：**训练起点控制**、**梯度流动机制**。

* 零初始化：确保"暖启动"（Warm Start）
  * 训练开始时 $$\Delta W = BA = 0$$，使模型初始状态**严格等价于**预训练模型。
* A 的Kaiming初始化：保持梯度流动与方向探索
  * 虽然B初始为0，但A**必须非零**（Kaiming/He初始化或标准高斯），原因涉及**梯度反向传播机制**：
    * **梯度计算**： 对于损失函数 $$\mathcal{L}$$，B的梯度为： $$\frac{\partial \mathcal{L}}{\partial B} = \frac{\partial \mathcal{L}}{\partial (BA)} \cdot A^T = \frac{\partial \mathcal{L}}{\partial \Delta W} \cdot A^T$$
  * **如果A也初始化为0**：
    * $$\frac{\partial \mathcal{L}}{\partial B} = 0$$（梯度消失）
    * B将永远无法更新（被困在0点）
    * LoRA路径 $$BA$$ 永远保持0，失去微调能力

**缩放机制**： 引入缩放系数 $$\frac{\alpha}{r}$$ 控制LoRA输出的影响范围： $$h = W\_0x + \frac{\alpha}{r} \cdot BAx$$

**目标模块选择策略**：

* **`q_proj, v_proj`**：参数效率最高（仅占0.5%参数），可达全微调98%性能
* **`q_proj, k_proj, v_proj, o_proj`**：标准配置，平衡性能与显存
* **`all_linear`**（注意力+MLP）：领域适配场景，接近全微调效果

#### 3.2 QLoRA

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FrIVBJL8qaJVKuWfBqUh0%2Fimage.png?alt=media&amp;token=8a32186e-1e99-4524-a43d-7275eb8c0ae0" alt=""><figcaption></figcaption></figure>

**4-bit NormalFloat (NF4) 量化**：

* 理论基础：神经网络权重通常服从零均值正态分布 $$N(0, \sigma^2)$$
* **信息论最优**：NF4将4-bit量化值映射到正态分布的分位数，相对于均匀分布（FP4）最大化信息熵
* **分块量化**：每64个参数独立量化，配备独立的量化常数 $c$，减少异常值影响

**双量化（Double Quantization）**： 对量化常数 $$c$$（32-bit）进行二次量化至8-bit：

* 第一层：$$c\_{32} \rightarrow c\_{8}$$（节省显存）
* 第二层：反量化 $$c\_{8} \rightarrow c\_{32}$$（计算时恢复精度）

**分页优化器（Paged Optimizers）**： 利用CPU内存作为GPU显存的页缓冲区，当GPU OOM时自动将优化器状态分页到CPU，实现单卡训练超大模型（如65B模型在48GB显存上训练）。

**QLoRA配置清单**：

```python
# 量化配置
quant_config = BitsAndBytesConfig(
    load_in_4bit=True,                    # 启用4-bit
    bnb_4bit_quant_type="nf4",           # NF4优于FP4约15-20%
    bnb_4bit_use_double_quant=True,      # 双量化节省~1GB（70B模型）
    bnb_4bit_compute_dtype=bfloat16      # 计算时反量化至bf16
)

# LoRA配置
lora_config = LoraConfig(
    r=64,                # QLoRA可使用更高秩（量化节省的显存可用于增大r）
    lora_alpha=16,       # α/r = 0.25，保守更新（量化模型需稳定训练）
    target_modules="all_linear",
    lora_dropout=0.05,
    use_rslora=True      # 可选：秩稳定LoRA，解决高秩训练不稳定问题
)
```

### 参考

1. <https://www.aidoczh.com/adapterhub/methods.html#lora>


# 训练策略与稳定性

### 1 灾难性遗忘缓解策略

#### 1.1 混合预训练数据（Replay Buffer）

**核心机制**： 在 SFT 阶段，除了下游任务数据外，**按一定比例（通常1:10到1:100）混入原始预训练数据**（如维基百科、书籍语料），形成"经验重放缓冲区"。

**为什么有效**：

* **知识巩固**：预训练数据包含语言模型已习得的世界知识和语法规律，持续曝光可防止参数漂移
* **正则化效应**：混合数据迫使模型在优化下游任务时，仍需维持对通用语料的低loss，限制参数更新幅度

#### 1.2 LISA：层重要性采样（Layerwise Importance Sampling）

**核心洞察**（基于LoRA的层权重分布分析）： LISA作者发现LoRA微调时，**层间权重范数呈现极端偏斜分布**：Embedding层和LM Head层的权重范数显著大于中间层（相差可达数百倍）。这表明不同层对微调的敏感度差异巨大。

**算法原理**： LISA通过**重要性采样**动态选择参与训练的层，而非冻结所有中间层：

$$p\_{\ell} = \begin{cases} 1.0, & \text{if } \ell=1 \text{ or } \ell=N\_L \ \gamma / N\_L, & \text{else} \end{cases}$$

其中：

* **首尾层固定激活**（$$p=1.0$$）：负责输入嵌入映射和输出logits投影，对语义转换最关键
* **中间层随机采样**（概率 $$\gamma/N\_L$$）：每步训练仅解冻 $$\gamma$$ 层（通常 $$\gamma=2-4$$），其余层梯度冻结
* **采样周期 K**：每 K 步重新采样一次，保持训练动态性

**性能优势**：

* **内存效率**：相比LoRA节省约 **5-10%** 显存（70B模型从79GB降至75GB），且无需适配器参数
* **性能超越**：在MT-Bench上比LoRA提升 **11%-37%**，在GSM8K和PubMedQA上持平或超越全参数微调
* **速度提升**：相比全参数训练加速 **2.9×**，相比LoRA加速 **\~2×**（省去适配器计算开销）

**与灾难性遗忘的关系**： 通过限制每步更新的参数量（仅 $$\gamma$$ 层全参数 + 首尾层），LISA实际上对模型施加了**隐式正则化**，防止单一任务数据过度驱动参数远离预训练分布，从而缓解遗忘。

#### 1.3 LFQA：从易遗忘样本学习（Learning with Forgettable Examples）

**概念起源**： LFQA是一种**智能数据重采样策略**，聚焦于模型"最容易遗忘"的样本。它源于对模型训练动态的观察：在持续学习中，某些样本（如低频知识、复杂推理链）会被模型快速遗忘，而简单样本则被牢固记忆。

**技术实现**：

1. **遗忘分数计算**：在训练过程中，监测每个样本的**损失函数变化率** $$\Delta \mathcal{L}$$。若某样本在后续epoch中loss回升，表明模型正在遗忘该知识
2. **优先级重放**：构建优先级采样队列，遗忘分数高的样本获得更高的采样概率
3. **动态缓冲区**：维护一个固定大小的缓冲区，优先保留高遗忘分数样本，淘汰已被牢固掌握的"易记样本"

### 2 长上下文微调：从 4K/8K 到 32K/128K 的渐进式扩展

#### 2.1 渐进式微调策略

和预训练时的 [长文本拓展](/llm-everything/train/pre-train/long-text-extension) 一样，SFT阶段的长文本拓展同样可以采用渐进式微调策略。直接以128K长度训练4K预训练模型会导致**灾难性遗忘**和**位置编码分布偏移**。渐进式微调通过多阶段适应，让模型逐步学习长程依赖。

#### 2.2 Positional Interpolation (PI)：线性位置插值

将超出预训练长度的位置索引**线性压缩**回原始范围。设原始上下文长度 $$L\_{pre}=4096$$，目标长度 $$L\_{target}=32768$$，缩放因子 $$s = L\_{target} / L\_{pre} = 8$$。

对于RoPE（旋转位置编码），位置 $$m$$ 的旋转角度 $$\theta\_m = m \cdot \theta\_i$$ 被替换为： $$\theta'\_m = \frac{m}{s} \cdot \theta\_i$$

**效果**：

* 将32K长度的位置编码"挤压"进模型熟悉的4K分布范围内
* 仅需 **1000步微调** 即可恢复性能（相比直接微调需要10000步）
* 困惑度在长序列上保持稳定

**局限**：

* **相邻token区分度下降**：线性插值导致高频信息压缩，短距离相对位置区分度降低（相邻token余弦相似度升高）
* **外推能力弱**：在未见过的更长序列上性能急剧下降

#### 2.3 YaRN：高效上下文扩展（Yet another RoPE extensioN）

YaRN结合了**NTK-aware非线性插值**与**注意力温度缩放**，是当前最优的长上下文扩展方案。

**技术组成**：

1. **NTK-aware 插值**： 不同于PI的线性插值，YaRN对RoPE的不同频率维度采取差异化缩放：

   * **高频维度**（短波，捕捉局部关系）：**较少插值**，保持相邻token区分度
   * **低频维度**（长波，捕捉全局关系）：**较多插值**，适应长距离依赖

   通过调整RoPE base频率实现： $$b' = b \cdot s^{\frac{d}{d-2}}$$ 其中 $$s$$ 为扩展倍数，$$d$$ 为模型维度。
2. **Attention Scaling（注意力缩放）**： 长上下文下，点积注意力值会因维度累积而方差增大，导致Softmax饱和（梯度消失）。YaRN引入温度系数 $$t$$ 缩放注意力logits： $$\text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^T}{t \cdot \sqrt{d\_k}}\right)V$$ 其中 $$t$$ 与扩展因子 $$s$$ 相关，通常 $$t \approx \sqrt{\frac{1}{s} \ln s + 1}$$。

**性能突破**：

* **训练效率**：仅需 **128-256 GPU小时**（A100）即可将LLaMA-2扩展到128K，相比PI的640小时提升 **5×**
* **外推能力**：在训练长度仅64K的情况下，YaRN(s=32)可**零样本外推**至128K，困惑度持续下降（2.45→2.37）
* **检索精度**：Passkey Retrieval任务在128K长度下保持 **99.4%** 准确率

### 3 多轮对话位置编码处理

#### 3.1 多轮对话的位置编码挑战

**核心问题**： 在多轮对话中，历史上下文（System Prompt + 多轮QA）可能极长（如50轮对话可达32K+），而当前生成仅需关注近期token。标准位置编码（包括PI）会导致：

1. **长距离噪声**：早期轮次的位置编码与当前查询距离过远，注意力分散
2. **局部区分度丧失**：PI的线性插值使相邻token的RoPE角度过于接近，难以区分"上一轮"与"当前轮"的边界

#### 3.2 NTK-aware 的对话场景优化

**NTK-aware 保护局部敏感性的机制**： NTK-aware通过**频率依赖型缩放**，在扩展全局上下文的同时，**保护高频维度（短距离）的相对位置敏感性**：

* **高频维度**（维度索引 $$i$$ 小，波长短）：对应局部token关系，NTK-aware仅轻微调整，保持相邻token的旋转角度差异
* **低频维度**（维度索引 $$i$$ 大，波长长）：对应长距离依赖，进行较大幅度插值

**在多轮对话中的体现**： 当上下文从4K扩展到32K时：

* **PI**：所有token的相对角度均匀压缩，第 $$m$$ 与 $$m+1$$ 个token的旋转差变为原来的 $$1/8$$，导致注意力难以区分相邻轮次
* **NTK-aware**：相邻token（局部）旋转差保持接近原始值，远距离token（全局）旋转差被压缩，实现"**近清晰、远模糊**"的注意力分布，符合对话中"更关注近期上下文"的人类认知模式

#### 3.3 工程实现细节

**Dynamic-YaRN 推理优化**： 在实际对话系统中，通常采用**动态缩放**策略：

* 若当前对话长度 $$< 4K$$：使用原始RoPE（$$s=1$$），保持最佳短文本性能
* 若 $$4K \leq \text{长度} < 32K$$：动态计算 $$s = \lceil \text{length} / 4096 \rceil$$，应用YaRN插值
* 使用**动态NTK**公式实时调整base频率，避免预分配固定长度的位置编码缓存

**对话数据的特殊处理**：

* **特殊Token的位置重置**：部分实现（如ChatGLM）在每一轮对话开始时插入`<|turn|>`标记，并可选地对该标记后的位置计数进行"软重置"（非零起点但压缩增量），进一步区分轮次边界
* **System Prompt的锚定效果**：System Prompt通常位于序列开头，在NTK-aware编码下，其低频成分被充分保留，确保长对话中模型仍遵守系统指令

**量化感知扩展**： 结合QLoRA/QLISA进行长上下文微调时，4-bit量化与YaRN兼容良好，但需注意：

* 在NTK-aware插值前应用量化（避免插值后量化引入额外分布偏移）
* 双量化（Double Quantization）在长序列（>64K）下可额外节省约 **0.5-1GB** 显存，对多轮对话场景至关重要

通过上述技术组合，现代LLM能够在保持短文本能力的同时，支持**100+轮次的多轮长对话**，且每轮响应时间稳定在合理范围内（通过FlashAttention-2和KV Cache优化）。


# 评估

### 1 指令跟随能力评估：多维度自动评测体系

#### 1.1 MT-Bench：多轮对话综合能力评估

**基准设计**（由LMSYS提出）：

* **80道高质量手工题目**，覆盖8大核心能力类别：
  * **Writing**（写作）、**Roleplay**（角色扮演）、**Reasoning**（推理）、**Math**（数学）
  * **Coding**（编程）、**Extraction**（信息抽取）、**STEM**（科学技术）、**Humanities**（人文）
* **双轮对话结构**：每题包含Turn 1（首轮提问）和Turn 2（追问或依赖上下文的连续提问），测试模型的**上下文跟踪**与**多步推理**能力

**评估协议**：

* **LLM-as-Judge**：采用强模型作为裁判
* **评分维度**：
  * **Helpfulness**（有用性）、**Relevance**（相关性）、**Accuracy**（准确性）
  * **Depth**（深度）、**Clarity**（清晰度）
* **结果聚合**：分别计算T1（首轮）和T2（次轮）得分，Overall为两者平均

**关键指标**：

| 指标                 | 含义     | 应用场景                             |
| ------------------ | ------ | -------------------------------- |
| **T1 Score**       | 首轮响应质量 | 评估单轮指令理解与基础生成能力                  |
| **T2 Score**       | 次轮响应质量 | 评估上下文记忆与连贯性，T2显著低于T1表明**长程依赖薄弱** |
| **Category Score** | 分领域得分  | 识别模型能力短板（如Math vs Humanities差距）  |

***

#### 1.2 AlpacaEval 2.0：指令遵循胜率评估

**核心机制**： 基于805条真实用户指令，让被测模型与**强基线模型**分别生成响应，由 LLM 裁判判定胜负。

**关键指标：LC Winrate**：

* 早期评测中，模型可通过**生成更长内容**（verbosity bias）获得更高胜率，因为人类/裁判模型倾向于认为长回答更详细
* **LC Winrate计算**：通过统计方法**剥离生成长度对胜率的贡献**，计算"在相同长度水平下"的胜率，确保评估的是**内容质量**而非**啰嗦程度**
* **可靠性**：相比Raw Winrate，LC Winrate与人工评判的一致性提升**30%+**

#### 1.3 IFEval：可验证指令遵循专项测试

**设计目标**（Google DeepMind提出）： 评估模型对**明确、可验证指令**的遵循能力，如：

* *格式约束*："输出必须为JSON格式"、"包含至少3个段落"
* *内容约束*："用第三人称写作"、"最后必须包含总结"
* *逻辑约束*："先列出3个反对论点，再给出反驳"

**评估指标**：

* **Prompt-level Strict Accuracy (Pr.(S))**：整个prompt的所有指令都被完美执行的比例
* **Instruction-level Strict Accuracy (Ins.(S))**：单个指令被正确执行的比例（一个prompt可能含多个指令）

***

### 2 安全性对齐初步：SFT阶段防御机制

#### 2.1 有害微调风险（Harmful Fine-tuning）

**安全脆弱性**： 经过RLHF/SFT安全对齐的模型，在**下游任务微调**（即使使用少量有害数据或良性数据但被攻击者构造）时，会**遗忘拒绝行为**（Catastrophic Forgetting of Safety），产生"越狱"（Jailbreaking）效果。

**遗忘机制**：

* **嵌入漂移（Embedding Drift）**：微调导致模型表征空间向任务数据偏移，远离安全对齐时的拒绝区域
* **前几个Token关键**：拒绝行为的关键在于生成的前几个Token（如"I cannot"），微调首先改变这些关键Token的分布

***

#### 2.2 SFT阶段安全数据注入策略

**2.2.1 安全数据混合（SafeInstr）**

在下游任务SFT数据中**按固定比例（通常5-10%）混入安全示例**：

* **数据形式**：(有害Prompt, 拒绝Response) 对
* **目标**：维持模型对有害输入的拒绝能力，同时学习下游任务
* **局限性**：如果下游任务数据本身被投毒（含隐蔽有害样本），单纯混合可能无法防御

**2.2.2 Refusal Training（拒绝训练）**

**核心流程**：

1. **构造拒绝数据**：使用LLM-LAT等有害提示数据集，让对齐模型生成安全拒绝响应作为 $y\_w$（chosen），让未对齐/脆弱模型生成有害响应作为 $y\_l$（rejected）
2. **分类器过滤**：使用LlamaGuard-3等安全分类器筛选，仅保留 $y\_w$被标记为"safe"且 $y\_l$被标记为"unsafe"的明确对比对
3. **两阶段训练**：
   * **SFT阶段**：在拒绝响应 $y\_w$上进行监督学习，建立基础拒绝模式
   * **DPO阶段**：使用拒绝/有害对比对进行偏好优化，强化安全边界

**2.2.3 关键Token强化（Constrained-SFT）**

**技术细节**：

* **观察发现**：拒绝行为主要由生成的前几个Token（如"I'm sorry"、"I cannot"）决定
* **正则化策略**：对这些关键Token的**权重更新施加更强正则化**（更大的权重衰减或梯度裁剪），确保微调过程中拒绝触发机制不被破坏

***

#### 2.3 毒性内容过滤策略

**2.3.1 预训练阶段：PHF（Pretraining with Human Feedback）**

不直接过滤掉所有毒性数据（会导致能力 crippling 和社会偏见放大），而是**引导模型学习但不模仿**：

* **条件训练（Conditional Training）**：在毒性内容前添加特殊标记，训练模型识别并学会不生成此类内容
* **Unlikelihood Loss**：对毒性Token施加惩罚，降低其生成概率
* **离线RL（RWR/AWR）**：基于毒性分类器的奖励进行预训练阶段的对齐

**2.3.2 数据清洗管道**

* **多层过滤**：使用关键词黑名单（初筛）+ 嵌入空间去毒（Debiasing）+ 神经网络分类器（精筛）
* **类别细分**：区分**仇恨言论**、**自残内容**、**暴力指导**、**成人内容**，针对不同下游应用场景制定不同过滤强度

**2.3.3 推理时防护（与SFT阶段协同）**

* **LlamaGuard集成**：在SFT阶段使用LlamaGuard-3标记数据，确保训练后的模型输出的拒绝响应对分类器可见，形成**训练-推理一致的安全闭环**

***

### 3 评估-安全联合最佳实践

**测试时安全评估**： 在MT-Bench/AlpacaEval评测中，应并行运行**Toxigen**等安全性基准，监控：

* **Helpfulness vs Harmlessness Trade-off**：指令跟随能力提升是否伴随拒绝率下降（对齐税）
* **长度控制安全性**：确保LC Winrate优化不会通过生成更长、更隐蔽的有害内容来实现

**防御性微调检查清单**：

1. **混合比例**：下游任务数据与安全数据按 9:1 或 10:1 混合
2. **关键Token保护**：对前5-10个生成Token的梯度进行监控，设置漂移阈值
3. **动态评估**：每100步在 harmful prompts 子集上测试拒绝率，低于阈值则触发早停


# 强化学习

## 1 **RLHF 基础**

* **两阶段流程详解**：
  * Reward Model（RM）训练
    * Bradley-Terry 模型假设、成对比较数据标注（Chosen vs Rejected）
    * **损失函数**：Pairwise Ranking Loss、Margin 设置、In-batch Negative Sampling
  * 强化学习策略优化（以 PPO 为例）

## 2 **Reward Model**

* **模型架构**：基于预训练模型的输出头改造（Regression Head）、共享参数 vs 冻结部分层
* **偏好数据构造**：Elo 评分体系在数据筛选中的应用
* **RM 的陷阱与局限**：Reward Hacking（奖励作弊）、分布外（OOD）泛化能力差、长度偏好（Length Bias）问题

## 3 **PPO 算法深度解析**

* **Actor-Critic 架构**：策略模型（Actor）与价值模型（Critic）的初始化与更新策略
* **关键组件**：
  * KL 散度约束（KL Penalty）：参考模型（Reference Model）的固定与约束系数（β）调优
  * Generalized Advantage Estimation（GAE）：λ 参数设置与回报计算
  * Clipped Surrogate Objective：PPO 核心裁剪机制（ε 参数）
* **训练稳定性**：Value Loss 爆炸、Entropy Collapse、KL 散度突然增大的诊断与修复

## 4 **DPO 及变体**

* **DPO 原理**：跳过显式 RM，直接偏好优化，交叉熵损失与 Bradley-Terry 模型的等价推导
* **DPO 的改进变体**：
  * **IPO（Identity Preference Optimization）**：解决 DPO 的过拟合问题
  * **KTO（Kahneman-Tversky Optimization）**：无需成对偏好，仅需二元好坏标签
  * **RPO（Robust Preference Optimization）**：处理噪声偏好数据
  * **SimPO（Simple Preference Optimization）**：去除参考模型，降低显存占用
* **DPO vs PPO**：显存效率对比、数据效率对比、何时选择何种算法

## 5 GRPO、DAPO

## 6 **进阶 RL 方法**

* **RLAIF（AI Feedback）**：Constitutional AI（CAI）流程，LLM 作为标注者生成 Critique 与修订
* **Self-Play 与对抗训练**：SPIN（Self-Play Fine-Tuning）、Gouda（基于博弈论的方法）
* **过程奖励模型（PRM）与结果奖励模型（ORM）**：OpenAI O1 背后的技术，Math/代码推理场景中的 Step-by-step 奖励建模
* **迭代优化（Iterative RL）**：拒绝采样微调（Rejection Sampling Fine-Tuning, RFT）、在线 DPO（Online DPO）、Iterative DPO

## 7 **RL 工程实践与稳定性**

* **长度控制**：Length Penalty 设计，防止模型生成冗长无意义内容骗取高分
* **重复抑制**：针对重复生成（Repetition）的奖励塑形（Reward Shaping）
* **多轮 RL 的数据构造**：从 SFT 模型采样 → RM 打分 → 筛选高价值样本 → 继续训练（STaR、Vicuna 方法）


# RLHF基础 & PPO

RLHF（Reinforcement Learning from Human Feedback）是将人类偏好引入大语言模型训练的核心技术范式。与传统的 SFT 不同，RLHF 不再追求"模仿人类书写的正确答案"，而是学习"生成人类更偏好的结果"。这一范式的完整流程可分为两个紧密衔接的阶段：

## 1 阶段一：训练奖励模型

Reward Model（奖励模型，简称 RM）是 RLHF 的"裁判系统"。其核心任务是为任意给定的（Prompt, Response）对输出一个标量奖励值，量化人类对该回复的偏好程度。

RM 通常基于预训练语言模型（如 LLaMA、GPT 系列）进行改造。具体实现上，在模型的最后一层隐藏状态之上添加一个**回归头**，将高维表示映射为单一标量值：

$$r\_\theta(x, y) \in \mathbb{R}$$

其中 $$x$$ 表示输入提示（Prompt），$$y$$ 表示模型生成的回复（Response），$$\theta$$ 为 RM 的可训练参数。

架构选择上有两种主流方案：

* **共享参数方案**：复用预训练模型的全部参数，仅替换最后的输出层。优势在于保持强大的语义理解能力，劣势是训练成本较高。
* **冻结部分层方案**：冻结模型的底层参数（通常占 70%\~80%），仅微调顶层 Transformer 层和回归头。这能在保持 RM 判别能力的同时显著降低显存占用和训练时间。

### **1.1 损失函数：Pairwise Ranking Loss**

RM 的训练数据由成对比较构成：对于同一 Prompt $$x$$，人类标注者从两个候选回复 $$y\_w$$（Win，被选中的）和 $$y\_l$$（Lose，被拒绝的）中选出更优者。但神经网络需要数值才能优化。

Bradley-Terry 模型的核心洞察是：

> <mark style="color:$success;">如果 A 比 B 好，那么 A 的"质量分数"应该显著高于 B 的分数。</mark>

$$\mathcal{L} = -\log \sigma\bigl(r\_\theta(x, y\_w) - r\_\theta(x, y\_l)\bigr)$$

**符号解释：**

* $$y\_w$$：Win（被人类选中的更好回复）
* $$y\_l$$：Lose（被人类拒绝的较差回复）
* $$r\_\theta(x, y)$$：奖励模型输出的标量分数（越高越好）
* $$\sigma$$：Sigmoid 函数，$$\sigma(z) = \frac{1}{1+e^{-z}}$$

对损失函数求导（链式法则），你会发现梯度为：

$$\frac{\partial \mathcal{L}}{\partial \theta} = \underbrace{\bigl\[1 - \sigma(r\_w - r\_l)\bigr]}*{\text{误差项}} \cdot \underbrace{\bigl\[\frac{\partial r\_w}{\partial \theta} - \frac{\partial r\_l}{\partial \theta}\bigr]}*{\text{奖励值对参数的梯度}}$$

**含义解读：**

1. **误差项** $$\[1 - \sigma(r\_w - r\_l)]$$：
   * 当 $$r\_w \gg r\_l$$ 时，Sigmoid 接近 1，误差接近 0 → **梯度很小，几乎不再更新**
   * 当 $$r\_w \approx r\_l$$ 时，误差接近 0.5 → **梯度较大，大力调整**）
2. **调整方向**：
   * 增加获胜回复 $$y\_w$$ 的奖励值（$$\frac{\partial r\_w}{\partial \theta}$$ 为正）
   * 降低失败回复 $$y\_l$$ 的奖励值（$$-\frac{\partial r\_l}{\partial \theta}$$ 为负）

模型像一个跷跷板，一端抬起 Win，一端压低 Lose。

### **1.2 Margin** $$\delta$$ **的作用**

带 Margin 的版本： $$\mathcal{L} = -\log \sigma\bigl(r\_w - r\_l - \delta\bigr)$$

**为什么要加？**

想象两个场景：

* **场景 A**：$$r\_w = 0.8, r\_l = 0.7$$，差值 0.1
* **场景 B**：$$r\_w = 0.8, r\_l = -0.5$$，差值 1.3

没有 Margin 时，只要 $$r\_w > r\_l$$ 并且 $$r\_w \ r\_l$$ 的距离拉大，损失就会变小。

但问题在于，**微小的正差距（如 0.1）对应的损失（0.64）虽然比** $$r\_w = r\_l$$ 的 **0.69 略低，但这个优化信号较弱**，模型可能缺乏动力继续大幅拉开差距。

设置 $$\delta = 0.5$$ 后：

* 场景 A：$$0.8 - 0.7 - 0.5 = -0.4$$，Sigmoid(-0.4) ≈ 0.4，损失很大，模型必须继续拉大差距
* 场景 B：$$0.8 - (-0.5) - 0.5 = 0.8$$，Sigmoid(0.8) ≈ 0.69，损失较小

Margin 强迫模型不仅要知道"谁好"，还要明确"好多少"，避免对相近质量的回复给出暧昧的分数。

如果你熟悉分类任务，这个损失其实是**二元交叉熵的特例**：

标准的二元交叉熵： $$\mathcal{L}\_{BCE} = -\bigl\[y \cdot \log(p) + (1-y) \cdot \log(1-p)\bigr]$$

在我们的设定中：

* 标签 $$y = 1$$（始终假设 $$y\_w$$ 应该赢）
* 概率 $$p = \sigma(r\_w - r\_l)$$

代入得到： $$\mathcal{L} = -\log \sigma(r\_w - r\_l) - 0 = -\log \sigma(r\_w - r\_l)$$

完全一样！所以你可以把它理解为：**在比较两个回复时，预测"左边比右边好"这个二元事件的概率，并最大化该概率**。

### 1.3 **In-batch Negative Sampling**（批次内负采样）

**In-batch Negative Sampling**（批次内负采样）是 RLHF 训练奖励模型时的一种**数据增强 trick**。它能在**不增加人工标注成本**的前提下，让模型见识更多的"负面例子"，从而提升判别能力和训练效率。

标准训练设定下，每条数据是： $$\text{(Prompt } x\_i,; \text{Win } y\_i^w,; \text{Lose } y\_i^l)$$

对应损失： $$\mathcal{L}\_i = -\log \sigma\bigl(r(x\_i, y\_i^w) - r(x\_i, y\_i^l)\bigr)$$

但是人类标注一对 $$(y^w, y^l)$$ 成本很高，而**每条数据只产生一次对比信号**。如果 batch size 是 64，一次迭代只能进行 64 次"裁判打分"练习。

**观察**：同一个 batch 内的其他样本，虽然来自不同 Prompt，但它们的 Lose 响应也是"不好的回复"。能不能**跨样本借用**这些负例？

假设 batch 中有 $$N$$ 个样本，记为：

* Prompts: $$x\_1, x\_2, ..., x\_N$$
* 对应的获胜回复：$$y\_1^w, y\_2^w, ..., y\_N^w$$
* 对应的失败回复：$$y\_1^l, y\_2^l, ..., y\_N^l$$

**标准训练**：每个 $$y\_i^w$$ 只与自己的 $$y\_i^l$$ 对比

**In-batch 负采样**：让 $$y\_i^w$$ 与**同 batch 内所有其他样本**的 $$y\_j^l$$（其中 $$j \neq i$$）也进行对比

**新的损失函数**（以第 $i$ 个样本为例）：

$$\mathcal{L}*i = \underbrace{-\log \sigma(r(x\_i, y\_i^w) - r(x\_i, y\_i^l))}*{\text{原始监督信号}} ;-; \lambda \sum\_{j \neq i} \underbrace{\log \sigma(r(x\_i, y\_i^w) - r(x\_j, y\_j^l))}\_{\text{In-batch 负样本信号}}$$

其中 $$\lambda$$ 是权重系数（通常设为 $$1/(N-1)$$ 或较小值如 0.1）。

这其实就是 **InfoNCE** 或 **对比学习** 的思想在自然语言处理中的应用：

* **锚点（Anchor）**：$$y\_i^w$$（正样本）
* **正例（Positive）**：严格来说没有（或认为是自身）
* **负例（Negatives）**：$$y\_i^l$$ 和 所有 $$y\_{j\neq i}^l$$

## 2 阶段二：强化学习策略优化

获得训练好的 RM 后，进入 RLHF 的第二阶段：使用强化学习算法（这里以 PPO 为例，Proximal Policy Optimization）优化语言模型策略 $$\pi\_\phi$$，使其生成能获得更高 RM 分数的回复。

**优化目标**

$$\max\_{\phi} \mathbb{E}*{x \sim \mathcal{D}, y \sim \pi*\phi(y|x)} \left\[ r\_\theta(x, y) \right] - \beta \mathbb{D}*{\text{KL}} \left\[ \pi*\phi(y|x) | \pi\_{\text{ref}}(y|x) \right]$$

目标函数包含两个关键项：

* **奖励最大化项**：鼓励策略生成高 RM 分数的回复
* **KL 散度约束项**：防止策略 $$\pi\_\phi$$ 偏离参考模型 $$\pi\_{\text{ref}}$$（通常是 SFT 模型）太远，维护语言模型的基础能力和输出分布稳定性

$$\beta$$ 为 KL 惩罚系数，是 RLHF 中最重要的超参数之一，通常需要在 0.01\~0.2 之间精细调优。

**Actor-Critic 架构**

PPO 算法采用经典的 Actor-Critic 结构：

* **Actor（策略模型）**：即被训练的语言模型，负责生成回复。其参数通过策略梯度更新，朝着高奖励方向优化。
* **Critic（价值模型）**：估计给定状态（已生成的 Token 序列）的期望累计回报，用于计算 Advantage（优势函数），降低梯度估计的方差。

### 2.1 Critic 模型

* **输入**：当前状态 $$s\_t$$（即已生成的 Token 序列 $$\[x, y\_{\<t}]$$，Prompt + 已生成的前 $$t-1$$ 个 token）
* **输出**：标量值 $$V\_\phi(s\_t)$$，表示"从当前状态出发，遵循当前策略，最终能获得的期望累计回报"

Critic 通常从 RM 或 SFT 模型初始化，其输出头被改造为价值输出。价值模型的损失函数为： $$\mathcal{L}*{\text{critic}} = \left( R\_t - V*\psi(x, y\_{\<t}) \right)^2$$

其中 $$R\_t$$ 为时刻 $$t$$ 的折扣回报。

**训练目标**：Critic 要尽可能准确地预测"从当前状态开始，最终能得多少分"。

#### 2.2 Generalized Advantage Estimation (GAE)

问题是：如何衡量"这一步有多好"？

我们需要计算 **Advantage（优势函数）** $$A\_t$$，表示"在状态 $$s\_t$$ 采取动作 $$a\_t$$（生成第 $$t$$ 个 token）比平均水平好多少"。

有点复杂，我们把它当成在玩一个**二十一点（Blackjack）的游戏**，目标是让手牌点数接近21但不超过。

* **状态** $$s\_t$$：你当前已经有的牌（比如"手里有16点"）
* **动作** $$a\_t$$：你决定"要牌"（Hit）还是"停牌"（Stand）
* **完整回合**：你可能要很多次牌，最后庄家开牌，你**赢钱**或**输钱**（这就是最终的 Reward）

**问题**：如果你最后赢钱了，是**哪一次要牌**的功劳？

* 可能第一次要牌从12加到14很关键？
* 可能第二次从14加到16是冒险但正确的？
* 可能最后停在16点这个决策最明智？

这是一个 **Credit Assignment 的问题**：最终只有一个结果（赢/输），但你要给中间的**每一个动作**打分，告诉模型"这个动作对最终结果贡献了多少"。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FMYJXjFV3EbU1hb8bzMG4%2Fimage.png?alt=media&amp;token=01f9352b-bd13-452d-800c-ab3134448e50" alt=""><figcaption></figcaption></figure>

Advantage 函数 $$A\_t$$ 的核心定义： $$A\_t = \underbrace{Q(s\_t, a\_t)}*{\text{采取这个动作的期望回报}} - \underbrace{V(s\_t)}*{\text{这个状态下平均期望回报}}$$

**通俗解释**：

假设你手里有16点（状态 $$s\_t$$）：

* **平均水平** $$V(s\_t)$$：所有人在16点时，平均最终能赢多少钱（比如平均输0.5元）
* **采取动作"要牌"** $$Q(s\_t, \text{要牌})$$：你在16点时执意要牌，最终能赢多少钱（比如平均赢0.3元）

那么： $$A\_t = 0.3 - (-0.5) = 0.8$$

$$A\_t > 0$$ **意味着**：在16点要牌这个决策**比平均水平好**，应该鼓励（下次在16点时更倾向要牌）。

现在的问题是：$$V(s\_t)$$（平均水平）和 $$Q(s\_t, a\_t)$$（这个动作的价值）我们事先都不知道，必须通过采样来估计。

#### 方法一：蒙特卡洛（MC）——"打完看结果"

**做法**：真的把这局打完，看最后赢了多少钱。

$$A\_t = \underbrace{R\_t}*{\text{这一局最终实际赢的钱}} - \underbrace{V(s\_t)}*{\text{模型估计的平均水平}}$$

例如：

* 你在16点选择要牌，最后拿到了21点，赢了100元，$$R\_t = 100$$
* 模型估计 $$V(16\text{点}) = -0.5$$（平均输钱）
* 优势为：$$A\_t = 100 - (-0.5) = 100.5$$

蒙特卡洛方法的**优点是它是一个无偏估计**。如果你打100万局，平均下来就是真实的期望回报。&#x20;

**缺点是方差极大**。这一局赢100元可能有多种原因，不仅仅是这一步的功劳。蒙特卡洛方法把后面所有的随机性都算到"第一步"的功劳/过错上，导致**信号噪声极大**。

#### 方法二：时序差分（TD）——"只看下一步"

不等到游戏结束，只看**下一步**怎么样。

$$A\_t = r\_t + \gamma V(s\_{t+1}) - V(s\_t)$$

其中：

* $$r\_t$$：立即奖励（比如要牌后没爆，奖励0）
* $$V(s\_{t+1})$$：进入新状态后的平均价值（比如到了18点，估计平均能赢0.1元）
* $$V(s\_t)$$：原状态价值（16点，估计平均输0.5元）

**例子**：

* 你在16点要牌，拿到了2点，变成18点（没爆，$$r\_t=0$$）
* 估计 $$V(18\text{点}) = 0.1$$，$$V(16\text{点}) = -0.5$$
* $$A\_t = 0 + 0.9 \times 0.1 - (-0.5) = 0.59$$

时序差分的**优点是方差小**。只依赖下一步的状态，不关心后面庄家发什么牌，随机性小得多。&#x20;

**缺点是有偏估计**。如果 $$V(18\text{点})$$ 估计得不准（比如实际应该是-0.2），那这个偏差会传递给 $$A\_t$$。

#### GAE 的解决思路

**GAE 的本质**：

> "结合蒙特卡洛和时序差分：既看一步（TD，稳定），也看两步、三步……直到看完整局（MC，准确）"

$$\hat{A}*t^{\text{GAE}} = \delta\_t + (\gamma\lambda)\delta*{t+1} + (\gamma\lambda)^2\delta\_{t+2} + \cdots$$

其中 $$\delta\_t = r\_t + \gamma V(s\_{t+1}) - V(s\_t)$$ 是 TD 误差。

**展开理解（以 3-step 为例）:**

$$\hat{A}*t = \underbrace{\delta\_t}*{\text{1-step TD}} + \underbrace{(\gamma\lambda)\delta\_{t+1}}*{\text{2-step}} + \underbrace{(\gamma\lambda)^2\delta*{t+2}}\_{\text{3-step}} + \cdots$$

**直观解释**：

* $$\lambda = 0$$：只有第一项 $$\delta\_t$$，纯 TD 方法
* $$\lambda = 1$$：无限累加，等价于 $$R\_t - V(s\_t)$$，纯 MC 方法
* $$\lambda = 0.95$$（常用值）：主要依赖实际观测的回报，但用价值函数削减部分方差

**回到打牌的例子**：

* TD 就像你刚要完牌，只看现在手牌好不好，不管后面怎么样（可能过于乐观或悲观）
* MC 就像你一定要打完才知道这步对不对（但可能这局赢钱纯属运气）
* GAE 就像你**既要考虑现在的手牌，也要看接下来几轮的走势，适当加权**，既不那么短视，也不被单局的运气带偏。


# DPO

**DPO**（Direct Preference Optimization）的论文标题：

> *"Your Language Model is Secretly a Reward Model"* （你的语言模型其实就是一个奖励模型）

**意思是，其实不需要像PPO那样显式地训练一个奖励模型，然后再做强化学习。你可以直接用人类偏好数据来优化语言模型本身。**

回到 RLHF 的优化目标：

$$\max\_{\pi} ; \mathbb{E}*{y \sim \pi} \left\[ r(x, y) \right] - \beta \cdot \mathbb{KL}\left\[ \pi(y|x) ;|; \pi*{\text{ref}}(y|x) \right]$$

这个优化问题有一个**闭式解**（closed-form solution）：

$$\pi^\*(y|x) = \frac{1}{Z(x)} \pi\_{\text{ref}}(y|x) \cdot \exp\left(\frac{r(x,y)}{\beta}\right)$$

其中 Z(x) 是归一化常数，确保概率和为 1：

$$Z(x) = \sum\_y \pi\_{\text{ref}}(y|x) \cdot \exp\left(\frac{r(x,y)}{\beta}\right)$$

**对于这个公式的直觉理解是：**&#x6700;优策略就是在参考模型的基础上，按照奖励的指数比例"重新加权"——奖励高的回答概率增大，奖励低的概率缩小。

把上面的最优解反过来解 r(x, y)：

$$r(x, y) = \beta \log \frac{\pi^\*(y|x)}{\pi\_{\text{ref}}(y|x)} + \beta \log Z(x)$$

**也就是说：奖励可以用"最优策略相对于参考策略的对数概率比"来表示**。

Z(x) 只依赖于 x（prompt），和 y（回答）无关。这意味着当我们比较两个回答的奖励差时，Z(x) 会被消掉。

**代入 Bradley-Terry 偏好模型**

人类偏好数据的格式是：给定 prompt x，人类认为回答 y\_w（winner）优于回答 y\_l（loser）。

Bradley-Terry 模型假设人类选择 y\_w 优于 y\_l 的概率为：

$$p(y\_w \succ y\_l | x) = \sigma\left(r(x, y\_w) - r(x, y\_l)\right)$$

其中 σ 是 sigmoid 函数。

把第二步的奖励表达式代入：

$$r(x, y\_w) - r(x, y\_l) = \beta \log \frac{\pi^*(y\_w|x)}{\pi\_{\text{ref}}(y\_w|x)} - \beta \log \frac{\pi^*(y\_l|x)}{\pi\_{\text{ref}}(y\_l|x)}$$

注意 **Z(x) 被消掉了。**

所以：

$$p(y\_w \succ y\_l | x) = \sigma\left(\beta \log \frac{\pi\_\theta(y\_w|x)}{\pi\_{\text{ref}}(y\_w|x)} - \beta \log \frac{\pi\_\theta(y\_l|x)}{\pi\_{\text{ref}}(y\_l|x)}\right)$$

这里用 π\_θ 替代了 π\*，因为我们要训练的模型就是对最优策略的近似。

最终的 DPO 损失函数就是对上面偏好概率取负对数似然：

$$\mathcal{L}*{\text{DPO}}(\pi*\theta; \pi\_{\text{ref}}) = -\mathbb{E}*{(x, y\_w, y\_l) \sim \mathcal{D}} \left\[ \log \sigma\left(\beta \log \frac{\pi*\theta(y\_w|x)}{\pi\_{\text{ref}}(y\_w|x)} - \beta \log \frac{\pi\_\theta(y\_l|x)}{\pi\_{\text{ref}}(y\_l|x)}\right) \right]$$

**拆开来看**：

```
对每一条偏好数据 (x, y_w, y_l)：

1. 计算胜出回答的"隐式奖励"：
   r_w = β × log[ π_θ(y_w|x) / π_ref(y_w|x) ]

2. 计算失败回答的"隐式奖励"：
   r_l = β × log[ π_θ(y_l|x) / π_ref(y_l|x) ]

3. 希望 r_w > r_l，即：
   loss = -log σ(r_w - r_l)
```

**直觉理解**：

* **π\_θ(y\_w|x) / π\_ref(y\_w|x)** ：模型相对于参考模型，对好回答的概率提升了多少
* **π\_θ(y\_l|x) / π\_ref(y\_l|x)** ：模型相对于参考模型，对坏回答的概率提升了多少
* DPO 要求前者的提升**大于**后者的提升——即模型应该"更偏向好回答"

这和交叉熵损失的形式完全一样，可以直接用标准的梯度下降来优化。利用一个**简洁的分类损失代替采样、强化学习和奖励模型。**

对 DPO 损失求梯度，可以更清晰地看到它在做什么：

$$\nabla\_\theta \mathcal{L}*{\text{DPO}} = -\beta \cdot \mathbb{E} \Big\[ \underbrace{\sigma(-\hat{r})}*{\text{权重}} \Big( \underbrace{\nabla\_\theta \log \pi\_\theta(y\_w|x)}*{\text{增大好回答概率}} - \underbrace{\nabla*\theta \log \pi\_\theta(y\_l|x)}\_{\text{减小坏回答概率}} \Big) \Big]$$

其中 $$\hat{r} = \beta \log \frac{\pi\_\theta(y\_w|x)}{\pi\_{\text{ref}}(y\_w|x)} - \beta \log \frac{\pi\_\theta(y\_l|x)}{\pi\_{\text{ref}}(y\_l|x)}$$

**解读**：

1. **增大好回答的概率，减小坏回答的概率**——这是方向
2. **权重 σ(-r̂)**——这是力度。当模型已经正确区分了好坏回答（r̂ 很大），权重接近 0，梯度变小；当模型还分不清（r̂ 接近 0），权重接近 0.5，梯度最大。这是一个**自适应的加权机制**，让模型把注意力集中在它还没学好的样本上。

### 参考

1. <https://www.cnblogs.com/GreenOrange/p/18798910>


# GRPO

GRPO（Group Relative Policy Optimization，群组相对策略优化） 是一种基于强化学习的策略优化算法 ，旨在提升大语言模型在复杂任务（如数学推理、编程）中的表现。

GRPO 最早在 *DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models* 这篇论文中提出。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FGRtbsCoIQWZQ9Saanl73%2Fimage.png?alt=media&amp;token=5eac4e34-39e6-42c9-9105-ae6a8c2d443c" alt=""><figcaption></figcaption></figure>

传统 PPO 需要维护**四个模型**：策略模型（Policy）、参考模型（Reference）、奖励模型（Reward）和价值模型（Critic）。其中 Critic 模型通常与策略模型同等规模，带来显著的显存和计算开销。

| 模型                         | 作用                         |
| -------------------------- | -------------------------- |
| 策略模型（Policy Model）         | 当前正在训练的语言模型                |
| 参考模型（Reference Model）      | 冻结的旧策略，用于 KL 约束            |
| 奖励模型（Reward Model）         | 对输出质量打分                    |
| 价值模型（Critic / Value Model） | 估计状态价值函数，用于计算优势（Advantage） |

GRPO 的关键创新在于**移除 Critic 模型**，改为对每个问题采样**一组输出**，用组内奖励的均值作为 baseline 来估计优势（Advantage）：

* **采样阶段**：对于每个问题 $$q$$，从旧策略 $$\pi\_{\theta\_{old}}$$ 中采样 $$G$$ 个输出 $${o\_1, o\_2, \cdots, o\_G}$$
* **奖励计算**：用奖励模型为每个输出打分，得到 $$G$$ 个奖励 $${r\_1, r\_2, \cdots, r\_G}$$
* **优势估计**：对每个输出的奖励进行组内归一化，作为该输出中所有 token 的优势值：

$$\hat{A}\_{i,t} = \frac{r\_i - \text{mean}({r\_1, \cdots, r\_G})}{\text{std}({r\_1, \cdots, r\_G})}$$

这种"群组相对"的方式天然契合奖励模型的比较性质（奖励模型通常基于同一问题的输出比较进行训练）。

### 1 奖励模型

DeepseekMath的原始论文中，研究团队使用了预训练的 **过程奖励模型（Process Reward Model, PRM）。**

PRM 要对推理过程的**每一步**给出分数（比如 0\~1，表示"这一步是否正确/合理"）。难点在于：**步骤级别的标注从哪来？** 人工对每一步打标签成本极高。

OpenAI 在 *Let's Verify Step by Step*（Lightman et al., 2023）中采用纯人工标注：

* 让模型生成多步推理（数学题）
* 标注员对每一步打三档标签：**正确 / 中性 / 错误**
* 累计标注了 **80 万** 条步骤级标签 → PRM800K 数据集

DeepSeekMath 用的是 *Math-Shepherd*（Wang et al., 2024）提出的**自动化标注**思路，核心是用"蒙特卡洛 rollout"代替人工：

**步骤：**

1. 对一道有标准答案的数学题，让基础模型生成完整解答 $$s\_1, s\_2, \ldots, s\_n$$（按推理步骤切分）
2. 对每个中间步骤 $$s\_i$$，**从该步骤的状态出发**，让模型继续 rollout $$N$$ 次（比如 8 次或 16 次），看最终答案对不对
3. 把"从 $$s\_i$$ 出发能得到正确答案的概率"作为该步骤的软标签：

$$\text{label}(s\_i) = \frac{#{\text{正确的 rollout}}}{N}$$

如果某一步是正确的，从它继续推理大概率能得到正确答案；如果这一步走偏了，后续 rollout 很难再回到正确答案。**最终答案的对错反向给中间步骤打分。**&#x8FD9;样就把"昂贵的步骤标注"转化为"便宜的最终答案验证"——只要题目有标准答案，就能自动生成大量步骤级标签。

数据准备好后，训练就比较直接了：

**模型结构：** 在预训练 LLM 上加一个 token 级的分类头（或回归头）

**输入格式：**

```
Question: ...
Step 1: xxx <step_tag>
Step 2: yyy <step_tag>
...
```

在每个特殊 token `<step_tag>` 的位置预测该步骤的标签。

**损失函数：**

* 软标签（如 Math-Shepherd）：用 MSE 或交叉熵回归到概率值 $$\mathcal{L} = \sum\_i \text{BCE}\big(\hat{p}(s\_i),\ \text{label}(s\_i)\big)$$
* 硬标签：标准的二分类交叉熵

### 2 目标函数与算法流程

GRPO 的目标函数如下：

$$J\_{GRPO}(\theta) = \mathbb{E}*{q \sim P(Q), {o\_i}*{i=1}^G \sim \pi\_{\theta\_{old}}(O|q)} \left\[ \frac{1}{G} \sum\_{i=1}^G \frac{1}{|o\_i|} \sum\_{t=1}^{|o\_i|} \left( \min\left( \frac{\pi\_\theta}{\pi\_{\theta\_{old}}} \hat{A}*{i,t}, \text{clip}(\frac{\pi*\theta}{\pi\_{\theta\_{old}}}, 1-\epsilon, 1+\epsilon) \hat{A}*{i,t} \right) - \beta D*{KL}\[\pi\_\theta | \pi\_{ref}] \right) \right]$$

其中：

* 第一项是带裁剪的策略梯度，与 PPO 类似
* 第二项是 KL 散度惩罚，**直接加到 loss 中**而非奖励里，避免 advantage 计算复杂化
* $$\epsilon$$ 和 $$\beta$$ 是超参数

算法流程：

1. 将当前策略设为参考模型 $$\pi\_{ref} \leftarrow \pi\_\theta$$
2. 对每个训练步骤：
   * 采样 batch 数据，更新旧策略 $$\pi\_{\theta\_{old}} \leftarrow \pi\_\theta$$
   * 对每个问题采样 $$G$$ 个输出
   * 计算奖励和组相对优势 $$\hat{A}\_{i,t}$$
   * 进行 $$\mu$$ 次 GRPO 迭代更新策略
3. 用 replay 机制持续更新奖励模型

### 3 为什么 GRPO 有效

GRPO 的策略梯度本质上是一种 **U-Statistic**，具有以下性质：

1. **Oracle 等价性**：GRPO 渐近等价于一个拥有完美价值函数的 Oracle 策略梯度算法
2. **最优性**：在广泛的策略梯度算法类中，GRPO 能达到渐近最优性能
3. **可扩展性**：存在通用的群组大小缩放规律，可用于指导最优组大小选择

相比 PPO，GRPO 避免了训练 Critic 带来的方差和不稳定性；相比 DPO，GRPO 支持在线探索和迭代训练，更适合复杂推理任务。

### 参考

1. <https://blog.csdn.net/Eternity__Aurora/article/details/149080119>
2. <https://arxiv.org/abs/2402.03300>


# DAPO

**DAPO**（**D**ecoupled Clip and Dynamic s**A**mpling **P**olicy **O**ptimization）是字节跳动 Seed 团队与清华 AIR 在 2025 年 3 月提出的一套大规模 LLM 强化学习算法与系统，论文为 *DAPO: An Open-Source LLM Reinforcement Learning System at Scale*（Yu et al., 2025, arXiv:2503.14476）。

DAPO 在 GRPO 的基础上引入了 **4 项关键技术改进**，用 Qwen2.5-32B 作为基座模型，在 AIME 2024 数学竞赛上取得了 **50 分**，超过了同期 DeepSeek-R1-Zero-Qwen-32B 的 47 分，且训练步数仅为后者的 **50%**。

### 1 动机

vanilla GRPO 训练 32B 模型时观察到 4 个严重问题：

| 问题                        | 具体表现                                                        |
| ------------------------- | ----------------------------------------------------------- |
| **熵崩塌（Entropy Collapse）** | 策略熵迅速下降，模型早期就锁定到少数生成模式，丧失探索能力                               |
| **梯度无效（Zero Gradient）**   | 一组采样中所有输出全对或全错时，组内奖励标准差为 0，优势全为 0，整 batch 梯度白算              |
| **长样本被惩罚**                | 在长 CoT 场景下（数万 token），GRPO 的样本级 loss 平均使长输出中的低质量 token 难以被惩罚 |
| **奖励噪声**                  | 超长输出被截断后仍按"错误答案"给负奖励，引入虚假信号                                 |

DAPO 的 4 项技术分别针对性地解决这 4 个问题。

### 2 四大核心技术

#### 2.1 Clip-Higher

PPO/GRPO 的 clip 操作用对称区间 $$\[1-\epsilon,\ 1+\epsilon]$$（通常 $$\epsilon=0.2$$）。这对**低概率 token 的提升**非常不利——一个概率 0.01 的 token，最多只能提升到 $$0.01 \times 1.2 = 0.012$$，几乎无法被强化。

但是，当我们把上下界拆开：

$$\text{clip}\left(\rho\_{i,t},\ 1-\epsilon\_{\text{low}},\ 1+\epsilon\_{\text{high}}\right)$$

实践中 $$\epsilon\_{\text{low}}=0.2$$ 保持不变，$$\epsilon\_{\text{high}}$$ 放大到 **0.28**。这样允许低概率 token 有更大的上升空间，**保留探索**，避免熵崩塌。

> 直觉：下界控制"别太激进地降低坏 token 的概率"，上界控制"别太激进地拔高好 token 的概率"。两者的合理范围本来就不对称。

#### 2.2 Dynamic Sampling

GRPO 对每个 prompt 采样 $$G$$ 个回答（如 $$G=16$$）。对于太简单或太难的题目，常出现"全对"或"全错"——此时组内归一化后所有优势都是 0，**这些样本对梯度没有任何贡献**，浪费算力还稀释了 batch 的有效信号。

**DAPO使用过采样 + 动态过滤**。持续采样直到 batch 中**正确率严格在 (0, 1) 之间**的 prompt 数量达到目标值：

$$0 < \left| {o\_i \mid \text{is\_correct}(q, o\_i)} \right| < G$$

也就是说，每个被采纳的 prompt 都至少有 1 个对、1 个错的回答，确保组内优势非零。

**收益：** 训练效率显著提升——虽然单步采样成本增加，但有效梯度密度更高，整体收敛更快。

#### 2.3 Token-Level Policy Gradient Loss

GRPO 原始 loss 是**样本级平均**：

$$\mathcal{L}*{\text{GRPO}} = \frac{1}{G}\sum*{i=1}^{G}\frac{1}{|o\_i|}\sum\_{t=1}^{|o\_i|}\ell\_{i,t}$$

注意每个样本先内部按长度归一化，再在样本间平均。这意味着：**一个 100 token 的样本和一个 10000 token 的样本对梯度的贡献相同**。在长 CoT 场景下，长输出里的每个 token 被严重稀释，无意义的重复、胡言乱语难以被有效惩罚。

DAPO的做法是改为**所有 token 一起平均**：

$$\mathcal{L}*{\text{DAPO}} = \frac{1}{\sum*{i=1}^{G}|o\_i|}\sum\_{i=1}^{G}\sum\_{t=1}^{|o\_i|}\ell\_{i,t}$$

长样本里的每个 token 现在和短样本里的 token **同等权重**。这样：

* 长输出中的高质量推理 token 能获得更大权重 → 鼓励有效长链推理
* 长输出中的退化模式（重复、乱码）也能被有效惩罚 → 抑制低质量长输出

#### 2.4 Overlong Reward Shaping

GRPO 训练时给生成长度设置了硬上限（如 20480 token）。被截断的样本即使推理过程正确，也因没输出最终答案被判错，得到 -1 奖励——这是**虚假的负信号**，会误导模型。

DAPO采用了两种策略：

**(a) Overlong Filtering**：直接把被截断的样本从 loss 中屏蔽，不参与梯度计算。

**(b) Soft Overlong Punishment**：在硬上限之前设置一个软缓冲区，长度超过软阈值后逐步线性扣分，超过硬上限才完全屏蔽：

$$R\_{\text{length}}(y) = \begin{cases} 0 & |y| \le L\_{\text{max}} - L\_{\text{cache}} \ \frac{(L\_{\text{max}} - L\_{\text{cache}}) - |y|}{L\_{\text{cache}}} & L\_{\text{max}} - L\_{\text{cache}} < |y| \le L\_{\text{max}} \ -1 & |y| > L\_{\text{max}} \end{cases}$$

这样模型被**温和地告知"该收敛了"**，而不是粗暴地把"思考太久"和"答错"混为一谈。

### 3 目标函数

整合 4 项改进后的完整目标函数：

$$\mathcal{J}*{\text{DAPO}}(\theta) = \mathbb{E}*{(q,a)\sim\mathcal{D},\ {o\_i}*{i=1}^{G}\sim\pi*{\theta\_{\text{old}}}(\cdot|q)} \left\[ \frac{1}{\sum\_i |o\_i|}\sum\_{i=1}^{G}\sum\_{t=1}^{|o\_i|} \min\Big(\rho\_{i,t}\hat{A}*{i,t},\ \text{clip}(\rho*{i,t},\ 1-\epsilon\_{\text{low}},\ 1+\epsilon\_{\text{high}})\hat{A}\_{i,t}\Big) \right]$$

约束条件：

$$\text{s.t.}\quad 0 < \big|{o\_i \mid \text{is\_equivalent}(a, o\_i)}\big| < G$$

注意几个细节：

* **没有 KL 惩罚项**：作者发现在长 CoT 推理任务中，策略会大幅偏离初始模型，KL 约束反而限制了探索。直接去掉。
* **没有 Critic**：与 GRPO 一致，仍用组内归一化估计优势
* **优势仍是 token 级共享**：$$\hat{A}\_{i,t} = \tilde{r}\_i$$，组内 z-score

### 4 算法流程

```
输入：初始策略 π_θ，奖励函数 R，训练数据 D
重复直到收敛：
    1. 采样 batch B = {}
    2. While |B| < batch_size:
         a. 从 D 采样若干 prompt
         b. 对每个 prompt q 采样 G 个输出 {o_i}
         c. 用 R 给每个输出打分，计算正确率
         d. 仅保留 0 < 正确率 < 1 的 prompt 加入 B
    3. 对 B 中每组计算优势 Â_{i,t}（组内归一化）
    4. 应用超长奖励整形修正 r_i
    5. 进行 μ 次梯度更新（用 token 级 loss + 解耦 clip）
```

### 参考

1. <https://arxiv.org/pdf/2503.14476>


# RLVR

### 1 什么是 Verifiable Reward

一个奖励函数 $$r(q, o)$$ 如果可以由一段确定性程序在有限时间内判定，就称为 verifiable reward。最常见的形式是二值的:

$$r(q, o) = \mathbb{1}{\mathrm{verify}(q, o) = \texttt{pass}} \in {0, 1}$$

其中，`1{...}` 是**指示函数,**&#x547D;题为真返回 1,为假返回 0:

典型实例:

| 类型     | 验证器                    |
| ------ | ---------------------- |
| 数学最终答案 | 字符串/数值/符号等价匹配          |
| 代码     | 解释器 + 单元测试             |
| 形式化证明  | Lean / Coq 内核          |
| 结构约束   | JSON Schema、正则、长度、格式标签 |
| 游戏/规划  | 环境模拟器的终止状态             |

它的三个关键性质:

* **可判定**:有固定的标准。
* **廉价且可并行**
* **相对抗操纵**: “相对”不那么容易被 hack

**可验证性是关于"评价"的性质,不是关于"任务"的性质**。同一个任务，换一种输出格式，可验证性会完全不同。

### 2. 为什么数学和代码最适合 RLVR

三个原因：

1. **生成难、验证易的不对称性。** 这本质上是 NP 式的结构：找到一个 15 行的正确实现很难，运行 20 个单元测试很容易。RL 需要海量的 $$(o, r)$$ 对，只有当验证成本远低于生成成本时，这个循环才在经济上成立。
2. **答案空间可归一化。** 数学题的最终答案能被投影到一个小的、可比较的空间(例如一个整数、一个分式、一个表达式)。这让"对/错"这个判断不需要理解中间推理。
3. **语义由执行定义。** 代码尤其特殊:它的正确性不是由人的判断定义的，而是由解释器定义的。这意味着奖励几乎没有标注噪声，也就是不存在主观性。

反过来说，这三个理由也精确地指出了 RLVR 在别处会遇到什么困难：开放式写作的输出空间不可归一化，长程 agent 任务的验证成本可能高于生成成本，而"这个回答有帮助吗"没有执行语义。

但是实践并没有想象中那么简单，中数学 RLVR 的验证器有大量**假阴性**(例如`1/2` vs `0.5` vs $$\frac{1}{2}$$； $$2\sqrt{3}$$ vs  $$\sqrt{12}$$ )和**假阳性**(多选题猜中、数值巧合、模型输出里恰好包含答案子串)。一个粗糙的 `boxed` 正则匹配，假阴率能到百分之几——这些噪声会被后面讲的方差放大机制放大。

### 3. RLHF、RLAIF、RLVR 的区别

|        | RLHF                              | RLAIF                     | RLVR            |
| ------ | --------------------------------- | ------------------------- | --------------- |
| 奖励来源   | 人类偏好数据训练的 RM                      | 更强 LLM 的判断 / constitution | 确定性程序           |
| 信号形式   | 标量(有序但无绝对尺度)                      | 标量或偏好                     | 二值(或分档)         |
| 标注成本   | 高,随任务线性增长                         | 中,可扩展                     | 近乎没有            |
| 主要失效模式 | RM over-optimization(奖励模型被外推到分布外) | judge 的风格偏好、自我偏爱、谄媚       | 验证器漏洞、格式钻空、答案泄漏 |
| 优化上限   | RM 的准确性                           | judge 的能力                 | 验证器的覆盖度         |
| 适用任务   | 主观、开放                             | 主观 + 半客观                  | 客观、可判定          |

RLHF、RLAIF、RLVR 三者的**差别不在算法，真正的区别在于谁来当裁判**。

* **RLHF：**&#x88C1;判是人。但人打分又慢又贵，所以实际做法是先请人打少量一批分数，再根据这批数据训一个小的 Reward Model 代替人打分。
* **RLAIF：**&#x88C1;判是另一个 LLM，它可以根据给定评分标准来打分。
* **RLVR：**&#x88C1;判是一段程序。例如代码问题就跑自动化测试，数学问题就和答案比较。

GRPO/PPO 都可以配任意一种奖励。RLVR 的独特优势是裁判判断的**保真度的上限是 1.0，**&#x800C;不是 RM 的 0.7\~0.9；它的代价是裁判的**覆盖率极低**——世界上大部分值得做的任务都不在它的定义域里。

还有一个常被忽略的差别：RLHF 的奖励通常是**稠密相对**的(任何两个回答都能比出高低)，而 RLVR 的奖励是**稀疏绝对**的(要么 0 要么 1)。这直接导致了后面所有关于组内方差、零梯度、采样效率的问题。

### 4. Outcome Reward 与 Process Reward

**Outcome Reward (ORM)：**&#x53EA;在序列末尾给一个信号，$$r$$ 只依赖最终答案。&#x20;

**Process Reward (PRM)：**&#x7ED9;推理链的每一步  $$s\_i$$ 一个信号 $$r\_i$$。

差别的本质是 **credit assignment(信用分配)**。一条 500 token 的推理链只拿到一个 bit 的反馈，意味着策略梯度必须把这 1 bit 均摊到 500 个 token 上——第 300 步的关键错误和第 5 步无关紧要的措辞得到完全相同的惩罚。这是纯粹的统计效率问题，需要更多样本才能把有效信号从噪声里分离出来。

#### 4.1 结果奖励真的改善了推理过程吗?

这是本文最想认真回答的问题。答案是:**它可靠地改善了拿到正确答案的策略，只在推理是拿到答案的必要手段时才顺带改善推理**。也就是说，改善推理过程本身不是结果奖励的直接目的。

1. **分布锐化 vs 能力扩展。** 大量复现实验观察到这样的模式：RLVR 之后 pass\@1 显著上升,而 pass\@k(k 较大,比如 256)持平甚至下降。对于这个现象的一种假设是：RL 把 base model 本来就能采样到的正确解的概率质量往上抬，同时压缩了熵——它重新分配了概率，但没有创造新的解。也就是说，**GRPO 的更新方向永远是“把已经成功过的东西做得更确定”，它结构上无法奖励一个从未成功过的行为**。
2. **答案对但过程错。** 结果奖励对过程的正误毫不在意。多选题、有限答案空间的数值题、以及模型在错误推理后凭直觉写出正确答案的情况，都会拿到 $$r=1$$。ProcessBench 一类的评测显示，即使是很强的模型也难以定位一条推理链里第一个出错的步骤——这说明"过程正确性"和"答案正确性"在训练信号层面被系统性地混同了。更糟的是,有研究观察到 outcome-only RL 会**降低**推理链的忠实度:模型学会写出一段看起来像推理的文本,同时用另一条内部捷径得到答案。
3. **Spurious reward。** 对某些 base model(尤其 Qwen 系列)，即使用随机奖励或错误奖励做 RL，某些数学 benchmark 上的分数也会上升。这几乎只能解释为 RL 在**唤醒**预训练里已有的格式与行为模式(输出 `\boxed{}`、使用代码式推理)，而不是在**学习**推理。

**结论**结果奖励是一个关于**输出端点**的约束。只要是存在捷径的地方，它就会奖励捷径；只有推理是唯一路径的地方,它才奖励推理。所以"能不能靠结果奖励得到好的过程"这个问题，等价于"当前任务是否不存在任何捷径"。

### 5. GRPO 在 RLVR 中扮演什么角色

#### 5.1 算法本体

GRPO 相对 PPO 的唯一实质改动：**用组内蒙特卡洛统计量替代 critic**。对每个 prompt $$q$$ 采 $$G$$ 条回答 $${o\_1,\dots,o\_G}$$，优势为 z-score 后的奖励:

$$A(q, o\_i) = \frac{r(q,o\_i) - \mu(q)}{\sigma(q)}, \quad \mu = \frac{1}{G}\sum\_j r\_j,\ \ \sigma = \mathrm{std}(r\_{1..G})$$

目标函数是 PPO 式的裁剪代理目标,加上对参考策略的 KL 惩罚。

省掉 critic 带来两个好处：显存减半、以及不需要处理"critic 在长序列上估不准价值"这个问题。

#### 5.2 为什么能放大成功概率

设 $$p(q)$$ 为旧策略在问题 $$q$$ 上的成功概率 (PoS, probability of success)。奖励是伯努利的，所以 $$\mu = p$$ ，$$\sigma^2 = p(1-p)$$。代入 z-score 公式:

$$A(q,o) = \begin{cases} \dfrac{1-p}{\sqrt{p(1-p)}} = \sqrt{\dfrac{1-p}{p}} & r = 1 \[2ex] -\dfrac{p}{\sqrt{p(1-p)}} = -\sqrt{\dfrac{p}{1-p}} & r = 0\end{cases}$$

这个公式说明：**GRPO 不是在优化一个固定的奖励，而是在优化一个被"当前难度"重新标定过的奖励**。看具体数值:

| p    | 成功样本权重 $\sqrt{(1-p)/p}$ | 失败样本权重 $-\sqrt{p/(1-p)}$ |
| ---- | ----------------------- | ------------------------ |
| 0.01 | **+9.95**               | −0.10                    |
| 0.10 | +3.00                   | −0.33                    |
| 0.25 | +1.73                   | −0.58                    |
| 0.50 | +1.00                   | −1.00                    |
| 0.75 | +0.58                   | −1.73                    |
| 0.90 | +0.33                   | −3.00                    |
| 0.99 | +0.10                   | **−9.95**                |

* **难题上罕见的成功被极度放大**($$p=0.01$$ 时权重接近 10),而失败几乎不被惩罚。
* **简单题上失败被极度惩罚**,成功几乎不给奖励。GRPO 会花大量精力解决那些本该做对却做错的题。
* 展开成损失函数，GRPO 等价于一个**自适应加权的对比损失**:正样本项的权重是 $$\sqrt{(1-p)/p}$$，负样本项的权重是 $$\sqrt{p/(1-p)}$$，而对比样本来自上一轮策略自己生成的合成数据。

#### 5.3 归一化本身引入的偏差

归一化不是免费的。

* **除以** $$\sigma$$ **引入难度偏差。** mean-only 归一化(不除方差)才是无偏的策略梯度；除以 $$\sigma$$  会按难度重新加权问题，系统性地给中等难度题更大的更新幅度。上面的表就是这个偏差的定量形式。
* **除以** $$|o|$$ **引入长度偏差。** 原始 GRPO 按序列长度平均 token loss,这让长的错误回答每个 token 受到的惩罚更小,从而系统性地鼓励"错就错长一点"。DAPO 的 token-level loss(在整个 batch 的 token 上归一化,而非先按序列内平均)修掉了这一项。这是**长度爆炸**最常被忽略的直接来源，很多人会误以为它是模型学会了深度思考。

### 6. 为什么全对和全错的组无法提供有效相对优势

若组内所有 $$r\_i$$ 相等(全 0 或全 1),则 $$\mu = r\_i$$,于是分子 $$r\_i - \mu = 0$$ 对所有 $$i$$ 成立,$$\sigma = 0$$。无论实现是加 $$\varepsilon$$ 平滑还是显式置零，**该组对梯度的贡献严格为 0**。

GRPO 的优势是**组内相对**的,一个没有内部差异的组不包含任何关于什么更好的信息。

定量的来看，一个组退化的概率是：

$$P(\text{degenerate}) = p^G + (1-p)^G$$

| $p$  | $G=8$ | $G=16$ | $G=64$ |
| ---- | ----- | ------ | ------ |
| 0.5  | 0.8%  | 0.003% | \~0    |
| 0.2  | 17%   | 2.8%   | 0.001% |
| 0.05 | 66%   | 44%    | 3.8%   |
| 0.01 | 92%   | 85%    | 53%    |
| 0.95 | 66%   | 44%    | 3.8%   |

两个结论:

1. **有效 batch size 是一个随训练动态变化的隐变量。** 训练初期数据太难 → 大量全错组；训练后期数据被学会 → 大量全对组。两端都会让有效 batch 塌缩。&#x20;
2. **最优数据难度在**  $$p \approx 0.5$$ **附近。** $$p \approx 0.5$$ 时组退化概率最低，且期望梯度幅度 $$\propto \sqrt{p(1-p)}$$ 最大。所以 GRPO 隐含地要求一个把数据维持在 50% 通过率附近的课程机制。

### 7. 如何处理零成功率

**首先，零成功率不是算法能解决的问题**。p=0 意味着策略的支撑集里没有正解，而策略梯度只能重新加权支撑集内的东西。因此需要从**外部**注入一条成功轨迹。下面是一些可能的方法：

1. **诊断。** 先用 pass\@k(k=64 或 256)测试每道题的可解性，把数据分成$$p=0$$、$$0\<p<1$$、$$p=1$$三桶。前后两桶可以直接丢弃，因为在当前阶段对 GRPO 是纯粹的算力浪费。
2. **采样层面**

* **Dynamic sampling(DAPO)：**&#x8FC7;采样并丢弃退化组，持续补采直到 batch 填满非退化组。代价是每步的实际 rollout 数变多且不定，但有效 batch 恒定。
* **提高** $$G$$**：**&#x628A;截断上限从 $$\sqrt{G-1}$$ 抬高,并把可用难度下界从 $$1/G$$ 推低。
* **Clip-higher**:把上界裁剪 $$\epsilon\_{\text{high}}$$ 放宽(比如 0.28),给低概率 token 留出被抬升的空间,抑制熵坍缩。
* **温度与 top-p**:训练采样用高温、评测用低温。

3. **问题层面**

* **课程与难度分桶：**&#x6309;实测 $$\hat p$$ 排课,维持 batch 的平均 $$\hat p$$ 在 0.3\~0.7。
* **提示注入 / 逆向课程**:把参考解的前 $$k%$$ 作为前缀塞进 prompt,让 $$p$$ 从 0 变成正数;随训练逐步减少 $$k$$。
* **难度自适应权重**:对不同子任务按"剩余提升空间"加权,形成隐式课程。

4. **信号层面**

* **分档奖励**:代码任务用**单元测试通过率**而非全通过与否;数学任务给格式分、给中间过程正确性分。
* **过程奖励 / 子目标**
* **蒙特卡洛价值估计**:从推理链的中间状态继续 rollout,用后续成功率作为该步的价值,得到逐步优势(Math-Shepherd、VinePPO、VSRM 一类)。

5. **分布层面**

* **拒绝采样微调 / expert iteration 预热：**&#x5148;用高温大量采样 + 验证器筛选出正解做 SFT，把 $$p$$ 从 0 抬到可 RL 的区间,再上 GRPO。这是最稳的工程路径,几乎所有严肃的 RLVR pipeline 都有这一步。
* **从更强模型蒸馏种子轨迹**:能力上限受教师限制。

### 8. Reward Hacking

#### 9.1 策略攻击验证器

| 攻击    | 表现                                                               | 防御                                                   |
| ----- | ---------------------------------------------------------------- | ---------------------------------------------------- |
| 测试泄漏  | 代码读取 test 文件、`__file__`、环境变量后硬编码答案                               | 测试与代码物理隔离,独立进程、独立目录、不传测试路径                           |
| 断言绕过  | 覆盖 `assert`、monkey-patch `unittest`、`sys.exit(0)`、修改 `pytest` 钩子 | 在受限解释器里跑;检查退出码**与**测试计数;禁止导入 `sys`/`os`(或白名单 import) |
| 平凡通过  | 用 `try/except: pass` 吞掉所有异常;返回硬编码常量恰好通过 3 个可见测试                  | held-out 测试;mutation testing(自动变异测试用例)               |
| 超时利用  | 死循环压 timeout,或利用"超时不算失败"的实现                                      | 超时显式记为 $r=0$;资源限额(CPU 时间、内存、进程数)                     |
| 格式钻空  | 一次输出多个 `\boxed{}` 覆盖多个可能答案;在推理里穷举                                | 只取最后一个/唯一一个;检测到多答案直接 $r=0$                           |
| 答案泄漏  | prompt 或 few-shot 里意外包含答案;数据集与预训练语料重叠                            | 去重、去污染、held-out 时间切片评测                               |
| 语言/退化 | 中英混杂、无意义重复、乱码但答案对                                                | 格式与语言一致性作为**门控**(不是加分项)                              |

#### 9.2 验证器自身出错

* **假阴性**(对答案被判错):等价形式未归一化。后果比想象严重——它给正确行为负梯度,而且这些负梯度出现在最难的题上(那里 $p$ 最小,失败权重虽小,但正确样本被误判成失败等于直接抹掉了唯一的正信号)。**上线前必须人工抽检 200 条被判错的样本。**
* **假阳性**(错答案被判对):子串匹配过宽、数值容差过大、多选题猜中。后果是模型学到捷径。
* **验证器覆盖不足**:3 个测试的"通过"和 30 个测试的"通过"是完全不同的奖励函数。稀疏的测试集直接定义了一个更宽的可行域,而 RL 一定会找到那个可行域里最便宜的点。

***

### 参考

1. [https://arxiv.org/abs/2402.03300](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
2. [https://arxiv.org/abs/2501.12948](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
3. [https://arxiv.org/abs/2503.06639](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
4. [https://arxiv.org/abs/2503.20783](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
5. [https://arxiv.org/abs/2503.14476](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
6. [https://arxiv.org/abs/2305.20050](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
7. [https://github.com/openai/prm800k](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
8. [https://arxiv.org/abs/2312.08935](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
9. [https://arxiv.org/abs/2410.01679](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
10. [https://arxiv.org/abs/2508.10293](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
11. [https://aclanthology.org/2026.findings-acl.1611/](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
12. [https://arxiv.org/abs/2603.29500](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
13. [https://arxiv.org/abs/2605.12519](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
14. [https://arxiv.org/abs/2504.13837](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
15. [https://arxiv.org/abs/2506.10947](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)
16. [https://arxiv.org/abs/2605.17291](<https://arxiv.org/abs/2402.03300&#xA;https://arxiv.org/abs/2501.12948&#xA;https://arxiv.org/abs/2503.06639&#xA;https://arxiv.org/abs/2503.20783&#xA;https://arxiv.org/abs/2503.14476&#xA;https://arxiv.org/abs/2305.20050&#xA;https://github.com/openai/prm800k&#xA;https://arxiv.org/abs/2312.08935&#xA;https://arxiv.org/abs/2410.01679&#xA;https://arxiv.org/abs/2508.10293&#xA;https://aclanthology.org/2026.findings-acl.1611/&#xA;https://arxiv.org/abs/2603.29500&#xA;https://arxiv.org/abs/2605.12519&#xA;https://arxiv.org/abs/2504.13837&#xA;https://arxiv.org/abs/2506.10947&#xA;https://arxiv.org/abs/2605.17291>)


# MoE


# 专家并行

**核心思想：专家并行 = 专家分布 + 动态路由 + All2All 通信**

### 1 专家并行概述

专家并行的目标是将一个 MoE 层中的众多专家分布到不同的设备上，每个设备负责一部分专家。如果某个设备上的计算需要其他设备的专家，可以通过All2All通信实现。

专家并行的思想来自于论文：GShard: Scaling Giant Models with Conditional Computation and Automatic Sharding，如下图所示。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-13047e026434d93aafe58950e7dfb772fb26bf7a%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

具体来说，MoE模型通常使用 Gating 模块来决定每个输入数据样本应该由哪些专家来处理。假设有一个输入数据样本位于设备 A 上，而 Gating 模块决定该样本应该由设备 B 和设备 C 上的专家来处理，那么就需要将该数据样本从设备 A 传输到设备 B 和设备 C。

### 2 All2All通信

All2All是**分布式计算、并行计算和高性能计算**中的一种核心通信模式。

> **在一个由 N 个节点组成的群体中，每一个节点都需要向其他&#x20;*****所有*****&#x20;N-1 个节点发送一份不同的数据，同时也需要从其他&#x20;*****所有*****&#x20;N-1 个节点接收一份不同的数据。**

即“所有人给所有人发消息”。如下图所示，看起来很像一个矩阵的转置操作。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-e3dea6a17e46356cb1938a2cc6baabc7a92f3024%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

#### 1.1 标准 All2All

标准All2All即均匀发送和接受数据，发送到和接受自不同设备的数据量相同。

可以使用 `torch.distributed` 实现。

```python
import torch
import torch.distributed as dist

def run_standard_all2all():
    rank = dist.get_rank() # rank代表进程
    size = dist.get_world_size() # size代表分布式组中参与进程的总数
    device = torch.device(f"cuda:{rank}")
    # 在每个rank上创建对应的input_tensor
    input_tensor = torch.ones(size, dtype=torch.int32, device=device) * rank
    print(f"Rank {rank} before all2all, input_tensor: {input_tensor.tolist()}")
    
    output_tensor = torch.empty(size, dtype=torch.int32, device=device)
    dist.all_to_all_single(output_tensor, input_tensor)
    print(f"Rank {rank} after all2all, output_tensor: {output_tensor.tolist()}")
    
def main():
    dist.init_process_group(backend='nccl')  # 初始化分布式环境
    run_standard_all2all()
    dist.destroy_process_group()  # 销毁分布式环境
    
if __name__ == "__main__":
    main()
```

假设文件名为 [`test.py`](http://test.py) ，启动命令如下：

```python
torchrun --nproc_per_node=4 --nnodes=1 --node_rank=0 --master_addr=127.0.0.1 --master_port=29500 test.py
```

输出结果如下：

```python
Rank 0 before all2all, input_tensor: [0, 0, 0, 0]
Rank 2 before all2all, input_tensor: [2, 2, 2, 2]
Rank 1 before all2all, input_tensor: [1, 1, 1, 1]
Rank 3 before all2all, input_tensor: [3, 3, 3, 3]
Rank 1 after all2all, output_tensor: [0, 1, 2, 3]
Rank 2 after all2all, output_tensor: [0, 1, 2, 3]
Rank 3 after all2all, output_tensor: [0, 1, 2, 3]
Rank 0 after all2all, output_tensor: [0, 1, 2, 3]
```

#### 1.2 非标准 All2All

实际上有些场景并非均匀发送和接收，有可能发送到不同设备的数据量不同，从不同设备接收的数据量也可能不同。Pytorch 的 `torch.distributed.all_to_all_single` 提供了 `input_split_sizes` 和 `output_split_sizes` 参数来支持：

* `input_split_sizes` 表示向每个设备发送的数据量。
* `output_split_sizes` 表示从每个设备接收的数据量。

假设有4个GPU，每个GPU包含10个数据：

* 4 个 GPU 都向 GPU k 发送 k+1 个数据
  * 即，都向 GPU 0 发送 1 条数据，向 GPU 3 发送 4 条数据
* GPU k 从其余每个 GPU 都接收 k+1 个数据
  * 即，GPU 0 从其余每个 GPU 接收 1 条数据，共接收 3 条

如下图所示：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fgit-blob-2c639dae272c946d40331ced6961ab7b16343563%2Fimage.png?alt=media" alt=""><figcaption></figcaption></figure>

代码实现如下：

```python
import torch
import torch.distributed as dist

def run_nonstandard_all2all():
    rank = dist.get_rank()
    size = dist.get_world_size()
    device = torch.device(f"cuda:{rank}")
    input_splits = [i+1 for i in range(size)]
    input_tensor = torch.ones(sum(input_splits), dtype=torch.int32, device=device) * rank
    print(f"Rank {rank} before all2all, input_tensor: {input_tensor.tolist()}")

    output_splits = [rank + 1] * size
    output_tensor = torch.empty(sum(output_splits), dtype=torch.int32, device=device)
    dist.all_to_all_single(output_tensor, input_tensor, output_splits, input_splits)
    print(f"Rank {rank} after all2all, output_tensor: {output_tensor.tolist()}")

def main():
    dist.init_process_group(backend='nccl')  # 初始化分布式环境
    run_nonstandard_all2all()
    dist.destroy_process_group()  # 销毁分布式环境

if __name__ == "__main__":
    main()
```

输出如下：

```python
Rank 3 before all2all, input_tensor: [3, 3, 3, 3, 3, 3, 3, 3, 3, 3]
Rank 1 before all2all, input_tensor: [1, 1, 1, 1, 1, 1, 1, 1, 1, 1]
Rank 2 before all2all, input_tensor: [2, 2, 2, 2, 2, 2, 2, 2, 2, 2]
Rank 0 before all2all, input_tensor: [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
Rank 2 after all2all, output_tensor: [0, 0, 0, 1, 1, 1, 2, 2, 2, 3, 3, 3]
Rank 3 after all2all, output_tensor: [0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3]
Rank 0 after all2all, output_tensor: [0, 1, 2, 3]
Rank 1 after all2all, output_tensor: [0, 0, 1, 1, 2, 2, 3, 3]
```

#### 1.3 两次 All2All

上述非标准 All2All 中有个问题：有些时候当前设备只知道要向其他设备发送多少数据，而并不知道需要从其他设备接收多少数据。

这个问题可以通过 2 次 all2all 来解决：

* 第一次 all2all 交换要传输的数据量信息，这是一个标准的 all2all 操作。
* 第二次 all2all 根据上述获取的数据量信息来执行真正的数据传输，此时是一个非标准 all2all 操作。

代码如下：

```python
def run_all2al_twice():
    rank = dist.get_rank()
    size = dist.get_world_size()
    device = torch.device(f"cuda:{rank}")

    # 第一次 all_to_all
    input_splits = [i + 1 for i in range(size)]
    input_tensor = torch.ones(sum(input_splits), dtype=torch.int32, device=device) * rank
    print(f"Rank {rank} before first all2all, input_tensor: {input_tensor.tolist()}")

    input_splits_pt =  torch.tensor(input_splits, dtype=torch.int32, device=device)
    output_splits_pt = torch.empty(size, dtype=torch.int32, device=device)
    dist.all_to_all_single(output_splits_pt, input_splits_pt)
    output_splits = output_splits_pt.tolist()
    print(f"Rank {rank} after first all2all, output_splits: {output_splits}")

    output_tensor = torch.empty(sum(output_splits), dtype=torch.int32, device=device)
    dist.all_to_all_single(output_tensor, input_tensor, output_splits, input_splits)
    print(f"Rank {rank} after first all2all, output_tensor: {output_tensor.tolist()}")

def main():
    dist.init_process_group(backend='nccl')  # 初始化分布式环境
    run_all2al_twice()
    dist.destroy_process_group()  # 销毁分布式环境

if __name__ == "__main__":
    main()
```

输出如下：

```python
Rank 3 before first all2all, input_tensor: [3, 3, 3, 3, 3, 3, 3, 3, 3, 3]
Rank 1 before first all2all, input_tensor: [1, 1, 1, 1, 1, 1, 1, 1, 1, 1]
Rank 0 before first all2all, input_tensor: [0, 0, 0, 0, 0, 0, 0, 0, 0, 0]
Rank 2 before first all2all, input_tensor: [2, 2, 2, 2, 2, 2, 2, 2, 2, 2]
Rank 0 after first all2all, output_splits: [1, 1, 1, 1]
Rank 1 after first all2all, output_splits: [2, 2, 2, 2]
Rank 3 after first all2all, output_splits: [4, 4, 4, 4]
Rank 2 after first all2all, output_splits: [3, 3, 3, 3]
Rank 3 after first all2all, output_tensor: [0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3]
Rank 0 after first all2all, output_tensor: [0, 1, 2, 3]
Rank 1 after first all2all, output_tensor: [0, 0, 1, 1, 2, 2, 3, 3]
Rank 2 after first all2all, output_tensor: [0, 0, 0, 1, 1, 1, 2, 2, 2, 3, 3, 3]
```

### 3 专家并行分片示例

参考DeepSeek的PEFT相关工作： [ESFT/train\_ep.py at main · deepseek-ai/ESFT](https://github.com/deepseek-ai/ESFT/blob/main/train_ep.py)

并行组划分：

```python
def init_parallel_groups(ep_size=1):
    dist.init_process_group("nccl")
    world_size = int(os.getenv("WORLD_SIZE", "0"))
    local_rank = int(os.getenv("LOCAL_RANK", "0"))
    torch.cuda.set_device(local_rank)
    ep_group = edp_group = None
    for i in range(0, world_size, ep_size):
        ranks = list(range(i, i + ep_size))
        group = dist.new_group(ranks)
        if local_rank in ranks:
            ep_group = group
    edp_group = None
    for i in range(ep_size):
        ranks = list(range(i, world_size, ep_size))
        group = dist.new_group(ranks)
        if local_rank in ranks:
            edp_group = group
    dist.all_reduce(torch.zeros(1, device="cuda"), group=ep_group)
    dist.all_reduce(torch.zeros(1, device="cuda"), group=edp_group)
    return world_size, local_rank, ep_group, edp_group
```

1. **`world_size`**：全局 GPU 总数（所有节点）
2. **`local_rank`**：当前 GPU 在节点内的本地编号（0\~N-1）
3. `ep_group` ：专家并行组（Expert Parallelism Group）
4. **`edp_group`**：专家数据并行组（Expert Data Parallelism Group）

**通信组划分逻辑**

假设有 8 个 GPU（world\_size=8），ep\_size=2（每个专家组包含 2 个 GPU）：

* **专家并行组（ep\_group）划分**

  ```python
  for i in range(0, world_size, ep_size):
      ranks = list(range(i, i + ep_size))
  ```

  * **组0**：GPU \[0, 1] → 共同处理专家A
  * **组1**：GPU \[2, 3] → 共同处理专家B
  * **组2**：GPU \[4, 5] → 共同处理专家C
  * **组3**：GPU \[6, 7] → 共同处理专家D
* **专家数据并行组（edp\_group）划分**

  ```python
  for i in range(ep_size):
      ranks = list(range(i, world_size, ep_size))
  ```

  * **组0**：GPU \[0, 2, 4, 6] → 专家A的不同数据分片
  * **组1**：GPU \[1, 3, 5, 7] → 专家B的不同数据分片
* 通信验证

  ```python
  dist.all_reduce(torch.zeros(1), group=ep_group)
  dist.all_reduce(torch.zeros(1), group=edp_group)
  ```

  * 测试两个通信组是否正常工作
  * 确保所有 GPU 都能在各自组内通信

### 4 发展

| **时间** | **研究团队**      | **技术名称**            | **主要改进点**               | **适用场景**      | **参考文献**                                       |
| ------ | ------------- | ------------------- | ----------------------- | ------------- | ---------------------------------------------- |
| 2021年  | Google        | Switch Transformers | 更高效的并行方式                | Google的TPU    | [2101.03961](https://arxiv.org/pdf/2101.03961) |
| 2021年  | 清华大学          | FastMoE             | 适用于GPU和PyTorch的实现       | GPU和PyTorch环境 | [2103.13262](https://arxiv.org/pdf/2103.13262) |
| 2022年  | 微软            | Tutel               | 优化了All2All通信性能          | 通信性能优化场景      | [2206.03382](https://arxiv.org/pdf/2206.03382) |
| 2022年  | 斯坦福大学、微软和谷歌联合 | MegaBlocks          | 解决1个GPU上多个专家时负载不均衡导致的问题 | 单GPU多专家场景     | [2211.15841](https://arxiv.org/pdf/2211.15841) |

### 参考

1. <https://blog.csdn.net/xx_nm98/article/details/142422761>
2. [17. 使用Alltoall通讯 — python-parallel-programming-cookbook-cn 1.0 文档](https://python-parallel-programmning-cookbook.readthedocs.io/zh-cn/latest/chapter3/17_Collective_communication_using_Alltoall.html)
3. [2006.16668](https://arxiv.org/pdf/2006.16668)
4. [DeepSeek R1专家并行-腾讯云开发者社区-腾讯云](https://cloud.tencent.com/developer/article/2499657)


# 多模态大模型


# 多模态大模型基础

* **为什么需要多模态？** 从单模态瓶颈到跨模态理解
* **核心挑战**：模态鸿沟、对齐（Alignment）、融合（Fusion）
* **任务全景**：图文检索、VQA、Captioning、Grounding、OCR、视频理解


# 核心组件


# 视觉编码器

* **视觉编码器**：CLIP ViT → SigLIP → EVA-CLIP，各有什么优劣


# ViT

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fs4CYwkabFo764weluWcn%2Fimage.png?alt=media&amp;token=1b482a89-bbe9-4f37-9b64-d98b3de45122" alt=""><figcaption></figcaption></figure>

### 参考

1. <https://blog.csdn.net/weixin_40264313/article/details/159998470>


# 模态连接器

* 线性投影（Linear Projection）— LLaVA 方案
* **Q-Former / Perceiver Resampler** — BLIP-2 / Flamingo 方案 ⭐（你现有 QFormer 可放这里）
* MLP 适配层 — 其他变体


# Qformer

传统的视觉-语言预训练（VLP）成本极高，因为需要端到端训练视觉和文本模型。BLIP-2 提出了一种通用且高效的预训练策略，利用现成的冻结预训练图像编码器和冻结大语言模型（LLM），只训练一个轻量级的"桥梁"模块来连接两者，即Qformer（Querying Transformer）。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FjZIGe3v8LOFefGQQnXC0%2Fimage.png?alt=media&amp;token=31f7bcfe-44fd-43f8-a23c-8822036c82f4" alt=""><figcaption></figcaption></figure>

Qformer是一个轻量级Transformer，作为冻结图像模型和冻结LLM之间的信息瓶颈：

* 使用32个可学习的查询向量（Queries）从冻结的图像编码器中提取视觉特征
* 采用"瓶颈"设计（32×768维），远小于原始图像特征（如257×1024维），强制提取与语言最相关的视觉信息
* 包含图像Transformer（与冻结编码器交互）和文本Transformer（处理文本）

### 1 Qformer架构

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2Fft2DmUKWJG7giEYPXuUN%2Fimage.png?alt=media&amp;token=a6bcac0d-0805-4f8c-83f6-caa91fd400fe" alt=""><figcaption></figcaption></figure>

Q-Former模块可以实例化为可学习的查询嵌入集合 $$\mathbf{Q}\in\mathbb{R}^{m\times d}$$，其中 $$m$$ 为查询数量，$$d$$ 为模型维度。每个Q-Former块由以下顺序层组成：

* **多头自注意力**（作用于查询，用于查询间上下文关联）
* **多头交叉注意力**（从查询指向主干网络特征，即ViT、语言词元）
* **前馈网络**（MLP）
* **层归一化和残差连接**（每个核心操作后）

过程如下：&#x20;

$$
\begin{align\*} \mathbf{Q}^1 &= \mathbf{Q}^0 + \mathrm{MSA}(\mathrm{LN}(\mathbf{Q}^0)) \ \mathbf{Q}^2 &= \mathbf{Q}^1 + \mathrm{CrossAttn}(\mathrm{LN}(\mathbf{Q}^1),\mathbf{E}) \ \mathbf{Z} &= \mathbf{Q}^2 + \mathrm{FFN}(\mathrm{LN}(\mathbf{Q}^2)) \end{align\*}
$$

### 2 两阶段训练

Q-Former并非直接接入LLM，而是通过**渐进式训练**避免灾难性遗忘：

**阶段一：表征学习（Bootstrapping Vision-Language Representation）**

* 仅训练Q-Former，冻结视觉编码器（ViT-G/14等）
* 使用图文对数据集（COCO, Visual Genome等）
* 学习视觉-文本对齐的**紧凑表征**（32个查询向量）

Q-Former在阶段一同时优化三个互补任务：

| 目标      | 全称                              | 作用        | 关键细节                                      |
| ------- | ------------------------------- | --------- | ----------------------------------------- |
| **ITC** | Image-Text Contrastive Learning | 对齐视觉和文本表征 | 计算查询向量与文本\[CLS] token的相似度，使用MoCo机制维护动量编码器 |
| **ITM** | Image-Text Matching             | 细粒度对齐     | 二分类任务，查询向量通过Bi-Attention与文本交互，判断图文是否匹配    |
| **ITG** | Image-Grounded Text Generation  | 生成能力      | 因果LM目标，查询向量作为视觉前缀，自回归生成文本（仅阶段二使用）         |

**阶段二：生成学习（Bootstrapping Vision-to-Language Generative Learning）**

* 将Q-Former连接到**冻结的LLM**（OPT, Flan-T5等）
* 添加全连接层将Q-Former输出投影到LLM的嵌入维度
* 训练目标变为：让LLM基于Q-Former提取的视觉特征生成文本描述

### 参考

1. <https://www.emergentmind.com/articles/transformer-based-adapters-q-former>
2. [\[2301.12597\] BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models](https://arxiv.org/abs/2301.12597)

<br>


# 视觉分词器

**视觉分词器（Vision Tokenizer）** — VQ-VAE、SEED、LlamaGen 的离散化思路


# 工程实现


# WebDataset

## 1 顺序 I/O

训练多模态大模型时，数据集往往包含数百万到数十亿个小文件（图片、文本、点云等）。数据量大并不是问题，训练文本语言模型的时候我们也经历过tb甚至pb级别的数据量，实际的瓶颈是**访问次数太多。**

我们首先需要复习一下计算机组织原理，关于存储设备的物理原理。存储设备一般有机械硬盘（HDD）、固态硬盘（SSD）、网络存储（S3/GCS/OSS）。

### 1 计算机存储体系

#### 1.1 HDD

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FgsoFGYBDpD898U6Z0rqL%2FChatGPT%20Image%202026%E5%B9%B45%E6%9C%8813%E6%97%A5%2019_08_02.png?alt=media&amp;token=8aad45d4-da48-453b-a2dd-76b9b5efda28" alt=""><figcaption></figcaption></figure>

机械硬盘（HDD）可以想象成一台**唱片机，**&#x6570;据存储在磁盘的同心圆轨道（磁道）上。每个轨道被划分为若干个扇区（通常 512B 或 4KB）。磁头负责数据的读写，悬浮在盘片上方，需要物理移动到目标轨道。

读取一个文件需要三个步骤：

1. 寻道 (Seek)：磁头从当前轨道移动到目标轨道，平均耗时约 10ms
2. 旋转延迟 (Rotational Latency)：等待盘片旋转到目标扇区正好经过磁头下方，平均耗时约 4ms
3. 数据传输 (Transfer)：磁头读取经过下方的数据，顺序读约 150-200 MB/s

其中步骤1和步骤2是固定开销，与读多少数据无关。

但是假设我们需要读 100 万个小文件，每张 50KB，存储方式的不同对性能的影响很大。

如果是随机 I/O：

* 每个文件：seek(10ms) + rotate(4ms) + transfer(50KB / 150MB/s ≈ 0.3ms) = 14.3ms；
* 总时间：1,000,000 × 14.3ms = 14,300 秒 ≈ 4 小时；
* 实际带宽：50GB / 14,300s ≈ 3.5 MB/s

如果是顺序 I/O：

* 定位一次：seek(10ms) + rotate(4ms) = 14ms
* 连续读取：50GB / 150MB/s = 333 秒
* 总时间：333 秒 ≈ 5.5 分钟
* 实际带宽：≈ 150 MB/s

#### 1.2 SSD

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FA42yf6zWf4fWUPxLhcnJ%2FChatGPT%20Image%202026%E5%B9%B45%E6%9C%8813%E6%97%A5%2019_37_33.png?alt=media&amp;token=478d0f2d-957d-4664-8654-c2959e036fd2" alt=""><figcaption></figcaption></figure>

SSD（Solid State Drive，固态硬盘）数据存储在 NAND 闪存芯片上，通过纯电信号访问。要修改一个 Page 中的数据，必须先擦除整个 Block（包含几百个 Page），再重新写入。SSD 比 HDD 快，核心原因有两个：

1. **无机械运动**：读任何位置的数据都是电信号寻址，不需要等磁头移动或盘片旋转
2. **多通道并行**：控制器同时从 4-8 个闪存芯片读取数据，类似 RAID 0 的效果

但是SSD仍然惧怕海量的小文件，虽然没有机械寻址的过程，但是瓶颈从硬件转移到了软件层。

每次处理一个小文件，需要有文件系统开销、NVMe 协议开销，同时随机 I/O 会导致Page Cache 效率下降。Linux 的 Page Cache 是以 4KB 页为单位缓存文件数据的。100 万个小文件（每个 50KB）= 约 1250 万个 4KB 页。Page Cache 的查找是 O(1) 的（基于 radix tree），但每个文件的 Cache 是独立管理的，100 万个文件 = 100 万次独立的 Cache 查找/管理。

#### 1.3 网络存储

网络存储读取一个小文件的完整流程：

1. DNS解析
2. TCP 三次握手
3. TLS 握手
4. 发送 HTTP GET 请求
5. 服务端处理（鉴权、查找对象）
6. 传输数据
7. TCP 连接关闭

单个文件造成的延迟会被百万级的数据量放大。

总而言之，无论哪种存储介质，**顺序 I/O 都显著优于随机 I/O**。&#x20;

tar 打包的本质就是：**把小文件合并成大文件，把随机访问模式强制转换为顺序访问模式。**

### 2 tar 如何实现顺序 I/O

tar 做的事情很简单：在训练前把这海量小文件首尾相接，写成一个连续的大文件。

tar（Tape Archive）最初设计用于磁带备份，而磁带是**纯顺序设备**—— 只能从头到尾读，不能跳转。这个历史原因决定了 tar 的内部结构：

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FQEX92SM6zvvOqPVBNEfw%2Fnano_task_37f912c7ca6c4bb29ed85c84f59c1236.png?alt=media&amp;token=e2d97345-b527-4f27-ac6a-dfd1c22435b5" alt=""><figcaption></figcaption></figure>

每个文件由两部分组成：

* **Header**（512 字节）：文件名、大小、权限、时间戳等元数据
* **Data**：文件内容，填充到 512 字节的整数倍

关键特点：

* **没有中央目录/索引**（与 zip 不同）。找到第 N 个文件的唯一方式是从头读到第 N 个
* 这正好适合流式读取——从头到尾扫一遍，遇到什么处理什么
* 512 字节对齐是因为磁带和早期硬盘的最小读写单位就是 512 字节（一个扇区）

#### 2.1 流式读取的实现细节

在 Python 中，这对应 `tarfile.open(fileobj=stream, mode="r|*")` 的流式模式：

```python
tarfile.open(fileobj=stream, mode="r|*")
```

本地文件可以进行`seek` 操作，因为任意位置都可以读，但是像 HTTP 相应流、S3 流式下载、子进程的 stdout 管道是不行的。

`r:*` 代表随机访问模式：

tar 文件本身没有中央目录（与 zip 不同），但 Python 的 `tarfile` 在 `r:*` 模式下会**预先把整个 tar 扫一遍**，把每个文件的位置（offset）记到内存里建成索引。之后就可以按名字直接跳转：

```python
tar = tarfile.open("a.tar", "r:*")
tar.getmember("xxx.jpg")    # 按名字查找 → 内部 seek 到那个位置
tar.extractfile("xxx.jpg")  # 跳过去读 → 内部又 seek 一次
```

这要求底层文件对象**必须支持 seek**。HTTP 流不支持 seek，所以这种模式根本没法用在网络流上。

`r|*` 代表流式模式：

```python
tar = tarfile.open(fileobj=stream, mode="r|*")
for member in tar:                         # 顺序遍历
    data = tar.extractfile(member).read()  # 当前条目立刻读
```

tarfile 内部只会调用 `read()` ，不调用`seek()` 。

但是天下没有免费的午餐：

流式模式使得webdataset可以从网络流直接读，不用先把整个 tar 下载到本地，也不需要预先建索引，内存占用低。但是只能从头到尾遍历一次，对象用完即弃，没法通过名字查找。

#### 2.2 处理内存泄露

`tar.members` 是 `tarfile` 对象内部维护的一个 **Python 列表**，记录"目前为止见过的所有文件条目"。每次 `for member in tar` 迭代一步，tarfile 都会把当前的 TarInfo 对象追加到这个列表里：

```python
tar = tarfile.open(fileobj=stream, mode="r|*")
for member in tar:
    # tarfile 内部相当于做了：
    #     self.members.append(member)
    process(member)
```

TarInfo 是一个小对象，存的是文件名、大小、权限、修改时间这些元数据，本身不大（几百字节）。但条目数量乘上去就可观了。

这个本来是给随机访问模式 `r:*` 设计的，因此流式模式 `r|*` 下我们不会用这份清单，所以每次 yield 之后会手动 `tar.members = []` 把列表重置为空。

## 2 Group by keys

tar 内部的文件以共享前缀的方式组织同一个样本：

```
000042.jpg
000042.txt
000042.json
```

需要将它们聚合成一个样本字典：

```python
{"__key__": "000042", "jpg": <bytes>, "txt": <bytes>, "json": <bytes>}
```

但是如果从多个 shard 串联读取时，shard A 的最后一个样本和 shard B 的第一个样本 可能具有相同前缀（例如都叫 `000000`）。如果没有隔离机制，它们会被错误地合并。

WebDataset用了 EOF 哨兵机制，`tar_file_expander` 在每个 shard 的文件读完后发射 `{}`（空字典）：

```python
for sample in tar_file_iterator(source["stream"]):
    yield sample
yield {}  # EOF 哨兵
```

`group_by_keys` 检测到哨兵后强制刷新：

```python
if filesample == {}:           # shard 边界
    if valid_sample(current_sample):
        yield current_sample
    current_sample = None      # 重置为 None，而不是 {}
    continue
```

重置为 `None`（而不是 `{}`）确保下一个文件会创建全新的样本字典。

## 3 惰性生成器链

#### 3.1 三层柯里化系统

WebDataset的api如下：

```
dataset = (
    wds.WebDataset("shard_{000..999}.tar")
    .shuffle(1000)              # ← 传入配置，返回 DataPipeline
    .decode("rgb")              # ← 传入配置，返回 DataPipeline
    .to_tuple("jpg;png", "json")# ← 传入配置，返回 DataPipeline
)

for batch in dataset:
    ...
```

每个方法（`shuffle`、`decode`、`to_tuple`）都是**配置阶段，**&#x5373;都是惰性生成器。**在从最外层迭代器拉取数据之前，不会执行任何操作。**&#x771F;正的计算延迟到 `for batch in dataset` 时才开始。这要求每个方法返回一个**新的 Pipeline 对象**，并且携带一个「待执行的函数」（柯里化）。

整个 pipeline 的内存占用 ≈ 一个 shuffle 缓冲区 + 当前 batch，与数据集大小无关。 这使得在有限内存的机器上处理 TB 级数据集成为可能。

Python 里实现柯里化有很多方式（闭包、lambda、`functools.partial`），WebDataset 搞了三个类，用于同时解决另一个问题：**多进程序列化**。

WebDataset的三层柯里化系统：

| 层级  | 类/装饰器            | 职责      | 解决什么问题                                                         |
| --- | ---------------- | ------- | -------------------------------------------------------------- |
| 第一层 | `FilterFunction` | 可序列化的闭包 | `multiprocessing` 的 `spawn` 模式需要 pickle 传递函数，普通 lambda/闭包无法序列化 |
| 第二层 | `RestCurried`    | 工厂      | 接收配置参数（如 `1000`），生产 `FilterFunction`                           |
| 第三层 | `pipelinefilter` | 装饰器     | 把原始函数包装成 `RestCurried`，并保留 `__name__`、`__doc__`                |

第一层：**`FilterFunction` —— 可序列化的 stage**

```
class FilterFunction:
    def __init__(self, f, *args, **kw):
        self.f = f          # 原始函数，如 _shuffle
        self.args = args    # 配置参数，如 (1000,)
        self.kw = kw

    def __call__(self, data):
        return self.f(data, *self.args, **self.kw)   # 数据注入
```

Python 的 `pickle` 可以序列化类实例（只要类在顶层定义），但不能序列化内层闭包。这让它能通过 `multiprocessing` 在进程间传递。

**第二层：`RestCurried` —— 工厂**

```
class RestCurried: def init(self, f): self.f = f
    def __call__(self, *args, **kw):
        return FilterFunction(self.f, *args, **kw)
```

`RestCurried.__call__`返回一个配置好的 `FilterFunction`。

**第三层：`pipelinefilter` —— 入口装饰器**

```
def pipelinefilter(fn):
    result = RestCurried(fn)
    functools.update_wrapper(result, fn)   # 让 result 拥有 fn 的名字和文档
    return result
```

使用：

```
@pipelinefilter
def _shuffle(data, bufsize):
    ...

shuffle = _shuffle   # 现在 shuffle 是一个 RestCurried 对象
stage = shuffle(1000)   # 返回 FilterFunction，等待 data
```

理论上可以写一个「万能类」同时干三件事，但那样会混淆**配置阶段**和**执行阶段**的语义。WebDataset 拆三层是为了**状态隔离**：

```
# 如果只有一个类，对象在不同时刻会处于两种矛盾状态：
class ConfusedStage:
    def __init__(self, f, *args):
        self.f = f
        self.args = args      # 有时这是配置参数
        # 但有时 args 里又要包含 data？语义混乱
    
    def __call__(self, *args):
        # 这里要判断：我现在是被用户调用（配置），还是被 pipeline 调用（执行）？
        pass
```

而三层结构让**每个对象只有一种职责、一种状态**：

* `RestCurried` 实例永远只等**配置参数**，永远不会被传入 `data`
* `FilterFunction` 实例已经被配好了参数，永远只等**数据流**

这种**不可变性**避免了运行时判断「我现在处于哪个阶段」的混乱。

#### 3.2 Pipeline 如何串联

`DataPipeline` 内部维护一个 `pipeline` 列表，存着所有 stage：

```
[self.source, shuffle_stage, decode_stage, to_tuple_stage]
```

`iterator1()` 用**左折叠**把它们串起来：

```
def iterator1(self):
    source = self.invoke(self.pipeline[0])   # 第一个 stage 是数据源，无输入
    for step in self.pipeline[1:]:
        source = self.invoke(step, source)   # 每个 stage 包一层：step(上游迭代器)
    return source
```

#### 3.3 无限流上的虚拟 epoch

有些数据源是**无限流**，例如 `ResampledShards`（有放回地无限重复采样 shard）：

训练需要「每个 epoch 固定 N 个样本」。`with_epoch(nsamples)` 的实现：

```
def with_epoch(self, nsamples=-1):
    self.repetitions = sys.maxsize   # 无限重复
    self.nsamples = nsamples
    return self
```

运行时，pipeline 反复调用 `iterator1()` 产生迭代器，用 `islice` 截断到 `nsamples`：

```
iterator = self.iterator1()
yield from itertools.islice(iterator, self.nsamples)   # 精确产出 N 条
```

这样无限流被切成固定长度的 epoch，配合 `repetitions` 实现多 epoch 训练。

## 4 两级 Shuffle

顺序读取 tar 意味着数据天然有序。但是训练通常需要随机性，我们又不能全量 shuffle，因为数据太大，不能完整放进内存中。

WebDataset 的方案结合两个层级：

1. **Shard 级 shuffle**：打乱 shard 文件的读取顺序（宏观随机性）
2. **Buffer shuffle**：在固定大小的缓冲区内随机交换（微观随机性）

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FS1uPlK7EGcDPP4BpWO1s%2Fnano_task_493a2d8e49774d26abee140ba768c561.png?alt=media&amp;token=67209ce9-86a5-4c0d-b6f0-b40ebc591fc5" alt=""><figcaption></figcaption></figure>

#### 4.1 实现细节

**Shard 级 Shuffle**

一个shard就是一个tar文件，

`SimpleShardList.__iter__` 拷贝 URL 列表后用带种子的 RNG 打乱：

```python
def __iter__(self):
    urls = self.urls.copy()
    if self.seed is not None:
        random.Random(self.seed).shuffle(urls)
    for url in urls:
        yield dict(url=url)
```

但是这样遇到一个问题：固定seed会导致每个epoch的shuffle顺序一摸一样，缺少多样性

```
# 假设 seed=42，有 4 个 shard
Epoch 0: seed=42 → [shard-3, shard-1, shard-0, shard-2]
Epoch 1: seed=42 → [shard-3, shard-1, shard-0, shard-2]  # 一模一样！
Epoch 2: seed=42 → [shard-3, shard-1, shard-0, shard-2]
```

但是也不希望它完全随机，那样实验不可复现。

`detshuffle` 变体让种子 = `base_seed + epoch`，每个 epoch 不同但完全可复现。

```
# 你只需给一个 base_seed=42
shuffler = detshuffle(urls, base_seed=42)

Epoch 0: seed = 42 + 0 = 42 → [shard-3, shard-1, shard-0, shard-2]
Epoch 1: seed = 42 + 1 = 43 → [shard-0, shard-3, shard-2, shard-1]
Epoch 2: seed = 42 + 2 = 44 → [shard-1, shard-0, shard-3, shard-2]
```

好处如下：

1. 每个 epoch 顺序不同，保证训练多样性
2. 给定 (base\_seed, epoch) 就能精确复现

**Buffer 级 Shuffle**

Shard 级 shuffle 只解决了"哪个 shard 先被读到"的问题。但在单个 shard 内部，样本仍然是**严格顺序**的。如果直接按顺序输出，模型会在短时间内连续看到同一个 shard 的同类样本（例如同一个视频的所有帧、同一个网页的所有图文对），造成严重的**局部相关性**。

Buffer shuffle 的任务是：在**固定内存**（O(bufsize)）的限制下，打散样本的流出顺序，实现跨 shard 的微观混合。

可以把 Buffer理解成一个滑动窗口：

* Buffer 大小固定为 `bufsize`，不会随着数据量增长。
* 每次从 Buffer 中**随机挑选**一个样本输出，而不是输出最早进入的那个。
* Buffer 从上游按顺序接收样本，保持与上游的耦合关系。

这里带来一个问题，Buffer 的"随机输出"操作需要高效，因为要执行 n 次。

我们能想到的最朴素的方法需要 O(n) 时间，因为 pop(k) 需要移动 k 之后的所有元素，示例代码如下：

```python
k = rng.randint(0, len(buf) - 1)
return buf.pop(k)
```

而 WebDataset使用了一个经典的**交换-删除**技巧，将时间复杂度降为 O(1)：

```
def pick(buf, rng):
    k = rng.randint(0, len(buf) - 1)
    # 将选中的第 k 个元素与最后一个元素交换
    buf[k], buf[-1] = buf[-1], buf[k]
    # 从末尾 pop，O(1)，因为不涉及中间元素的移动
    return buf.pop()
```

**Double-Dipping**

Buffer Shuffle 的完整生命周期分为三个阶段：

1. 预热 （**Warm-up**）

   ```
   for sample in data:
       buf.append(sample)
       if len(buf) >= initial:
           break
   ```

   在积累到 `initial` 个样本（默认 100）之前，**不输出任何样本**。这是为了保证第一个输出的样本是从至少 `initial` 个候选中随机选出的。如果没有预热，第一个样本进入 Buffer 后就会被立即输出（此时 Buffer 只有 1 个元素，"随机"毫无意义），前几十个样本的随机性极差，相当于**伪顺序读取**。
2. 稳态循环 （**Steady State**）

   ```
   for sample in data:
       buf.append(sample)                    # 1. 新样本入 Buffer
       try:
           buf.append(next(data))            # 2. Double-Dipping：额外多拉一个
       except StopIteration:
           pass
       if len(buf) >= initial:
           yield pick(buf, rng)              # 3. 随机输出一个
   ```

   `for sample in data` 本身会消费 1 个样本，额外的 `next(data)` 再消费 1 个。这意味着 Buffer 的**填充速度是输出速度的 2 倍**。为什么需要 Double-Dipping？假设 shard 很大（每个 shard 有 10000 个样本），如果不加速填充，Buffer 会长期处于"半空"状态，导致同一 shard 的样本在 Buffer 中停留时间过长，**跨 shard 混合不充分**。Double-Dipping 让 Buffer 更快达到满容量，增强相邻 shard 的样本共存概率。
3. 排空 （Drain）

   上游耗尽后，Buffer 中剩余样本被逐个随机抽出，直到清空。这保证了**最后几个样本也是随机的**，不会出现"末尾样本顺序输出"的偏差。

   ```
   while len(buf) > 0:
       yield pick(buf, rng)
   ```

## 5 Decoder 链条

一个样本字典包含多种文件类型：`.jpg`、`.txt`、`.json`、`.pcd.npz` 等， 每种需要不同的解码方式。WebDataset 使用责任链模式： handler 列表按顺序尝试，第一个返回非 None 的结果胜出。

这具有良好的可扩展性：添加新 handler 就能支持新文件类型，无需修改现有代码。

每个 handler 具有统一接口：

```python
def handler(key: str, data: bytes) -> Any | None
```

* `key`：带前导点的文件后缀（如 `.jpg`、`.pcd.npz`）
* `data`：原始字节
* 返回 `None` 表示传递给下一个 handler（"我不处理这种类型"）
* 返回任意非 None 值表示认领（"这是解码结果"）

外层循环（最多 10 次迭代）处理链式 Continue 返回 （如 `.json.gz.enc` → 解密 → 解压 → 解析）。 `for/else` 结构：`else` 子句仅在内层循环完成且没有 `break` 时执行 （即没有返回 Continue）。

<figure><img src="https://1868529161-files.gitbook.io/~/files/v0/b/gitbook-x-prod.appspot.com/o/spaces%2FClEIZCEkrqcbimvIAlPu%2Fuploads%2FwwbAjafxh2btMoN7ceYW%2F612ed12e7d7a44ce9d4b6807140817bd.png?alt=media&amp;token=b16227a3-d6c2-468a-b12c-0ae1b6fe2af4" alt=""><figcaption></figcaption></figure>

## 6 分布式分片

多节点多 worker 训练时，每个 (node, worker) 组合必须读取互不重叠的 shard 子集。 WebDataset 的方案极其简洁：用 `itertools.islice(src, offset, None, stride)` 做等间隔抽取。

```python
def split_by_node(src, group=None):
    rank, world_size, worker, num_workers = pytorch_worker_info(group)
    if world_size > 1:
        yield from islice(src, rank, None, world_size)
    else:
        yield from src

def split_by_worker(src):
    rank, world_size, worker, num_workers = pytorch_worker_info()
    if num_workers > 1:
        yield from islice(src, worker, None, num_workers)
    else:
        yield from src
```

例如，假设我们有 4 节点 × 2 worker，800 个 shard。

```
所有 shard: [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, ...]

split_by_node 之后 (stride=4):
  Node 0: [0, 4, 8, 12, ...]   (200 个 shard)
  Node 1: [1, 5, 9, 13, ...]   (200 个 shard)
  Node 2: [2, 6, 10, 14, ...]  (200 个 shard)
  Node 3: [3, 7, 11, 15, ...]  (200 个 shard)

在 Node 0 上再 split_by_worker (stride=2):
  Worker 0: [0, 8, 16, ...]    (100 个 shard)
  Worker 1: [4, 12, 20, ...]   (100 个 shard)
```

总计：8 路并行读取，每路 100 个独占 shard。

## 7 ShardWriter 自动分片写入

将海量样本打包成 tar shard 时，需要自动按大小/数量切分：

* 太大：下载慢，部分读取时浪费空间
* 太小：文件数太多，文件系统开销大
* 需要一致的命名规范，便于 brace expansion 展开

自动分片有两个触发条件：

```python
if self.count >= self.maxcount or self.size >= self.maxsize:
    self.next_stream()
```

* `maxcount=100000` 每个 shard 最多样本数（默认）
* `maxsize=3e9` 每个 shard 最大字节数（约 3GB，默认）

Tar 内文件命名：

```
{sample["__key__"]}.{field_name}
```

字段按**字母序排列**写入（`sorted(obj.keys())`）：

```
000001.cls
000001.jpg
000001.json
000001.txt
```

以 `_` 开头的 key 是元数据，默认跳过（除非 `keep_meta=True`）。

Shard 命名使用 Python `%` 格式化：`pattern % shard_index`

```python
"dataset-%06d.tar" % 0   → "dataset-000000.tar"
"dataset-%06d.tar" % 1   → "dataset-000001.tar"
```

这与 brace expansion 无缝集成：`"dataset-{000000..000099}.tar"` 展开为全部 100 个 shard。

文件按后缀自动序列化：

| 后缀                 | 编码方式                            |
| ------------------ | ------------------------------- |
| `cls`、`index`、`id` | `str(x).encode("ascii")`        |
| `txt`、`text`       | `x.encode("utf-8")`             |
| `json`、`jsn`       | `json.dumps(x).encode("utf-8")` |
| `pth`              | `torch.save` 到 BytesIO          |
| `npy`              | `numpy.lib.format.write_array`  |
| `npz`              | `np.savez_compressed`           |
| `jpg`、`jpeg`       | PIL Image → JPEG quality 100    |
| `png`              | PIL Image → PNG                 |
| `pkl`、`pickle`     | `pickle.dumps`                  |
| `mp`、`msgpack`     | `msgpack.packb`                 |
| bytes/bytearray    | 直接写入                            |

## 8 ResampleShared 有放回采样

假设有 **100 个数据分片（shard）**，要分给 **8 个 Worker** 并行读取：

```
100 ÷ 8 = 12 余 4
```

这意味着：

* 4 个 Worker 拿到 **13 个 shard**
* 4 个 Worker 拿到 **12 个 shard （有闲置状态）**

如果 Worker 数量很大（比如 64 个），余数带来的不均匀会更严重。一些 Worker 会提前空闲，导致 GPU 利用率低。

```python
def __iter__(self):
    self.epoch += 1
    seed = make_seed(self.worker_seed(), self.epoch, self.seed)
    rng = random.Random(seed)
    for _ in range(self.nshards):
        yield {"url": rng.choice(self.urls)}
```

`ResampledShards` 让**每个 Worker 独立从全量池子里有放回地抽 N 次**。

* 每个 Worker **恰好有 N 个 shard** 可读 → **绝对均衡**
* 同一个 shard 可能被同一个 Worker 抽到多次 → 没关系，重复读总好过空闲

与 `SimpleSharedList` 对比：

|            | SimpleShardList      | ResampledShards          |
| ---------- | -------------------- | ------------------------ |
| 采样方式       | 无放回                  | 有放回                      |
| Epoch 长度   | 恰好 len(urls) 个 shard | 可配置（nshards）             |
| 跨 epoch 重叠 | 无（每个 shard 恰好看一次）    | 可能（同一 shard 出现在多个 epoch） |
| Worker 均衡  | 可能不均匀                | 始终均匀                     |
| 可复现性       | 有 seed 时确定性          | 可配置                      |
| 适用场景       | 中小规模数据集              | 大规模分布式训练                 |

## 9 FileCache

#### 9.1 为什么需要缓存？

如果训练数据存在**亚马逊 S3**（或阿里云 OSS）上，每次读取一个 shard 是这样的流程：

```
Worker → 网络请求 → S3 服务器 → 下载 500MB tar 包 → 解压读取
```

**痛点**：

* **慢**：网络下载速度慢
* **重复**：训练有 10 个 epoch，同一个 shard 会被下载 **10 次**
* **费钱**：每次下载都走公网流量，云厂商按流量计费

**FileCache 的思路**：第一次从远程下载后，把 shard **存到本地硬盘**。之后直接从本地读，速度从 \~100MB/s 提升到 **\~2GB/s**（SSD 本地读取），提升 **10\~20 倍**。

#### 9.2 整体架构

```python
# 没有缓存：每次 epoch 都重新从 S3 下载
DataPipeline(
    ShardList(urls),           # 列出所有 shard URL
    url_opener,                # 从远程打开流
    tarfile_to_samples(),      # 解压 tar
    ...
)

# 有缓存：第一次下载到本地，之后直接从本地读
DataPipeline(
    ShardList(urls),
    FileCache("./cache", max_size=100e9),  # ← 插入缓存层
    tarfile_to_samples(),
    ...
)
```

`FileCache` 对外伪装成 `url_opener`：输入是 URL，输出是 `{url, stream, local_path}`。但内部会先检查本地有没有，没有就去远程下载。

#### 9.3 设计细节

**URL 怎么映射到本地路径？**

**问题**：远程 URL 很长，比如 `s3://my-bucket/dataset/train/shard-001.tar`，怎么存到本地？

**方案**：提取 URL 中的"路径部分"，支持保留若干层父目录。

```python
def url_to_cache_name(url, ndir=0):
    # 解析 URL，拿到路径部分
    path = parsed.path.lstrip("/")           # "dataset/train/shard-001.tar"
    segments = path.split("/")               # ["dataset", "train", "shard-001.tar"]
    
    # 只取最后 ndir+1 段
    return "/".join(segments[-1 - ndir:])   # ndir=0 → "shard-001.tar"
                                              # ndir=1 → "train/shard-001.tar"
```

| `ndir` 参数            | 缓存路径                        | 用途                     |
| -------------------- | --------------------------- | ---------------------- |
| `0`（默认）              | `cache/shard-001.tar`       | 扁平结构，简单                |
| `1`                  | `cache/train/shard-001.tar` | 保留一层目录，防止不同文件夹下的同名文件冲突 |
| 特殊 URL（如 `pipe:` 开头） | URL 编码后取最后 128 字符           | 处理非标准协议                |

**为什么保留目录层级？**&#x20;

防止 `train/shard-001.tar` 和 `val/shard-001.tar` 在扁平缓存中互相覆盖。

**如何防止下了一半的文件污染缓存**

**问题**：如果下载到一半进程崩溃了，缓存目录里会留一个残缺的文件。下次训练读到这个半成品，会直接报错。

**方案**：先写到临时文件，下载完成后再"原子移动"。

```python
# 临时文件名包含进程 ID，防止多进程冲突
tmp = dest + f".temp{os.getpid()}"   # 例如：shard-001.tar.temp1234

# 1. 下载到临时文件
download_fn(url, tmp)

# 2. 原子重命名：这个操作要么成功（文件完整到位），要么失败（什么都没发生）
os.rename(tmp, dest)                  # tmp → shard-001.tar
```

`os.rename()` 在同一文件系统内是**原子操作**。即使进程在 `download_fn` 中途被 `kill -9`，也只会留下一个 `.temp1234` 垃圾文件，不会破坏正式的缓存。

**如何做Tar 格式完整性校验**

**问题**：网络不稳定时，下载可能"正常结束"但文件内容被截断或损坏。如果不校验直接进缓存，后续每次读都会报错。

**方案**：下载后检查文件头的前 512 字节。

```python
with open(dest, "rb") as f:
    header = f.read(512)

# 检查是否是合法的 tar 或 gzip 文件
is_gzip = header[0:2] == b"\x1f\x8b"           # gzip 魔数
is_tar  = header[257:262] == b"ustar\x00"     # POSIX tar 签名

if not (is_gzip or is_tar):
    os.remove(dest)                              # 删除损坏文件
    raise ValueError(f"下载的文件格式异常: {url}")
```

tar 文件的格式签名就在头部，不需要读完整个文件就能判断基本合法性。快速且有效。

**LRU 淘汰：缓存目录满了怎么办？**

**问题**：本地磁盘不是无限的。假设你设置了 100GB 缓存，但数据集有 1TB，迟早会满。

**方案**：按"最久未使用"淘汰，每次下载新文件前清理空间。

```python
def _evict(self):
    # 扫描缓存目录，拿到每个文件的（创建时间，大小，路径）
    files = [(os.stat(f).st_ctime, os.stat(f).st_size, f) for f in cache_dir]
    
    # 按创建时间排序：最旧的排在最前面
    files.sort()
    
    # 一直删，直到总大小低于限制
    while total_size > self.max_size:
        oldest = files.pop(0)
        os.remove(oldest.path)
        total_size -= oldest.size
```

**设计细节**：

* 用 `st_ctime`（创建时间）近似"最后使用时间"——文件刚下载/创建时这个时间最新
* **在下载新文件之前清理**，而不是下载之后。防止下载到一半发现磁盘满了
* **频率限制**：每 30 秒最多执行一次淘汰，避免频繁扫描目录

## 参考

1. <https://zhuanlan.zhihu.com/p/412772439>


# LLM Infra


# K8s

![Image](https://content.gitbook.com/content/ClEIZCEkrqcbimvIAlPu/blobs/0uVo2F6bY1vo3L5Sqgkz/authcode)

## 0 阅读路径

| 阶段   | 你会做什么                        | 核心对象                                |
| ---- | ---------------------------- | ----------------------------------- |
| 理解概念 | 知道 K8s 为什么存在，以及它和 Docker 的边界 | Cluster、Node、Pod、Deployment、Service |
| 启动环境 | 启动本地集群，配置 kubectl 和命名空间      | Context、Namespace                   |
| 部署应用 | 创建 Deployment，扩容，观察自愈和滚动更新   | Deployment、ReplicaSet、Pod           |
| 访问应用 | 给 Pod 提供稳定入口，理解 Service 类型   | Service、Endpoint、Ingress            |
| 接近生产 | 补配置、密钥、健康检查、资源限制和自动扩缩容       | ConfigMap、Secret、Probe、HPA          |

***

## 1 概念

**K8s 是 Kubernetes 的简称**。Kubernetes 这个单词中间有 8 个字母，所以写成 `K + 8 + s`。日常沟通里可以直接读 Kubernetes，也常读作 K-eights。

它是一个用来**管理容器化应用的平台**。如果你的应用已经被打包成 Docker 镜像，K8s 可以帮你部署、调度、扩容、重启、滚动发布，并把流量转发到健康的副本上。

**Docker 负责什么**

* 把应用和依赖打包成镜像
* 在单机上启动容器
* 提供容器运行时能力

**K8s 负责什么**

* 把大量容器调度到不同节点
* 维持副本数和健康状态
* 管理发布、回滚、配置、网络和扩缩容

生产环境里，一个后端服务通常不只是 `docker run my-api`。你还需要多个副本、失败自动重建、流量分发、配置管理、密钥管理、发布回滚和资源限制。K8s 的核心价值，就是把这些运维动作声明成资源对象，由控制器持续维护。

| 概念             | 含义                           | 一句话理解                        |
| -------------- | ---------------------------- | ---------------------------- |
| **Cluster**    | 一个 Kubernetes 集群，由控制面和工作节点组成 | 整套 K8s 系统                    |
| **Node**       | 集群里的机器，可以是虚拟机或物理机            | 真正运行 Pod 的机器                 |
| **Pod**        | K8s 里最小的可部署计算单元，通常包含一个容器     | 容器的运行外壳                      |
| **Deployment** | 声明 Pod 模板、副本数和发布策略           | 管理无状态应用                      |
| **ReplicaSet** | 保证符合 selector 的 Pod 数量       | Deployment 背后的副本控制器          |
| **Service**    | 给一组 Pod 提供稳定访问入口             | Pod 会变，Service 名字和虚拟 IP 相对稳定 |
| **Ingress**    | 管理外部 HTTP/HTTPS 路由           | 把域名和路径路由到 Service            |
| **ConfigMap**  | 存放非敏感配置                      | 配置不要写死进镜像                    |
| **Secret**     | 存放密码、Token、证书等敏感信息           | 敏感值不要明文写进 YAML               |
| **Namespace**  | 隔离同一集群内的资源                   | 练习、测试、生产可以分开管理               |

![Image](https://content.gitbook.com/content/ClEIZCEkrqcbimvIAlPu/blobs/xuRMvx4nmnLwjHwJamSA/authcode)

### 1.1 期望状态和控制循环

Kubernetes 的工作方式不是“执行一条命令然后结束”，而是让你声明一个**期望状态**，再由控制器不断比较实际状态和期望状态，发现偏差就修正。

理解这条控制循环后，Deployment 自动补 Pod、Service 自动找 Pod、HPA 自动改副本数都会变得直观：它们本质上都是控制器在让实际状态追上期望状态。

***

## 2 本地启动

本文推荐用 OrbStack 的内置 Kubernetes 做本地练习。Minikube、kind、Docker Desktop Kubernetes 也可以，命令思路基本一致。

### 2.1 启动集群

```bash
# 第一次启动会拉镜像，可能需要等 1 到 2 分钟
orb start k8s

# 确认 kubectl 当前上下文
kubectl config current-context

# 确认节点状态
kubectl get nodes
```

如果一切正常，你会看到 1 个节点，状态是 `Ready`。

### 2.2 安装和理解 kubectl

`kubectl` 是你和 Kubernetes API Server 交互的命令行工具。常见命令格式是：

```
kubectl <动作> <资源类型> <资源名> [参数]
```

| 命令                                | 作用                |
| --------------------------------- | ----------------- |
| `kubectl get pods`                | 查看 Pod 列表         |
| `kubectl describe pod <pod-name>` | 查看 Pod 详情、事件和调度原因 |
| `kubectl logs <pod-name>`         | 查看容器日志            |
| `kubectl apply -f app.yaml`       | 按 YAML 声明创建或更新资源  |
| `kubectl delete -f app.yaml`      | 删除 YAML 中定义的资源    |

如果提示找不到 `kubectl`，可以安装：

```bash
brew install kubectl
```

### 2.3 创建练习命名空间

```bash
kubectl create namespace lab
kubectl config set-context --current --namespace=lab
```

后续命令默认都作用在 `lab`。这样练习资源和系统命名空间隔离，最后也方便一键清理。

### 2.4 排障顺序

1. 先看资源是否存在：`kubectl get pods,deploy,svc`
2. 再看 Pod 状态和事件：`kubectl describe pod <pod-name>`
3. 然后看当前日志：`kubectl logs <pod-name>`
4. 如果容器反复崩溃，看上一次日志：`kubectl logs <pod-name> --previous`
5. 最后看命名空间事件：`kubectl get events --sort-by=.metadata.creationTimestamp`

***

## 3 部署应用：Deployment、ReplicaSet、Pod、Container

Pod 是 Kubernetes 能创建和管理的最小可部署计算单元，但实际工作里通常不直接手写裸 Pod，而是用 **Deployment** 管理 Pod。Deployment 会创建 ReplicaSet，ReplicaSet 再创建和维持 Pod。

![Image](https://content.gitbook.com/content/ClEIZCEkrqcbimvIAlPu/blobs/7sgLySuxceJPh8NrCqtA/authcode)

### 3.1 用命令创建一个 Deployment

```bash
kubectl create deployment nginx --image=nginx:1.25
```

```bash
kubectl get deployments
kubectl get rs
kubectl get pods
```

你会看到 Pod 名字类似 `nginx-5869d7778c-k2x7p`，而不是单纯的 `nginx`。这说明它不是你直接创建的裸 Pod，而是 ReplicaSet 根据 Deployment 的 Pod 模板创建出来的。

### 3.2 看控制关系

```bash
kubectl describe pod <pod-name>
kubectl describe rs <replicaset-name>
```

在 Pod 详情里通常能看到 `Controlled By: ReplicaSet/...`；在 ReplicaSet 详情里能看到 `Controlled By: Deployment/nginx`。

### 3.3 扩容到 3 个副本

```bash
kubectl scale deployment nginx --replicas=3
kubectl get deployment nginx
kubectl get pods
```

这里你改的是 Deployment 的 `spec.replicas`。Deployment 把期望副本数交给 ReplicaSet，ReplicaSet 发现当前 Pod 不够，就创建新的 Pod。

### 3.4 验证 Pod 自愈

```bash
kubectl delete pod <one-nginx-pod-name>
kubectl get pods -w
```

准确地说，不是旧 Pod 复活了，而是 ReplicaSet 创建了一个新的 Pod 来补齐副本数。Pod 是可替换的，不要把单个 Pod 当成长期稳定实体。

### 3.5 滚动更新和回滚

```bash
# 查看当前镜像
kubectl get deployment nginx -o jsonpath='{.spec.template.spec.containers[0].image}{"\n"}'

# 更新镜像。示例故意使用明确版本，不使用 latest
kubectl set image deployment/nginx nginx=nginx:1.27

# 查看发布状态
kubectl rollout status deployment/nginx

# 查看发布历史
kubectl rollout history deployment/nginx
```

滚动更新时，Deployment 会创建新的 ReplicaSet，逐步增加新版本 Pod，同时逐步减少旧版本 Pod。

```bash
kubectl rollout undo deployment/nginx
kubectl rollout status deployment/nginx
```

### 3.6 更接近实际工作的 YAML 写法

命令式操作适合理解概念，但真实项目更常见的是把资源写成 YAML，然后用 `kubectl apply` 管理。

```yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx
  labels:
    app: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
        - name: nginx
          image: nginx:1.27
          ports:
            - containerPort: 80
```

```bash
kubectl apply -f nginx-deployment.yaml
kubectl get deployment nginx
kubectl get rs
kubectl get pods
```

`selector.matchLabels.app=nginx` 和 Pod 模板里的 `labels.app=nginx` 必须匹配。这里 `app` 是 label key，`nginx` 是 label value。

***

## 4 访问应用：Service 和 Ingress

Pod 会被删除、重建、迁移，IP 也会变化。Service 的作用是给一组 Pod 提供稳定访问入口。它不创建 Pod，而是通过 label selector 找到后端 Pod。

### 4.1 先看 Pod 标签

```bash
kubectl get pods --show-labels
```

你可能会看到类似 `app=nginx,pod-template-hash=xxxxx`。在 `app=nginx` 里，`app` 是 label key，`nginx` 是 label value。Service selector 会用这个标签选择后端 Pod。

### 4.2 用 kubectl expose 创建 Service

```bash
kubectl expose deployment nginx --port=80 --target-port=80 --type=NodePort
kubectl get svc nginx
```

```
NAME    TYPE       CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
nginx   NodePort   10.96.123.45    <none>        80:31234/TCP   20s
```

现在有两个常见访问方式：集群内部可以访问 `nginx:80` 或 `10.96.123.45:80`；集群外部可以通过 `<NodeIP>:31234` 访问。

### 4.3 Service 类型对比

| 类型               | 适用场景               | 说明                                        |
| ---------------- | ------------------ | ----------------------------------------- |
| **ClusterIP**    | 集群内部访问             | 默认类型，只在集群内暴露                              |
| **NodePort**     | 本地练习或临时调试          | 在每个 Node 上开一个端口，默认范围通常是 30000-32767       |
| **LoadBalancer** | 云上对外暴露服务           | 通常由云厂商创建外部负载均衡器                           |
| **Ingress**      | HTTP/HTTPS 域名和路径路由 | 需要额外的 Ingress Controller，例如 nginx-ingress |

### 4.4 Service YAML 写法

```yaml
apiVersion: v1
kind: Service
metadata:
  name: nginx
spec:
  type: NodePort
  selector:
    app: nginx
  ports:
    - name: http
      port: 80
      targetPort: 80
```

```bash
kubectl apply -f nginx-service.yaml
kubectl get svc nginx
kubectl get endpoints nginx
```

如果 Service 能创建但访问不到，优先检查 selector 是否匹配 Pod label。selector 写错时，Service 没有后端 endpoints。

***

## 5 配置、密钥、健康检查和资源限制

能启动应用只是第一步。真实服务还需要把配置和镜像解耦，声明健康检查，并限制资源使用，避免一个容器拖垮节点。

### 5.1 ConfigMap 和 Secret

**ConfigMap**

存放非敏感配置，例如环境名、开关、普通配置文件。

**Secret**

存放密码、Token、证书等敏感信息。默认表现是 base64 编码，不等于加密。

```bash
kubectl create configmap app-config \
  --from-literal=APP_ENV=local \
  --from-literal=LOG_LEVEL=info

kubectl create secret generic app-secret \
  --from-literal=DB_PASSWORD='change-me'
```

```yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-with-config
spec:
  replicas: 1
  selector:
    matchLabels:
      app: nginx-with-config
  template:
    metadata:
      labels:
        app: nginx-with-config
    spec:
      containers:
        - name: nginx
          image: nginx:1.27
          env:
            - name: APP_ENV
              valueFrom:
                configMapKeyRef:
                  name: app-config
                  key: APP_ENV
            - name: DB_PASSWORD
              valueFrom:
                secretKeyRef:
                  name: app-secret
                  key: DB_PASSWORD
```

不要把真实密码、Token、证书直接提交到 Git。生产环境通常会结合云厂商 KMS、External Secrets、Sealed Secrets 或 GitOps 密钥方案。

### 5.2 健康检查：readinessProbe 和 livenessProbe

| 探针                 | 作用             | 失败后会怎样                     |
| ------------------ | -------------- | -------------------------- |
| **readinessProbe** | 判断 Pod 是否可以接流量 | 失败时从 Service endpoints 中摘除 |
| **livenessProbe**  | 判断容器是否还活着      | 失败超过阈值后重启容器                |
| **startupProbe**   | 给慢启动应用更长启动时间   | 启动成功前暂缓其他探针判断              |

```yaml
readinessProbe:
  httpGet:
    path: /
    port: 80
  initialDelaySeconds: 3
  periodSeconds: 5
livenessProbe:
  httpGet:
    path: /
    port: 80
  initialDelaySeconds: 10
  periodSeconds: 10
```

### 5.3 资源请求和限制

`requests` 用于调度：告诉调度器这个容器至少需要多少 CPU 和内存。`limits` 用于限制：告诉运行时这个容器最多能用多少资源。

```yaml
resources:
  requests:
    cpu: "100m"
    memory: "128Mi"
  limits:
    cpu: "500m"
    memory: "256Mi"
```

后面做 HPA 时，CPU 利用率通常基于 `requests.cpu` 计算。没有 requests 的工作负载，很容易出现 HPA 无法判断或指标不稳定的问题。

***

## 6 自动扩缩容：metrics-server 和 HPA

HPA，全称 Horizontal Pod Autoscaler，用来根据 CPU、内存或自定义指标自动调整副本数。它依赖指标来源，本地环境最常见的是 metrics-server。

### 6.1 确认 metrics-server 是否可用

```bash
kubectl top nodes
kubectl top pods
```

如果报错 `metrics not available`，可以安装 metrics-server：

```bash
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml

# 本地集群可能需要跳过 kubelet TLS 校验
kubectl -n kube-system patch deploy metrics-server --type=json \
  -p='[{"op":"add","path":"/spec/template/spec/containers/0/args/-","value":"--kubelet-insecure-tls"}]'

# 等 30 到 60 秒后重试
kubectl top nodes
```

### 6.2 创建 HPA

```bash
kubectl autoscale deployment nginx \
  --cpu-percent=70 \
  --min=1 \
  --max=5

kubectl get hpa
```

这表示：当 nginx Deployment 的平均 CPU 使用率超过目标值 70% 时，HPA 可以把副本数从 1 扩到最多 5。

本地 nginx 静态服务不一定能稳定触发 CPU 扩容。HPA 练习的重点是理解前提：metrics-server 可用、Deployment 设置了 CPU requests、HPA 能读取指标并改写 replicas。

***

## 7 工具链：kubectl、Helm、Terraform 怎么分工

| 工具            | 定位                             | 常见命令                                                   |
| ------------- | ------------------------------ | ------------------------------------------------------ |
| **kubectl**   | 直接操作 Kubernetes 资源             | `kubectl apply`、`kubectl get`、`kubectl describe`       |
| **Helm**      | 把一组 YAML 打包成可安装、可升级、可回滚的 Chart | `helm install`、`helm upgrade`、`helm rollback`          |
| **Terraform** | 管理基础设施，例如 VPC、云集群、节点组、负载均衡器    | `terraform plan`、`terraform apply`、`terraform destroy` |

### 7.1 Helm 最小理解

当应用越来越复杂时，手写和复制多份 YAML 会很难维护。Helm 的 Chart 可以把 Deployment、Service、Ingress、ConfigMap 等资源组织成一个包，再用 `values.yaml` 管理差异。

```bash
helm create my-chart
helm install my-app ./my-chart
helm upgrade my-app ./my-chart --values values.yaml
helm rollback my-app 1
helm uninstall my-app
```

```yaml
replicaCount: 3
image:
  repository: nginx
  tag: "1.27"
service:
  type: ClusterIP
  port: 80
```

### 7.2 Terraform 放在哪里

Terraform 不是 Kubernetes 自带组件，也不是 kubectl 插件。它更适合管理 Kubernetes 之外或更底层的基础设施，例如云服务器、VPC、EKS/ACK/GKE 集群、节点组、IAM、负载均衡器等。

![Image](https://content.gitbook.com/content/ClEIZCEkrqcbimvIAlPu/blobs/9Ro51dTDEwa4uVy1FiLl/authcode)

简单分工：用 Terraform 建“集群和周边基础设施”，用 Helm 或 kubectl 部署“集群里的应用”。不要在入门阶段把两条线混在一起学。

***

## 8 清理练习环境

本文所有练习都放在 `lab` 命名空间里，最简单的清理方式是删除整个命名空间：

```bash
kubectl delete namespace lab
```

如果你不想删除命名空间，也可以逐个删除资源：

```bash
kubectl delete hpa nginx --ignore-not-found
kubectl delete svc nginx --ignore-not-found
kubectl delete deployment nginx nginx-with-config --ignore-not-found
kubectl delete configmap app-config --ignore-not-found
kubectl delete secret app-secret --ignore-not-found
```

***

## 9 参考

1. [Kubernetes Concepts](https://kubernetes.io/docs/concepts/)
2. [Kubernetes Hello Minikube](https://kubernetes.io/docs/tutorials/hello-minikube/)
3. [kubectl Quick Reference](https://kubernetes.io/docs/reference/kubectl/quick-reference/)
4. [Kubernetes Deployment](https://kubernetes.io/docs/concepts/workloads/controllers/deployment/)
5. [Kubernetes Service](https://kubernetes.io/docs/concepts/services-networking/service/)
6. [Kubernetes ConfigMap](https://kubernetes.io/docs/concepts/configuration/configmap/)
7. [Kubernetes Secret](https://kubernetes.io/docs/concepts/configuration/secret/)
8. [Kubernetes Probes](https://kubernetes.io/docs/tasks/configure-pod-container/configure-liveness-readiness-startup-probes/)
9. [Horizontal Pod Autoscaling](https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/)
10. [Helm Quickstart](https://helm.sh/docs/intro/quickstart/)
11. [Terraform Introduction](https://developer.hashicorp.com/terraform/intro)
12. [Kubernetes 入门课程参考](https://guangzhengli.com/courses/kubernetes/pre)


# Kubernetes 自动扩缩容的三种玩法：HPA、VPA 和 KEDA

在今天的系统里，应用和负载几乎都是动态变化、彼此牵连的，想给每个应用都分配到「刚刚好」的资源，其实挺难的。

靠人工去调参数、扩容缩容，不仅慢、效率低，风险还大。

分配得太少，任务跑的很慢，严重的时候应用直接挂掉；可要是为了保险起见一味「多给点」，又会白白浪费钱。

自动扩缩容（Autoscaling）的目标很简单：在对的时间给到对的资源，既不让你资源不够用，也不让你花冤枉钱。

当然，跟大多数技术一样，把自动扩缩容真正用好，中间也有不少坑。

### 1 为什么自动扩缩容这么重要？

所谓自动扩缩容，就是根据实时的需求，动态地把集群资源（比如 CPU、内存）分配给你的应用。这样一来，不管负载高低，应用手里都有合适的资源来应对，性能和可用性自然就上去了。它的好处如下：

* **省钱**：能帮你把基础设施成本压下来。你只为真正用到的那部分弹性资源付费，而不是为了能跑而浪费。
* **省时间**：本来需要人工去手动调整的资源，现在交给自动化就好。在负载变化频繁的环境里，这能帮运维和 SRE 团队省下大量精力。

### 2 自动扩缩容的难点

自动扩缩容在资源优化上确实很强，但它也不是没有代价。下面这几个是大家常遇到的问题：

1. **很难预测该扩多少**：一个应用到底需要多少资源，其实很难说准。扩缩容的决策通常是基于过去的使用规律或者当前指标做出来的，一旦碰上意料之外的流量高峰，或者使用模式突然变了，就容易扩过头或者没扩够。
2. **成本可能失控**：如果放任不管，自动扩缩容反而可能推高基础设施成本。尤其是遇到那种转瞬即逝的短时峰值就猛地扩容，账单会很难看。
3. **资源争抢**：一个集群里如果有很多应用各自独立地扩缩容，它们就会去抢有限的资源，结果就是彼此争抢、整体性能反而下降。
4. **复杂度**：随着微服务和应用越来越多，管理这么多套扩缩容配置和规则会变得越来越复杂，也越来越容易出错。

想把这些问题处理好，需要：合理的策略、自动化、监控，再加上对自己应用和负载真实需求的深入理解。

### 3 前置条件

如果你想在自己的集群里开始尝试这些扩缩容方案，需要先准备好这些东西：

* 对 Kubernetes 有基本了解，包括 Pod、Deployment、Service 以及基础网络。
* 一个正在运行的 Kubernetes 集群。本文我们用的是 minikube。
* 一个配置好、能连上集群的 kubectl。
* 安装好 Helm。
* 安装好 Metrics Server。

### 4 Kubernetes Metrics Server

在 Kubernetes 里，一个「指标」就是一个量化的测量值或数据点，用来反映某个资源（比如 CPU、内存，或者你自定义的应用级指标）的使用情况和运行状态。指标可以用来评估 Pod、节点、容器这些对象的性能和健康程度。

常见的指标比如：

* 某个容器或 Pod 消耗的 CPU 占比（CPU 使用率）
* 某个容器或 Pod 占用的内存量（内存使用率）
* 某个 Pod 的网络数据传输速率（网络吞吐量）

有了这些指标，你才能在扩缩容和资源分配上做出靠谱的判断，保证性能，也方便排查问题。

Metrics Server（也叫 Kubernetes Metrics API）是集群里的一个组件，负责收集和存储这些指标，同时提供查询和访问的接口，让你能监控整个集群以及上面各种负载的性能和资源使用情况。

对于 HPA（水平扩缩容）、VPA（垂直扩缩容）乃至整个自动扩缩容体系来说，Metrics Server 都非常关键——因为扩缩容依赖的是 CPU、内存这些实时的资源使用数据，靠它们才能做出合理的扩缩决策。

换句话说，没有 Metrics Server，集群就拿不到高效扩缩容所需要的那些关键指标，一切都无从谈起。

#### 5 在集群里安装 Metrics Server

对大多数通用集群来说，直接用 Kubernetes GitHub 仓库里官方的部署清单就行：

```bash
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml
```

稍等片刻让 Metrics Server 启动起来，然后可以这样查看它的状态：

```bash
kubectl get deployment metrics-server -n kube-system
```

之后你就能用 `kubectl top` 命令查看 Pod 的 CPU、内存使用情况，或者查看各节点的资源占用：

```bash
kubectl top pods
kubectl top nodes
```

### 6 HPA、VPA、KEDA 三者对比

Kubernetes 里主要有三种自动扩缩容方案可以选。

其中 HPA（水平 Pod 扩缩容）和 VPA（垂直 Pod 扩缩容）是最常用的两种。

而 [KEDA（Kubernetes 事件驱动扩缩容）](https://keda.sh/docs/2.12/concepts/)最近热度很高。

|                | **HPA（水平 Pod 扩缩容）**                  | **VPA（垂直 Pod 扩缩容）**                     | **KEDA（事件驱动扩缩容）**                |
| -------------- | ------------------------------------ | --------------------------------------- | -------------------------------- |
| **扩缩方向**       | 水平方向（调整 Pod 副本数）                     | 垂直方向（调整 Pod 的资源请求和上限）                   | 水平和/或垂直（取决于事件源）                  |
| **触发条件**       | 基于资源使用指标（CPU、内存、自定义指标）               | 基于资源使用指标（CPU、内存）                        | 由外部或内部事件驱动                       |
| **适用场景**       | 适合应对应用负载或流量模式的变化                     | 优化 Pod 内部的资源利用，减少过度分配                   | 适合由事件触发、负载起伏不定的应用（如消息队列、HTTP 请求） |
| **复杂度**        | 相对简单，容易上手配置                          | 需要对资源需求有一定理解，得慢慢调                       | 灵活性高，但配置和事件源接入会更繁琐一些             |
| **适用负载**       | 更适合无状态应用和负载                          | 各类负载都适用，重点是优化资源利用                       | 无状态、有状态负载都能覆盖，通用性强               |
| **对应的 K8s 资源** | 支持 Deployment、ReplicaSet、StatefulSet | 支持 Deployment、StatefulSet、DaemonSet、Job | 支持多种负载类型，常与 HPA 或 VPA 配合使用       |
| **依赖的工具/组件**   | 依赖 Metrics Server 和 K8s 内置的扩缩容机制     | 需要集成 VPA 组件                             | 需要 KEDA 控制器和事件源                  |

### 6.1 水平 Pod 扩缩容（HPA）

#### HPA 是什么？

HPA（Horizontal Pod Autoscaling）会根据 CPU 使用率或自定义指标等条件，自动调整 Deployment、ReplicaSet 或 StatefulSet 里 Pod 副本的数量。水平扩缩容是 Kubernetes 里最基础的一种扩缩容模式。

HPA 会设定两个参数：目标使用率，以及允许的副本数下限和上限。当某个 Pod 的使用率超过目标值时，HPA 会自动增加副本数量来分担增长的负载；反过来，当使用率掉到目标值以下，HPA 又会减少副本数量，把资源省下来。

#### 什么时候用 HPA

当你主要关心的是「根据应用负载和资源使用情况来调整 Pod 副本数」时，就该用 HPA：

* **按负载伸缩**：如果你希望根据进来的流量或负载高低，自动把副本数扩上去或缩下来，HPA 很合适。
* **流量驱动的伸缩**：如果你的应用负载主要是被流量牵着走的，HPA 能帮你自动调整副本数量，把性能维持在理想状态。
* **控制资源使用率**：如果你想保证 Pod 的 CPU 或内存使用率始终维持在某个阈值范围内，HPA 也很适合。

### 6.2 垂直 Pod 扩缩容（VPA）

#### VPA 是什么？

VPA（Vertical Pod Autoscaling）会根据历史使用规律，调整 Pod 内各个容器的资源请求（requests）和上限（limits），从而优化资源分配。这样一来，Pod 不需要人工介入也能拿到合适的资源量。

VPA 也会设定两个参数：目标使用率，以及每个 Pod 允许分配资源的下限和上限。当某个 Pod 的使用率超过目标值，VPA 会自动给它增加资源；使用率降下来了，VPA 又会把资源减回去。通过这种方式，VPA 能快速、高效地上下调整单个 Pod 用到的资源。

#### 什么时候用 VPA

当你关心的是「怎么把单个 Pod 内部的资源利用做得更高效、性能更好」时，就该用 VPA：

* **微调资源 requests 和 limits**：如果你希望根据容器实际观测到的使用情况，自动调整它们的资源请求和上限，VPA 很有用。
* **提高资源利用效率**：VPA 在防止 Pod 内部资源「分配过头」或「利用不足」这类场景下尤其有价值。
* **优化资源分配**：如果你想把 Pod 里的 CPU 和内存用到极致，VPA 能通过动态调整资源配置帮你实现。

### 6.3 Kubernetes 事件驱动扩缩容（KEDA）

KEDA 全称是「Kubernetes-based Event-Driven Autoscaling」（基于 Kubernetes 的事件驱动扩缩容），是一个开源项目，专门为 Kubernetes 上的容器负载提供事件驱动的扩缩容能力。[大家对 KEDA 的热情](https://www.reddit.com/r/kubernetes/comments/16xxb8h/making_autoscaling_dead_simple_in_kubernetes_keda/)是有道理的：它在 Kubernetes 原生水平扩缩容能力的基础上做了扩展，让应用能够根据来自各种源头的事件（比如消息队列、事件总线、自定义指标）自动伸缩。这样一来，构建和运维那些需要灵活应对负载波动的事件驱动型应用就变得容易多了。

这里说的「事件」，指的是那些标志着「需要根据负载需求来伸缩应用」的外部或内部信号。在 KEDA 里，常见的事件包括定时任务（Cron Job）、消息队列、HTTP 请求等等。

要注意，KEDA 里的「事件」不要和可观测性（observability）里的「事件」搞混。两者的关键区别在于：KEDA 事件是用来触发扩缩容动作的，而可观测性事件则是用来提供洞察和数据、帮你监控和理解应用行为的。虽然名字里都有「事件」，但侧重点和用途完全不同——KEDA 事件关注的是应用运行时的伸缩管理，可观测性事件关注的则是系统性能和可靠性的监控与改进。

#### 什么时候用 KEDA

当你想基于「事件」这种模式来扩缩容，而不只是依赖常规的资源指标时，就该用 KEDA：

* **事件驱动的伸缩**：KEDA 就是为这种场景设计的——根据消息队列里的消息、HTTP 请求，或其他自定义事件源来伸缩你的应用。
* **超越资源指标的伸缩**：如果你的扩缩容决策取决于外部系统或服务产生的事件，KEDA 能帮你把自动扩缩容和这些事件对接起来。
* **云原生的事件模式**：对于那些采用事件驱动架构、需要根据各种来源的事件做出伸缩反应的云原生应用，KEDA 非常合适。

### 7 小结

扩缩容的终极目标，说到底就是把资源用得高效、用得均衡，同时把成本管好。

HPA 让你能根据 CPU、内存等观测指标，自动伸缩 Deployment 或 ReplicaSet 里的 Pod。

VPA 则根据容器观测到的资源使用规律，去调整 Pod 内容器的资源 requests 和 limits。

KEDA 关注的是基于「事件」（也就是触发器）来伸缩应用。

想把自动扩缩容真正做好，离不开细致的监控、指标调优和反复测试，这样才能保证应用既能扛住负载变化，又能保持稳定。

### 8 参考

1. <https://www.spectrocloud.com/blog/kubernetes-autoscaling-patterns-hpa-vpa-and-keda>


# AI for data infra

**AI for Data Infra 让** agent 可以直接运行在数据平台内部（pipeline、catalog、data quality、governance、incident），由 agent 来完成过去团队手动处理的工作。它取代的是那些聊天式的玩具产品，转而构建真正用于生产环境的 agent 集群，底层依托 Claude Code、MCP 以及现代 lakehouse 架构。

这篇文章讲的是如何搭建一套能安全落地生产的 AI-for-data-infra 技术栈。

### 1 什么是 AI for Data Infra？

它是一门构建 agent 的技术，这些 agent 负责管理数据平台本身：pipeline、warehouse、catalog、质量检查、成本控制、迁移以及故障响应。它与聊天式的 BI 机器人有本质区别，因为这些 agent 有自主行动能力——它们会提 PR、执行 migration、呼叫值班人员、部署等等。

能做成这件事，有几个前提：

1. LLM 在代码生成上已然非常可靠。
2. MCP 统一了 agent 访问数据系统的方式。
3. Claude Code 及类似的 coding agent 为平台提供了一个能跨会话记住项目的持久 runtime

三者结合，让 data infra agent 不仅成为可能，更能真正部署上线。

### 2 为什么早期聊天式的数据 agent 失败了

2023到2024年，各个公司陆续推出了第一代 data agent，大部分是 Text2SQL、自然语言 BI 等的 demo。但是无一例外，它们的演示价值大于实际使用价值。我们深入它们的架构，就能看到失败模式其实早有预兆：它们把 warehouse 当成一个扁平的 schema，直接把原始表名喂给 LLM，指望它们能猜出背后的业务含义。结果就是它们猜不出来。

**有三个致命弱点：**

1. **Context 短板**：agent 对业务如何使用数据毫无长期记忆。
2. **隐性知识短板**：一些和查询规则相关的知识（例如该排除哪个 user\_id、哪一列营收是扣除退款后的净额、哪个日期字段才是权威来源）都藏在聊天讨论和工程师的脑子里，没有被文档化。
3. **权威表短板**：大多数 warehouse 里有三张以上营收表，到底该用哪张取决于问题本身。

还有若干个虽不致命但也很麻烦的弱点：

1. 会话之间没有持久的项目记忆
2. 扁平的 schema prompt，忽略了 metric 定义和业务逻辑
3. 无法访问 lineage、ownership，也接触不到 catalog 的语义层
4. Text-to-SQL 是在 Spider 这类 benchmark 上评估的，而非在脏乱的真实 warehouse 上
5. 没有写入权限——agent 只能建议，永远无法真正落地修复

LLM 并非不擅长数据，而是数据工作高度依赖 context，而第一代的玩具 agent 没有在 context 上下功夫。第二代——也就是我们所说的 AI for data infra——从 context 层出发，再向外扩展。

### 3 面向数据的四层 AI 工程体系

一套用于生产的 AI-for-data-infra 技术栈包含四层，缺任何一层 agent 都会崩。这四层自下而上依次是：项目记忆（CLAUDE.md）、skills、执行 hooks、编排 agents。

| 层级        | 产物                     | 用途               | 示例                                          |
| --------- | ---------------------- | ---------------- | ------------------------------------------- |
| 1. Memory | CLAUDE.md              | 跨会话的持久项目 context | Warehouse DSN、权威表、负责人                       |
| 2. Skills | /.claude/skills/\*.md  | agent 可调用的可复用手册  | run-dbt、backfill-dim、on-call-triage         |
| 3. Hooks  | settings.json 里的 hooks | 护栏与自动化           | 未经审批禁止写生产、保存时跑测试                            |
| 4. Agents | Subagent + MCP 工具      | 带工具的自主执行         | pipeline agent、catalog agent、incident agent |

CLAUDE.md 用持久的项目记忆取代了一次性 prompt。模型在每次会话开始时都会读它，所以你不必每次对话都重新解释一遍你的 warehouse。CLAUDE.md 文件最好在 500 到 2000 行之间，类似一份给新员工的入职文档：规范、表、SLA、谁负责什么。

Skills 是第二层。一个 skill 就是一个 Markdown 文件，说明如何完成一项重复性任务，例如跑一次 dbt build、backfill 一张 dimension、triage 一次故障、轮换一个凭证。agent 按名称调用 skill，这意味着不论是人还是 agent 在操作，同一份手册都会以相同方式执行。这也是产出可复现的原因。

Hooks 是第三层，因为它把策略变成了代码。一个 hook 是注册在 settings.json 里的小脚本，会在 agent 动作之前或之后运行：没有 PR 就禁止写生产、每次保存都跑 dbt 测试、agent 一碰 PII 表就往 Slack 发消息。有了 hooks 兜底，你就可以放心把生产任务交给 agent。

Agents 是最顶层。每个 agent 都是一个 Claude Code subagent，拥有一套受限的工具集：pipeline agent 有 dbt、Airflow 和 git；catalog agent 有 OpenMetadata 和 DataHub；cost agent 有 Snowflake 查询历史和 Databricks 账单。agent 之间通过 MCP 相互调用来协同，因此一次 pipeline 故障会触发 incident agent，后者会呼叫 owner 并开出工单——中间无需人工介入。

### 4 Context Engineering

面向 data infra 的 context engineering需要涵盖 4 个方面：

* **Code plane**——repo 文件、dbt 模型、Airflow DAG、Terraform
* **Data plane**——schema、样本行、lineage 图、metric 定义
* **Runbook plane**——incident 历史、SLA、on-call 轮换、升级路径
* **History plane**——决策日志、过往 migration 记录、review 意见
* **Human plane**——Slack 对话、设计文档、PRD 存档

子 agent 会自动构建这套 context 栈——catalog agent 爬取元数据，observability agent 构建 lineage，insights agent 为决策历史建立索引，一切都通过 MCP 工具对外呈现。

### 5 Multi-agent

单个 agent 在规模化时必然崩溃。真正能在生产中跑通的替代方案，是一个 multi agent 的"技术部门"：由多个各司其职的 subagent 组成，再由一个 planning agent 来统一协调。这种模式模仿的是真实的工程组织：Architect 思考这次变更，Builder 去实现它，Reviewer 去检查它，Release agent 负责上线。

数据工作中的三个核心角色是 **Architect**、**Builder** 和 **Reviewer**。

* Architect agent 规划变更（新增一列、一张表、一条 pipeline）并撰写技术 spec
* Builder agent 实现该 spec——提一个包含 dbt 模型、测试、文档和 catalog 条目的 PR。
* Reviewer agent 运行测试、检查 lineage 影响、标记 SLA 风险，然后要么批准、要么打回要求修改。只有当 Reviewer 升级上报时，人类才会介入。

| Subagent  | 负责    | 工具                              | 产出         |
| --------- | ----- | ------------------------------- | ---------- |
| Architect | 规划与设计 | catalog、lineage、决策日志            | 技术 spec 文档 |
| Builder   | 实现    | repo、dbt、git、MCP writer         | 带测试的 PR    |
| Reviewer  | 质量关卡  | test runner、lineage diff、SLA 检查 | 批准或要求修改    |
| Release   | 生产部署  | CI/CD、rollback、监控               | 部署或回滚      |

综上，可以有14 个 agent：pipeline、incident、catalog、schema、quality、governance、cost、migration、insights、observability、streaming、orchestration、connectors、usage-intelligence。每一个都可以根据任务扮演 Architect、Builder 或 Reviewer 的角色。

### 6 MCP

MCP 是让 agent 调用数据系统的接口。在 MCP 之前，每个 agent 针对每个系统都有自己的 connector，意味着每接一个新 warehouse 就要写一个新集成。有了 MCP 之后，一个 warehouse 只需暴露一个 MCP server，所有会说 MCP 的 agent 都能用它。

对于 AI for data infra，MCP 统一了三件事：tool catalog（agent 能做什么）、resource catalog（agent 能看到什么数据）、以及授权模型（这个 agent 被允许碰什么）。没有 MCP，你只能在 agent 流程内部用各种 API 实现；有了 MCP，你得到的是一套可移植、可审计的工具集。

* **Tools**——可执行的操作（跑 query、开 PR、触发 dbt）
* **Resources**——可读取的 context（schema、文档、lineage、metric）
* **Prompts**——server 提供给 agent 的可复用模板
* **Sampling**——由 server 发起的 LLM 调用，用于多步工作流
* **Authorization**——OAuth 2.1 + tier 分级设卡（community、pro、enterprise）

### 7 Claude Code 作为编排引擎

Claude Code 是让上述一切在实践中跑起来的 runtime。它是一个 terminal 原生的 agent，可运行在工程师的笔记本或 CI 里，会读取 CLAUDE.md、加载 skills、执行 hooks、编排 subagent。它之所以成为 AI for data infra 的默认 runtime，关键在于持久性——会话可恢复、记忆能留存，昨天上线一次变更的那个 agent，今天照样能上线新的变更。

### 8 与 Snowflake、Databricks 和 dbt 的集成

对 AI for data infra 来说，最要紧的三个系统是 Snowflake、Databricks 和 dbt。正确的做法是每个系统配一个 MCP server，让 agent 框架充当 client。

| 系统         | MCP server     | Agent 能力                          | 护栏                    |
| ---------- | -------------- | --------------------------------- | --------------------- |
| Snowflake  | snowflake-mcp  | query、schema、cost、RBAC            | 行级访问、成本预算、masking     |
| Databricks | databricks-mcp | SQL warehouse、Unity Catalog、job   | 集群预算、Unity ACL、PII 扫描 |
| dbt        | dbt-mcp        | 模型、测试、文档、lineage                  | CI 强制执行、生产分支保护        |
| BigQuery   | bq-mcp         | query、INFORMATION\_SCHEMA、billing | slot 预算、dataset ACL   |
| Iceberg    | iceberg-mcp    | 表、snapshot、compaction             | 分支保护、snapshot 保留      |

### 9 Human-in-the-Loop

AI for data infra 的效率提升故事并不是 10x。对于 agent 能自主完成的工作，它更接近 3x 到 5x；而对于它做不了的工作，则是 0x——所以真正的杠杆在于分清这两类工作，并让人集中在后者。insights agent 是大多数团队会忽略的一环：它盯着其他 agent 在做什么，把需要人工 review 的决策标记出来，让团队知识不断累积。

Human-in-the-loop 有四种模式：

1. **完全自主**（低风险、可逆的动作，比如更新文档）
2. **部署前 review**（PR）
3. **逐动作审批**（写生产）
4. **有人监督**（人主导、agent 建议）。

一套生产技术栈会同时用上这四种，按任务类别切换模式。要是把所有动作都塞进同一个关卡，agent 要么变得没用，要么变得危险。

### 10 评估

评估 agent 比评估模型更难。模型可以用固定 benchmark 打分；而 agent 面对的是开放式任务，有很多种合理结果。生产中真正管用的有两种方法：**Agent-as-a-Judge**（用第二个 agent 给第一个打分），以及**决策追踪 context graph**（记录 agent 做出的每一个决策，之后可以 replay）。两者都无法取代人，但结合起来，它们抓 regression 的速度比任何测试套件都快。

* **Golden queries**——200 条已知正确的 prompt，附带预期输出
* **Agent-as-a-Judge**——一个打分 agent 审查每一个生产动作
* **Decision trace**——存下每一次 tool call 的输入、输出和理由
* **Replay harness**——用今天的 agent 重跑昨天的 incident
* **人工抽检**——抽取 1% 的 agent 动作做人工复核

### 参考

1. <https://dataworkers.io/resources/ai-for-data-infra/>